
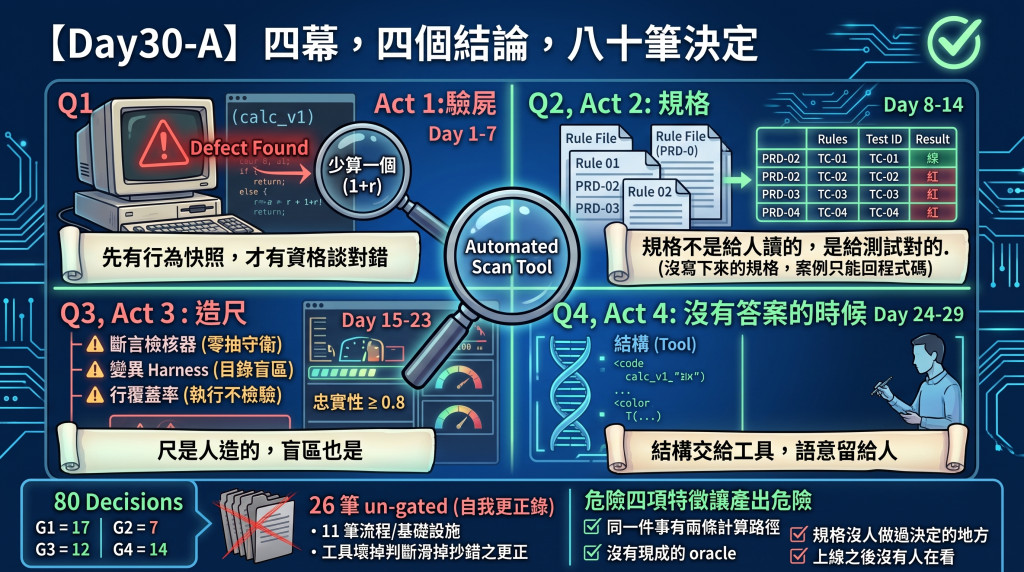
系列從第九天起用五道閘門當骨架:規格層、設計層、門檻層、判讀層、終審層,每一道都是「AI 產出、人驗收」的一個交接點。
這篇不列清單。三十天的細節都在各天,這裡只收每一幕的結論,以及那八十筆決定加起來看到了什麼。
一支 AI 寫的退休試算上線一年,我檢查過,它「沒問題」。解剖出四個缺陷,其中一個(少算一個 (1+r))讓目標金額差了三百零六萬。
這一幕量到的不是 AI 寫錯了什麼,是驗證的成本沒有跟著產出的成本一起降。五百組差分測試全綠,卻給了完美的假象:因為影子模型逐行複製了受測物,兩邊一起錯。七天證明了它「現在就是這樣動」,沒有任何一刻證明它「動得對」。
先有行為快照,才有資格談對錯。
規格考古挖出十個現場——程式碼默默做了十個決定,沒有一個被寫下來。閘門一首度登場,四改六維持,其中一條在查證六個試算器之後改判。然後把規格餵給 AI:畫及格線、跑 RTM、刪一條規格看它會不會偷偷補回來、把邊界寫成關係式。
十三條測試全綠,殺得掉的只有「乘以 −1」。
規格不是給人讀的,是給測試對的。沒寫下來的規格,案例只能回程式碼——而程式碼正是要被驗的東西。
424 條案例分級、斷言檢核器、變異 harness、十四個變異體、第一個變異分數 85.7%、補完之後 100%。然後把同一份規格給兩臺模型各跑五次:規格只給一句話時殺掉零個變異體;給十二條時三份存活集合完全相同。
每一把尺出廠當天都量到自己的盲區。綠燈的門檻是「不拋例外」;覆蓋率量的是執行過,不是檢驗過;變異分數的分母是人設計的目錄,換一份目錄分數就換一個。
尺是人造的,盲區也是。三個數字沒有一個在量「測得對不對」。
先量到 oracle problem 的實證版本:AI 寫測試時,那個期望值的唯一來源是它自己,人核不動。
換個問法——不問答案是多少,只問兩次執行之間該有什麼關係。四條手寫的關係裡,唯一抓到缺陷 A 的是最麻煩的那條。把同一份規格交給 AI 要它寫關係:十份沒有一份寫出那種對帳,十份全部寫了一條在受測實作上永遠不會紅的斷言。人漏掉的兩格,AI 補了一格,靠的是一條防呆測試。另一格活到最後,原因跟前一格一樣:沒有任何一組輸入讓那段邏輯產生過差別。
換成關係之後,人核不動的東西從「數字對不對」變成「這條關係在約束什麼」。結構交給工具,語意留給人。
每一筆閘門決定當天進 decisions.md,一行一筆:日期、閘門、決定、理由。三十天累積八十筆。
| 閘門 | 筆數 |
|---|---|
| 1 規格層 | 17 |
| 2 設計層 | 7 |
| 3 門檻層 | 12 |
| 4 判讀層 | 14 |
| 5 終審層 | 4 |
| 不掛閘門 | 26 |
終審層只有四筆,因為修復還沒發生,下一篇補。
不掛閘門的二十六筆,十一筆是流程與基礎設施(tag 怎麼打、push 怎麼推、草稿留不留),三筆是觀察。剩下十二筆是同一種東西:工具壞掉、判斷滑掉、數字抄錯之後的更正。變異工具第一版在沒跑到任何測試的情況下回報「全部存活」;「殺 0 個」判成「廢話」,讀者指出後撤回,隔一天把正交性判成恆真命題,隔三天把「九份沒殺掉」寫成「毫無增益」;守衛設計錯誤,十個檔案全部「相等」一次都沒響。
這十二筆沒有一筆在講 AI。它們在講量 AI 的人。
不是所有 AI 產出都值得查到這個程度。三十天量出來,四項特徵讓一份產出變得危險:
| 特徵 | 為什麼危險 |
|---|---|
| 同一件事有兩條計算路徑 | 每段各自都對,沒有人要求它們對得起來 |
| 沒有現成的 oracle | 有舊系統可對照就用差分,成本差一個數量級 |
| 規格有沒人做過決定的地方 | AI 會靜靜地替你決定 |
| 上線之後沒有人在看 | 錯了不會爆炸,只會慢慢偏 |
缺一項就砍掉一半工。純介面、CRUD 流程沒有行為快照的價值;規格自己當天寫的不必考古;只有一條計算路徑,對帳無從寫起。
整理決策紀錄的時候,那二十六筆不掛閘門的比什麼都刺眼。
原本以為做到最後會得到一份「AI 會犯哪些錯」的清單。實際得到的是一份「量 AI 的時候我自己壞在哪」的紀錄。
這些數字不能拿來做什麼
完整八十筆在 decisions.md,每筆附理由。
只帶走一件事
三十天問「AI 寫的測試誰來測」,記下來的八十筆決定裡,有十二筆是量的人自己壞掉之後的更正。
結論收完了。剩下的是回去修那支程式——以及看看那個從第二十天活到現在的變異體,會不會死。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day30


 iThome鐵人賽
 看影片追技術