
上一篇,我們談的是排程 Scheduling。
當一天只有有限的時間,而每件工作都有自己的:
我們真正要解決的是:
有限的時間,到底應該怎麼分配?
但現實中的工作通常不只有「什麼時候做」這個問題。
假設今天有很多工作正在等待處理:
同時也有很多可以執行工作的人:
這次問題不再糾結:
哪一件工作先做?
而把重心放在:
哪一件工作,應該交給誰做?
這就是今天要談的 匹配 Matching。
想像現在有三名外送員:
以及三張正在等待的訂單:
最簡單的做法可能是:
Alice → Order A
Bob   → Order B
Carol → Order C
看起來很合理。
但如果我們多知道一些資訊呢?
例如:
Alice 距離 Order A:1 km
Alice 距離 Order B:5 km
Alice 距離 Order C:8 km

Bob 距離 Order A:2 km
Bob 距離 Order B:1 km
Bob 距離 Order C:4 km

Carol 距離 Order A:6 km
Carol 距離 Order B:3 km
Carol 距離 Order C:1 km
這時:
Alice → Order A
Bob   → Order B
Carol → Order C
確實是一個看起來不錯的分配,但問題的本質已經和前面的排程不太一樣了。
排程比較像是在問:
工作應該放在哪一段時間?
匹配問的則是:
左邊的某個對象,應該和右邊的哪個對象建立關係?
這種問題很適合畫成一張 Graph。
左邊放外送員:
右邊放訂單:
如果某個外送員可以處理某張訂單,我們就在兩者之間連一條 edge。
概念上可能像: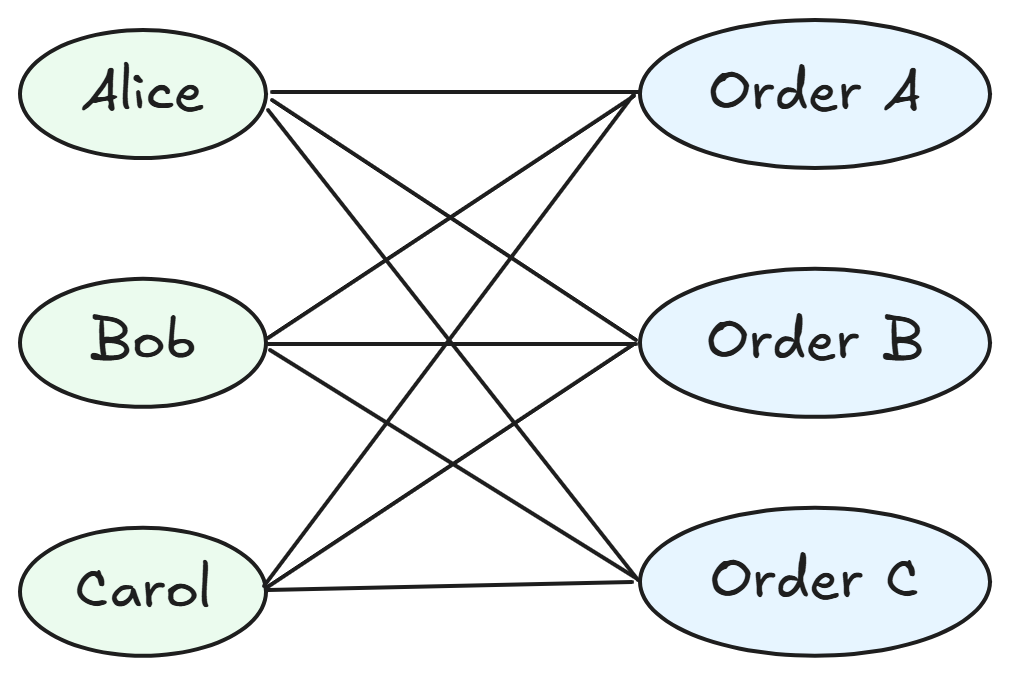
這張 Graph 有一個很明顯的特徵:
node 可以分成兩群,而 edge 只會連接不同群的 node。
例如:
外送員 ←→ 訂單
而不是:
外送員 ←→ 外送員
或者:
訂單 ←→ 訂單
這種 Graph 稱為:
二分圖 Bipartite Graph
Bipartite Graph 的核心其實沒有名字看起來那麼複雜。
我們只是把所有 node 分成兩組:
而 edge 只允許跨越這兩組。
例如:
學生      學校
員工      班次
任務      機器
外送員    訂單
都很容易形成這種結構。
例如學生申請學校:
Alice ── 台大
Alice ── 清大

Bob ──── 清大
Bob ──── 成大
左邊是學生,右邊是學校。
這時我們想做的事情,就是從這些可能的 edge 裡選出一些:
Alice ── 台大
Bob   ── 成大
這個選擇出來的配對集合,就是 匹配 Matching。
假設我們有:
外送員:
A
B

訂單:
1
2
可以形成:
A ── 1
A ── 2

B ── 1
B ── 2
如果最後選:
A ── 1
B ── 2
這是一組匹配。
但如果選:
A ── 1
B ── 1
在最基本的一對一匹配模型裡,就不行。
因為 Order 1 同時被配給兩個外送員了。
同樣地:
A ── 1
A ── 2
也代表同一個外送員同時被配到兩張工作。
所以最基本的匹配要求是:
被選中的 edge 不能共享同一個 endpoint
換句話說,每個 node 最多只能參與一次配對。
當然,真實世界可能更複雜。
例如:
這時模型還會加入:
capacity
schedule
constraint
但匹配提供了一個最基本的視角:
先把「誰可以跟誰配在一起」這件事情建模出來
即使我們找到一組合法的匹配,通常還會有很多其他合法答案。
例如:
Alice → Order A
Bob   → Order B
是一種分配。
但:
Alice → Order B
Bob   → Order A
也可能是一種分配。
兩個答案都符合 一人一單、一單一人 的規則,那要選哪一個?
這時我們又回到了前面幾篇一直出現的問題:
我們到底想最佳化什麼?
假設:
Alice → Order A:1 km
Alice → Order B:7 km

Bob   → Order A:2 km
Bob   → Order B:1 km
如果選:
Alice → Order A
Bob   → Order B
總距離:
1 + 1 = 2 km
但如果選:
Alice → Order B
Bob   → Order A
總距離:
7 + 2 = 9 km
兩組匹配都合法,顯然第一組比較好。
因此 Graph 可以從 Alice ── Order A 變成 Alice ──1km── Order A,也就是:
edge 上開始出現 weight / cost
看到這裡應該已經有一點熟悉了。
Day 12 談 Weighted Graph 時,我們就看過 edge 不只是代表「可以通過」,它還可以帶著:
distance
time
price
cost
到了匹配問題,概念仍然一樣。
只是現在我們不是在找一條 path,而是在選:
哪一組 edge 應該同時成立
匹配問題不一定只有數字成本。
有些問題裡,每一方還有自己的 偏好 preference。
例如學生選學校:
Alice:
1. 台大
2. 清大
3. 成大
而學校可能也有自己的偏好或錄取標準。
或者排班時,員工可能表示:
這時問題就從:
有沒有匹配成功?
還可能額外考量變成:
能不能盡量滿足每個人的偏好?
因此匹配問題可以有很多不同目標:
問題一變,適合的演算法也可能跟著改變。
這點和之前談排程時很像。
匹配 Matching 是一類問題,不是一個固定演算法
例如我們可能想找:
能不能讓最多人都得到配對?
也可能想找:
在所有配對完成的前提下,讓總成本最低
又或者:
雙方都有偏好時,怎麼找到比較穩定的配對?
這些問題會分別導向不同的演算法。
例如你可能會看到:
Maximum Matching
Hungarian Algorithm
Gale-Shapley Algorithm
但這篇不需要急著把它們全部學完。
更重要的是先建立一個新的問題表示:
兩群對象
+
它們之間可能的關係
+
配對條件
+
最佳化目標
於是問題就變成了一張 Graph。
假設工廠裡有:
以及:
但不是每台機器都能執行所有工作。
可能是:
Machine A → Task 1
Machine A → Task 2

Machine B → Task 2
Machine B → Task 3

Machine C → Task 1
Machine C → Task 3
我們可以直接把它畫成 Bipartite Graph: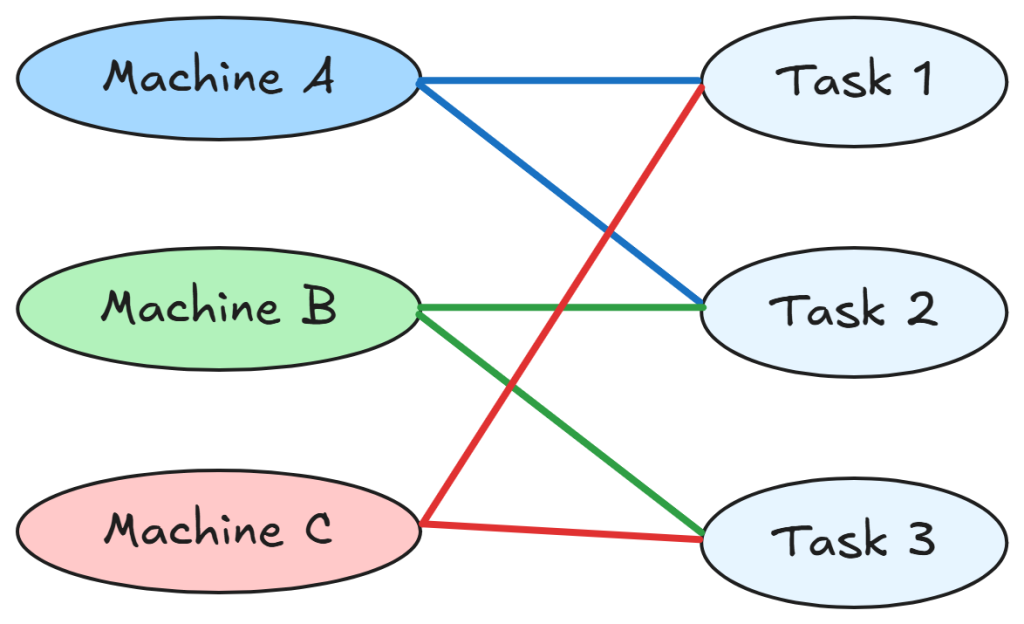
接著再問:
怎麼分配,才能讓最多工作開始執行?
這就是匹配的核心精神。
如果不同機器執行同一個 Task 的速度不同:
Machine A → Task 1:10 分鐘
Machine C → Task 1:25 分鐘
edge 又開始帶上成本,於是我們可能進一步問:
怎麼分配,才能讓總執行時間比較低?
假設今天有:
以及員工:
但不是每個人都有空。
例如:
Alice → 早班
Alice → 午班

Bob → 午班
Bob → 晚班

Carol → 早班
Carol → 晚班
這仍然是一張 Bipartite Graph。
我們要從裡面挑出一些 edge,完成匹配。
但現實中的排班馬上又會加入更多現實約束:
這時就會發現:
匹配考量很少孤立存在
它往往會開始和前一篇的排程問題交織在一起。
可以把兩者先簡單區分成:
例如外送系統裡:
匹配機制先處理:Order A → Alice。
排程機制則可能處理:
Alice:
10:00 Order A
10:30 Order C
11:20 Order F
但真實世界中,這兩件事情通常互相影響。
Alice 能不能接下一張訂單,取決於:
所以 匹配 Matching 與 排程 Scheduling,可能根本沒有辦法完全拆開。
這也是現實系統開始變複雜的地方。
我們在前面幾章談 Graph 時,大部分都在問:
怎麼走?
例如:
後來到了 Dependency Graph,開始問:
誰依賴誰?
現在到了匹配,我們又換了一個問題:
誰應該跟誰配在一起?
Graph 本身沒有改變,改變的是:
我們想從 Graph 上得到什麼答案
所以 Graph 不只用來表示地圖。
它也可以表示:
外送員 ↔ 訂單
學生 ↔ 學校
員工 ↔ 班表
任務 ↔ 機器
而一旦把「可以分配給誰」畫成 edge,我們就可以開始討論:
這就是匹配最重要的概念。
「分配」本身也是 Graph 上的問題
這一章一路走過來,我們看過:
表面上,它們是完全不同的問題。
但背後其實一直共享同一個核心:
資源有限,所以不能什麼都要
面對這些問題,我們都必須先找出限制,再弄清楚想改善的目標,最後才從許多可能的答案中做出選擇。
題目不同,選擇的形狀也不同;但思考的起點始終一樣:
先辨認有限的資源,再問怎麼分配才合理
今天沒有實作 Hungarian Algorithm,也沒有深入 Gale-Shapley Algorithm。
因為真正重要的第一步,仍然和整個系列一樣:
先辨認問題的形狀
當你看到兩群不同的對象,並開始問「誰應該分配給誰」,就可以試著把問題畫成:
Group A ← edge → Group B
也就是 Bipartite Graph,再根據限制與目標,決定哪些 edge 可以一起被選中。
這遠比一開始就背某個 Matching Algorithm 更重要。
到目前為止,我們刻意把不同的問題分開來看:路線歸路線、排程歸排程、配對歸配對。
但現實世界不會按照課本的章節出題。
同一個決策,可能同時受到位置、時間、容量與分配關係影響。這時候,只辨認出其中一種問題形狀,往往還不夠。
下一章,我們會回到外送平台,看看前面分開討論的概念,如何在同一個決策裡一起出現。
而我們要先問的是:
當多種限制同時作用時,我們還能只靠一個演算法做出決定嗎?


 iThome鐵人賽
 看影片追技術