
上一篇,我們把「人與工作之間的分配」畫成了一張 Graph。
例如: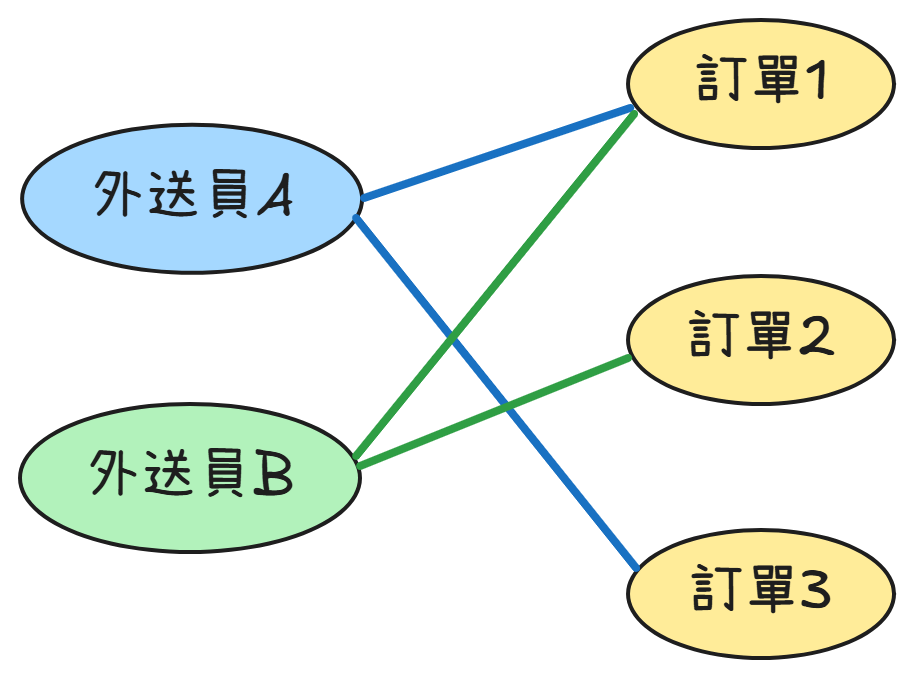
問題變成:
哪一個人應該被分配到哪一件工作?
這就是匹配想處理的問題。
但如果真的打開一個外送平台,事情顯然沒有這麼簡單。
假設你現在點了一份晚餐,附近剛好有三位外送員:
外送員 A:距離餐廳 500 公尺
外送員 B:距離餐廳 1 公里
外送員 C:距離餐廳 1.5 公里
這樣看起來,答案好像非常簡單:
A 最近 → 派給 A
可是如果:
A 手上已經有兩張訂單B 正準備經過這間餐廳C 雖然比較遠,但目前完全沒有任務考量的重心就開始改變了。
可能更麻煩的是:
A 距離餐廳雖然只有 500 公尺,但中間正在塞車B 距離比較遠,卻可以沿著順路的幹道很快抵達這時我們真正要解的,已經不單純是找最近的外送員,還要評估在多個條件下,找一個合理的外送員。
這也是今天真正要談的問題:
真實世界裡,一個問題往往不是一個演算法問題,而是很多問題疊在一起
先從最直覺的部分開始,外送平台必須知道:
但只有位置還不夠。
假設:
外送員 A
直線距離餐廳:800 公尺

外送員 B
直線距離餐廳:1 公里
你不能因此直接認為 A 一定比較快。
因為現實中的道路可能是:
A
│
│ 單行道 ↑
│
└───────────┐
            │
            │
          餐廳
而 B 剛好在另一條可以直接抵達的道路上:
B ───────── 餐廳
所以我們真正關心的不只有:
兩個點在地圖上離多遠?
還要考量:
沿著道路網路走,需要多少成本?
這其實就是前面談過的 Graph。
如果不同道路還有不同的:
那它就是一張有權重的 Graph。
假設現在有三位外送員:
A → 餐廳:8 分鐘B → 餐廳:5 分鐘C → 餐廳:7 分鐘如果我們的目標是:
誰最快抵達餐廳?
那答案很可能是 B。
注意,這裡比較的已經不是 地理距離 而是路徑成本
這就是 Day 12 談過的問題。
當 Graph 的 edge 帶有不同權重時,我們可能需要尋找:
最低成本的路徑
例如:
A → Restaurant = 8
B → Restaurant = 5
C → Restaurant = 7
如果成本代表分鐘數,那 B 的 shortest path 最短。
看起來問題解決了,其實還沒有。
假設目前狀況是:
A
距離餐廳:8 分鐘
目前訂單:0

B
距離餐廳:5 分鐘
目前訂單:2

C
距離餐廳:7 分鐘
目前訂單:1
如果只看最短路徑,B → 5 分鐘 當然應該選 B。
可是 B 手上的工作可能是:
先去餐廳 X
→ 送給顧客 X
→ 再去餐廳 Y
→ 送給顧客 Y
這張新訂單如果再塞給 B,實際上可能要等待很久。
所以外送平台不能只想著:
誰離餐廳最近?
還要去問:
誰有時間處理?
問題開始進入排程概念。
我們可以把每位外送員接下來要做的事情想像成一條時間線。
例如 A:
現在
│
├─ 前往餐廳 X
├─ 取餐
├─ 前往顧客 X
├─ 送達
└─ 空閒
B:
現在
│
├─ 前往餐廳 Y
├─ 取餐
├─ 前往顧客 Y
├─ 前往餐廳 Z
├─ 取餐
├─ 前往顧客 Z
└─ 空閒
這時如果有一張新訂單出現:
餐廳 R → 顧客 R
我們不能只問:
B現在離 R 最近嗎?
還必須知道:
把 R 插入
B的行程之後,其他訂單會不會延遲?
這就是前面排程問題的延伸,每一件工作都有:
新的工作加入時,就可能和既有工作產生衝突。
甚至「送一張訂單」本身,也不是一個單純動作。
至少會包含:
外送員
↓
前往餐廳
↓
等待餐點完成
↓
取餐
↓
前往顧客
↓
送達
所以整張訂單可能需要的時間其實是:
前往餐廳
+
等餐
+
前往顧客
假設:
外送員 A → 餐廳:3 分鐘
餐廳還要等:15 分鐘
餐廳 → 顧客:8 分鐘
整體大約:
3 + 15 + 8
= 26 分鐘
另一位外送員 B:
外送員 B → 餐廳:10 分鐘
餐廳還要等:15 分鐘
餐廳 → 顧客:8 分鐘
看起來 B 比較遠。
但如果 B 本來就有一張訂單要在 8 分鐘後送到同一家餐廳附近,那實際安排可能反而非常合理。
所以平台真正評估的通常不是一個單獨的距離,而是一整段可能的執行結果。
現在假設同一區域同時出現:
外送員:

A
B
C

訂單:

1
2
3
4
平台真正要做的,其實是決定:
A → ?
B → ?
C → ?
這又回到上一篇的匹配問題。
我們可以把它畫成: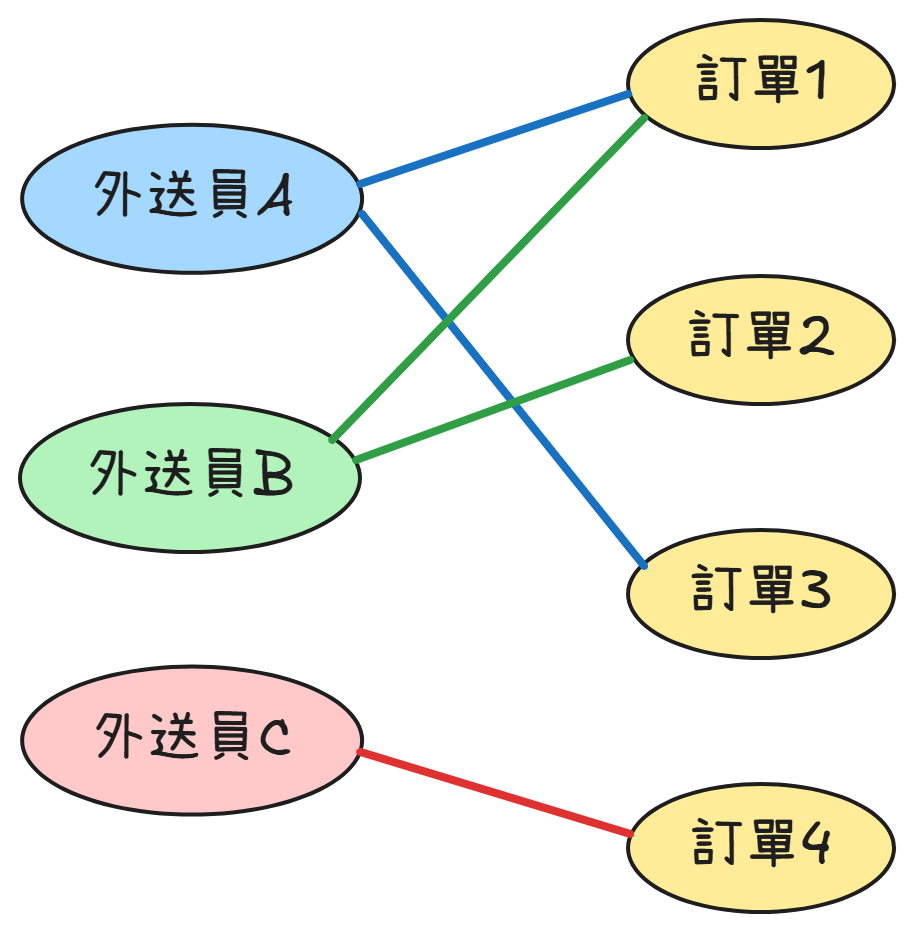
但這一次,每一條 edge 都不只是可以配,而可能附帶很多資訊:
於是原本單純的 A 可以送 1,開始變成:
A → 1:cost = 12
B → 1:cost = 7
C → 1:cost = 20
匹配和成本考量開始結合在一起。
假設附近有三位外送員:
A:非常熟悉這個區域
B:普通
C:普通
如果平台永遠只選:
當下預估最快的人
可能慢慢變成:
A:5 張訂單
B:1 張訂單
C:0 張訂單
這時 A 的工作負擔已經非常高。
下一張訂單如果再交給 A:
A:
訂單 1
訂單 2
訂單 3
訂單 4
訂單 5
訂單 6
即使 A 在地理位置上仍然很漂亮,整體系統表現卻可能越來越差。
因此平台還可能考慮:
負載量 Workload
例如:
A:目前 3 張
B:目前 1 張
C:目前 0 張
如果 B 和 A 的預估差距只有:
A:6 分鐘
B:7 分鐘
把訂單交給 B,可能比繼續塞給 A 更合理,這就是一種資源分配。
再假設現在有兩張訂單:
附近只有一位外送員可以接其中一張。
如果只看:
誰比較近?
也許應該選 Y,但這樣 X 就會繼續等待。
於是問題又多了一個變數:
等待時間
我們可能希望等待越久的訂單越優先。
這是不是有點熟悉?
Day 3 談 Priority Queue 時,我們就遇過類似的問題。
外送平台的訂單選擇,可能同時包含:
因此「下一張要處理哪張訂單」,本身又可能是一個優先級的問題。
到這裡,我們已經碰到:
它們並不是六個互不相關的章節。
在真實系統裡,它們可能同時出現在同一個決策裡。
例如現在有:
平台可能需要考慮:
然後才決定:
X → B
Y → A
Z → C
所以真正的考量是:
我們如何把一個大型問題拆成多個可以描述、分析與處理的小問題?
學演算法時,我們很常看到這種題目:
這是必要的,因為我們必須先把單一概念看清楚。
但真實系統通常不會這麼乾淨。
外送平台不會只把重心放在解出最短路徑上。
因為它真正面對的是:
所有狀態都同時存在。
精準一點來說,通常不會只有一個。
比較像是:
道路資料
↓
估算路徑成本

目前任務
↓
估算可用時間

所有候選外送員
↓
建立可能的 matching

負載 / 等待時間 / 延遲風險
↓
計算候選方案的 cost

最後
↓
做出 assignment
你甚至可以把它想成一條 pipeline:
現實狀態
   ↓
建立模型
   ↓
產生候選方案
   ↓
排除不可能的方案
   ↓
比較剩下的方案
   ↓
做出決策
真正困難的地方是:
你到底把哪些現實條件放進模型裡?
例如我們一開始問:
誰離餐廳最近?
其實就是在不知不覺中決定了一個最佳化目標:
minimize distance
如果改成:
誰最快到?
最佳化目標就變成:
minimize arrival time
如果改成:
怎麼讓所有顧客平均等待時間最低?
又變成:
minimize total waiting time
如果還希望不要讓某些外送員永遠忙不完:
balance workload
問題開始出現多個最佳化目標:
而且它們甚至可能彼此衝突。
例如:
把訂單交給 A,可能讓這一張訂單最快送到,但 A 已經很忙。
於是:
這張訂單 waiting time ↓
A 的 workload ↑
A 原有訂單 delay ↑
換成 B:
這張訂單稍微慢一點
但 workload 更平均
其他訂單比較不會延遲
所以到底哪一個比較好?
沒有辦法只靠選最近的來衡量。
因為「好」本身,就必須先被定義。
外送平台不是一道單純的匹配或最短路徑題目,而是把多種問題結構放進同一個系統:
因此,演算法思考的第一步不是急著寫程式,也不是背出最多名稱,而是先把模糊的現實問題拆開:
釐清這些問題之後,才有辦法選擇合適的模型,再把它們組成真正可運作的系統。
目前我們一直在問:
哪一個方案最好?
例如:
可是有時候,條件會越加越多。
比如一張訂單要求 30 分鐘內送到,同時要滿足:
這時候在問 哪個方案最好? 之前,也許還有一個更基本的前提要思考:
到底有沒有任何方案能同時滿足這些條件?
因為當限制條件多到彼此牽制時,我們可能連一個可行的安排都找不到。
所以下一篇,我們要開始區分兩件以前很容易混在一起的事情:
找到一個可以做到的答案

vs.

找到所有答案裡最好的那一個
當條件多到彼此牽制時,我們是否還能直接找最好答案,還是得先確認至少存在一個可行答案?


 iThome鐵人賽
 看影片追技術