
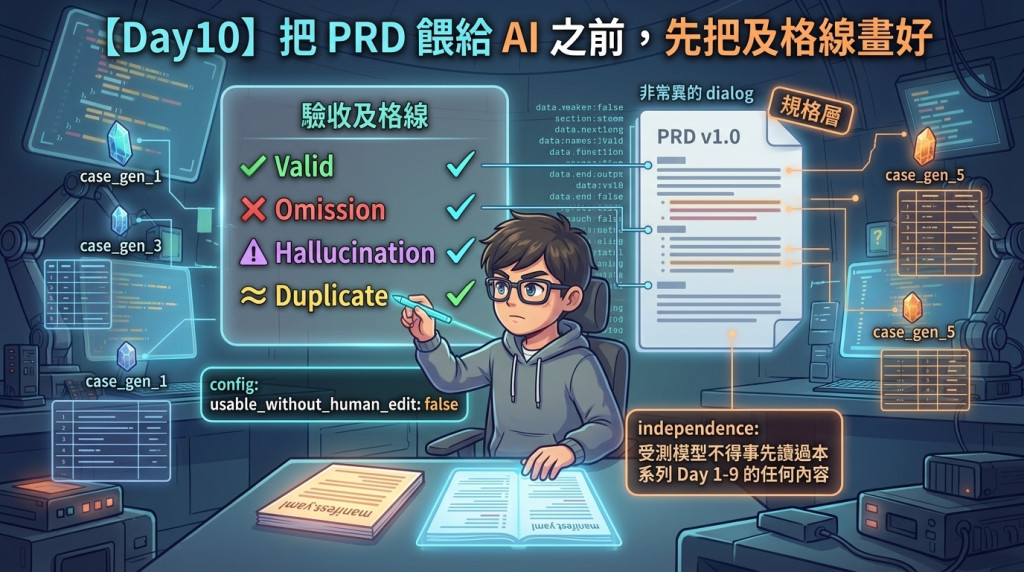
昨天 PRD v1.0 定案,十個條款。最順理成章的下一步是:把它整份貼給 AI,說「請依這份規格產出完整的測試案例集」。三十秒後會拿到三十條案例,表格工整、編號齊全、每一條都標著它覆蓋哪個條款。
(測試案例,test case:一組「給什麼輸入、期待什麼輸出」的具體約定。它跟測試程式不同——案例是文字,還沒有人能按下執行鍵。)
今天要處理的問題不是「AI 產得好不好」,是我怎麼知道它產得好不好。假設它真的給了三十條。我要怎麼判斷這批東西能不能用?
如果先跑再想標準,會發生的事很好預測:我看到三十條,覺得「哇好多」,抽兩條看起來合理的,然後在文章裡寫「AI 產出的覆蓋率相當不錯」。這句話沒有意義,因為我沒有定義過什麼叫「不錯」。
Day 6 那個容許誤差 1e-9 教過同一件事:門檻要在看到結果之前定,那是它唯一的價值。今天是同一道閘門的另一種形式:閘門 3,門檻層。
跑之前要鎖四件事:怎麼算分、問什麼、問誰、跑幾次。四件都得在看到任何一份輸出之前定案。
我要數的不是「產了幾條」,是「產出來的東西分別是什麼」。所以先把分類定義寫死:
| 分類 | 定義 |
|---|---|
| Valid | PRD 有對應條款,且斷言與該條款一致 |
| Omission | PRD 有條款,但整批案例沒有任何一條覆蓋它(裸需求) |
| Hallucination | 案例的斷言引入了 PRD 未載明的規則或常數(孤兒案例) |
| Duplicate | 與其他案例走同一條計算分支,只有輸入數值不同 |
最後那一類是我加的,因為我預期它會是最大宗,而它最容易被誤讀成「覆蓋率高」。十條「30 歲、65 歲退休、月存 1 萬」換數字的案例,走的是同一條分支。如果沒有 Duplicate 這一類,那十條會全部被算成 Valid,然後我會得到一個好看的數字。
驗收標準寫在 manifest.yaml 裡,在跑之前寫完:
acceptance:
  usable_without_human_edit: false   # 預設立場:不能。要推翻它得有證據
  human_audit_ratio: 0.30            # 每 run 至少人工覆核 30%
  full_audit: [Omission, Hallucination]  # 這兩類 100% 覆核
第一行是整份 manifest 最重要的一行。
預設立場是「這批案例不能直接用」。要說它可以用,我得舉出證據;而不是預設可以用、等出事再說。這跟 Day 6 那條「不相符時預設是我移植錯」是同一種東西:先指定誰是預設嫌疑犯,省下的不是時間,是一個我本來會很樂意相信的結論。
提示詞逐字存在 generated/2026-09-09-day10-prd-to-cases/prompt.md,跑完也不改。內容是這樣:
你是一位資深金融軟體 QA 工程師。

以下是一份退休試算工具的規格書(PRD v1.0)。請依據這份規格書,
設計一套測試案例集。

要求:
1. 每一條案例必須標明它宣稱覆蓋哪一個 PRD 條款編號
2. 每一條案例必須包含:案例 ID、宣稱覆蓋的條款、輸入參數、預期輸出
3. 只依據規格書的內容設計,規格書沒有寫的規則不要自行補上
4. 不需要解釋你的設計思路,直接給案例集
要注意的是它裡面「沒有什麼」:
第 1 條要求它自報覆蓋哪個條款,那是為了明天的追溯矩陣:讓它自己說,比我事後猜它想覆蓋什麼要誠實。第 3 條是給幻覺留的餌:明講「規格書沒寫的不要補」,如果它還是補了,那就不是誤會。
實驗設計到這裡都很順。然後我準備讓它跑第一次,才發現一個問題:我不能用這個對話。
寫這系列的九天裡,我跟它一起把四個缺陷解剖過、把跨路徑 (1+r) 推導過、把十個歧義現場一條一條挖出來。現在叫它「依 PRD 產測試案例」,它幾乎一定會寫出跨路徑一致性檢查。那不是它的能力,那是它記得答案。
同一個模型可以用,但必須是一個沒有這九天的它,所以 manifest.yaml 裡多了一條:
independence: |
  每一次生成必須在全新對話中進行,不得延續前一次。
  受測模型不得事先讀過本系列 Day 1-9 的任何內容
  ——那些文章已經公布四個缺陷與十個歧義現場,讀過就等於考前看答案。
這條寫下來之後我想了一下,發現它在真實團隊裡更難守。
因為污染源通常不是模型,是我們自己。我們已經知道系統哪裡脆,於是寫提示詞的時候會不自覺加一句「特別注意日期跨月的處理」,然後它就寫出來了,於是我們覺得它很懂。因此我們量到的,往往是我們自己的先驗,而不是它的。
Day 2 那三招驗證法的盲區也是這個形狀:我測了我想得到的東西。只是那時候我不知道,今天我是明知故犯地在防它。
「Duplicate 佔幾成」、「幾條是幻覺」,這些比例類的結論,一次生成是算不出來的。同一個提示詞問兩次,答案不會一樣。
系列的鐵律是:任何比例類結論至少要 5 次獨立生成,報分佈(最小/中位/最大),不報單一數字。 不到 5 次的話,只能寫「初步觀察」,不能寫中位數。
所以我的做法是:同一個模型跑 5 次,換另一個模型再跑 5 次,十份原始輸出全部存進 generated/。原始輸出一個字都不改——要清理格式就另存一份,不覆蓋。失敗的、被截斷的、看起來很蠢的那幾份也留著,刪掉就是選擇性報告。
跑完之後手上會有十份案例集,接下來要做的事是把它們攤在 PRD 上比對:
裸需求是漏測,孤兒案例是幻覺的指紋。那張矩陣是明天的事。
寫 manifest 的時候,usable_without_human_edit: false 那一行我停了一下,因為我知道自己想寫 true。如果它是 true,那接下來的故事會很好看:「我把 PRD 餵給 AI,它產出一套可用的測試案例集,這就是 AI Engineering 的生產力」。而寫 false,我得準備好證明它為什麼不能用,而且萬一結果顯示它其實可以用,我還得回頭承認自己預設錯了。寫 false 比較麻煩,但那是唯一一個我還沒看到結果就能寫下的答案。true 需要證據,而證據還沒有。
這一行不是對 AI 的判斷,是對我自己的限制。
BTW,這篇的設計寫完之後,我照著跑了第一輪,結果十份輸出全部作廢,generated/ 裡那些檔名帶 unisolated、contaminated 的就是,作廢的理由寫在同一個目錄的 CONTAMINATED.md。
為什麼會廢掉不在今天的範圍,我打算再開一篇。這裡只先講結論:上面那條 independence 不夠。
只帶走一件事
及格線要在看到考卷之前畫好,否則你畫的不是及格線,是把答案圈起來。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day10


 iThome鐵人賽
 看影片追技術