

今天會實際進行一個小型實驗來看看Clip大小如何影響訓練~
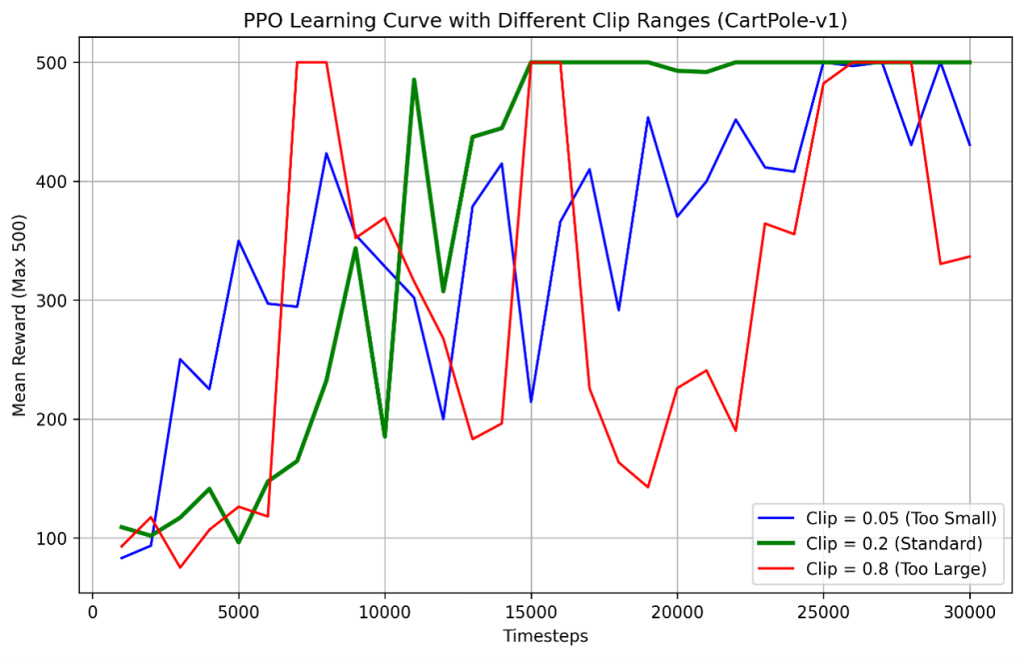
Clip是 PPO 演算法的「安全煞車系統」。設定得剛剛好,能保證 AI 穩健進步;設得太小會讓 AI 學習如龜速;設得太大則會導致 AI 走火入魔、忘掉學過的技能。建議使用0.2作為預設值
- 0.05 (太小):步伐被極度限制
- 0.2 (標準值):論文建議的最佳平衡點
- 0.8 (太大):幾乎不限制,步伐太大
這幾天我們看了 RL 實際的運作方式。但如果把視野拉遠,會發現 RL 的應用早已不只是在遊戲中「拿高分」,而是逐漸進入語言模型與自主 Agent 的世界。
從早期的西洋棋、圍棋,到如今能寫詩、寫程式的大型語言模型(LLM),甚至未來能自主操作電腦的 AI 代理(Agent),背後都離不開 RL 的影子。接下來,我們將沿著這條演進脈絡,從經典 RL、RLHF 一路看到 Agent RL,了解強化學習如何讓 AI 從「在遊戲中學會做決策」,逐步走向「理解人類需求」,最後具備「自主完成任務」的能力。
強化學習透過 Reward,讓 Agent 在 Environment 中不斷試錯,逐步學會最佳行動
為了解決語言任務中「獎勵難以定義」的問題,RLHF(Reinforcement Learning from Human Feedback)透過人類偏好來建立可學習的獎勵信號。
當 LLM 不再只需要「說話」,而是進一步「做事」,Agent 時代便隨之而來。Agent RL 將 LLM 作為「大腦」,讓它能在網頁、軟體甚至機器人等環境中自主行動。
明天主題預告: Reward Model ~


 iThome鐵人賽
 看影片追技術