

講 Reward Model 之前,我們先來聊聊RLHF流程,看看reward model用在哪裡?
依序是預訓練語言模型、在精選範例上做監督式微調、根據人類偏好資料訓練獎勵模型,最後用強化學習根據獎勵模型的回饋來微調語言模型
進入正題 Reward Model!!!
做法是拿人類標註過的「一組回答中誰比較好」的成對偏好資料(pairwise preference data),讓模型學會替 chosen(較好)回答打的分數高於 rejected(較差)回答。
偏好資料格式
必須是「同一個 prompt,一個 chosen(人類選的較好回答)、一個 rejected(較差回答)」。
例:
{
"prompt": "請解釋什麼是遞迴?",
"chosen": "遞迴是函式呼叫自己來解決問題...(完整、清楚的回答)",
"rejected": "遞迴就是迴圈啦。"
}
Bradley-Terry 公式
用來定義訓練目標函數——告訴模型「什麼叫做學得好」。
給定 prompt x,模型生成兩個回答 y₁、y₂,人類標註 y₁ 比較好。獎勵模型學的目標函數是:
- r(x, y):獎勵函數(Reward function),也就是獎勵模型本身。輸入是 prompt x 和某個回答 y,輸出一個純量分數(scalar),分數越高代表模型認為這個回答越好。所以 r(x,y1) 就是獎勵模型對回答 y1 打的分數,r(x,y2) 是對 y2 打的分數。
明天會詳細說明關於偏好資料的注意事項,難道,有陷阱???


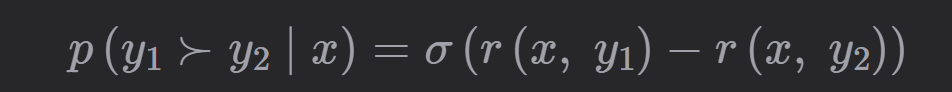
 iThome鐵人賽
 看影片追技術