

有了乾淨的偏好資料,我們今天來探討如何把這批資料變成真正能訓練模型的訊號?
詳細可以到 Day 5 看看
這個流程有幾個問題:要在訓練迴圈裡即時採樣生成文字、PPO 超參數難調、訓練不穩定、GPU 記憶體吃很兇。
一定要用 Reward Model 嗎???還是其實不用呢?
DPO是 2023 年史丹佛團隊提出的方法,用來把語言模型對齊人類偏好,核心貢獻是提出一種新的 reward model 參數化方式,讓 RLHF 問題可以用一個簡單的分類損失(classification loss)直接求解,不需要額外訓練 reward model,也不需要跑強化學習。
因為數學推導證明 reward 可以用「policy 相對 reference model 的機率比值」封閉表達,所以 reward 已經隱含在 policy 本身,不用另外訓練一個 reward model。
適合已經有高品質、成對標註偏好資料,且希望訓練穩定、資源有限、不想維護 RM 和 PPO 採樣迴圈的團隊,是目前多數開源模型偏好對齊的主流做法。
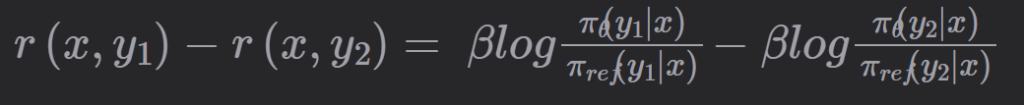
在 RLHF 的目標函數下,最優 policy 跟 reward model 之間存在一個「封閉形式」的對應關係—— reward 可以直接用 policy 自己(即相對於 reference model 的機率比值)表達出來: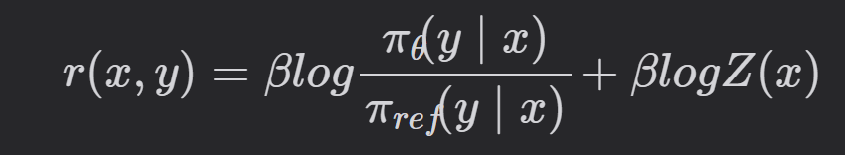
把這個式子代回 Bradley-Terry 偏好模型
其中
相減時直接抵銷:
DPO Loss
把上式代回 Bradley-Terry 機率,並對整個偏好資料集 D 做最大概似估計(maximum likelihood estimation,即最小化負對數概似):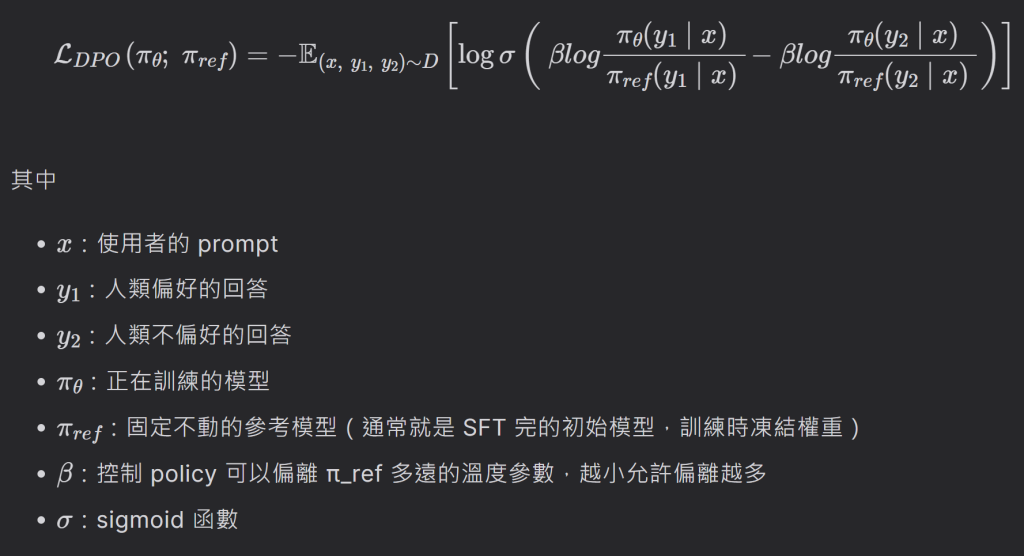
明天我們將正式進入 GRPO(Group Relative Policy Optimization),看看它如何突破 DPO跟PPO!


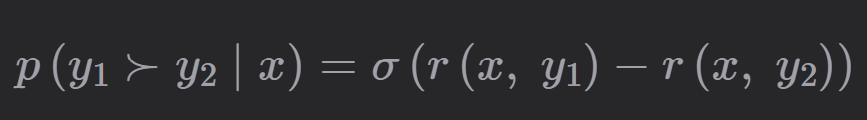
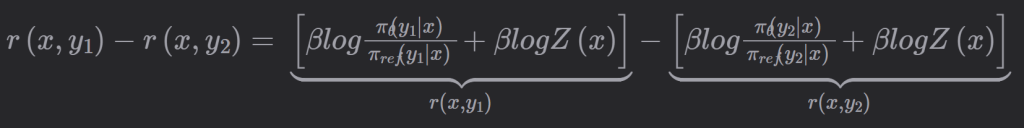
 iThome鐵人賽
 看影片追技術