

前面我們看到,DPO 將強化學習轉化為「二選一(Pairwise)」的偏好學習,只需判斷 y_1 與 y_2 哪個更好即可。然而,面對數學推理、程式碼生成等複雜任務時,兩兩比較容易缺乏整體品質的判斷,也需要大量偏好配對資料,限制了模型的探索能力。
為了突破這些限制,同時降低傳統 PPO 高昂的記憶體與計算成本,GRPO(Group Relative Policy Optimization,群體相對策略最佳化) 因此誕生。
在傳統的 PPO 訓練中,為了解決「這個動作到底好不好(Advantage)」的問題,必須在記憶體中載入一個與策略模型(Policy Model)差不多大的價值模型(Critic)。
-> 這等於要在 GPU 上同時塞下兩個巨大的模型。
GRPO 的最大創新就是直接砍掉了 Value Model,這替 DeepSeek 省下了極為可觀的硬體成本。
讓模型對同一個 Prompt 生成一組(Group)多個不同的回答,接著系統會計算出這組回答的**「平均分數」**。
透過將每個回答的分數與這個平均值相減,可以直接判斷誰好誰壞:
這不僅非常符合人類在做 RLHF 偏好標註時「比大小」的直覺,更棒的是,它直接用「群體平均」取代了傳統 PPO 中極度耗費運算資源的 Critic 模型,大幅降低了訓練成本!
GRPO (Group Relative Policy Optimization) 最早是在 DeepSeekMath 這篇論文中被提出來的。它的核心目標函數 (Objective Function) 其實是建構在 PPO 的基礎上,但巧妙地移除了價值模型 (Value / Critic Model) 並引入了群體相對評估機制。
以下是 GRPO 原始論文中的數學公式與詳細拆解:
GRPO 要最大化的目標函數如下:
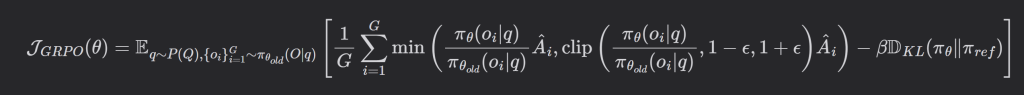
公式拆解與物理意義: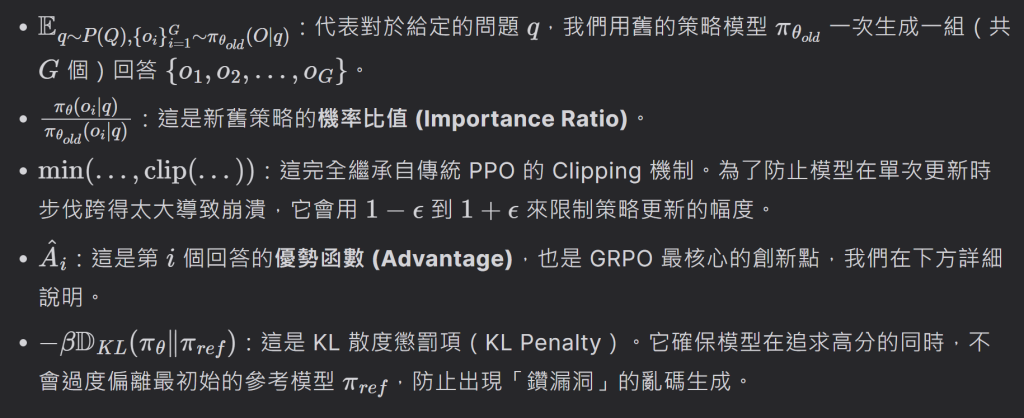
在傳統 PPO 中,優勢函數必須仰賴一個龐大的 Critic 模型來計算預期基準 (Baseline)。而 GRPO 中,優勢函數的計算極度簡化,直接在剛才生成的 G 個回答中進行內部標準化 (Z-score Normalization):
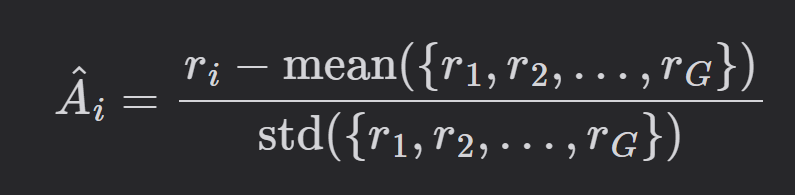
公式拆解與物理意義: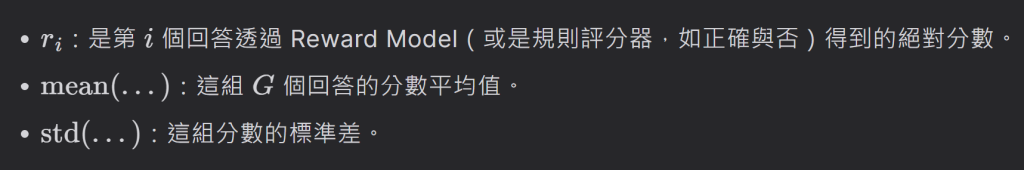
透過這個公式,若回答的分數高於該組平均,\hat{A}_i 為正,模型會去最大化目標函數並鼓勵生成此類回答;若低於平均,\hat{A}_i 為負,模型則會打壓該回答。
總結來說,GRPO 的公式精妙之處就在於:它將 PPO 複雜的「跨時間步/跨模型優勢估計」,轉化成了極簡的「當下同儕群體內的相對競爭」。這讓它在維持甚至超越 PPO 訓練效果的同時,大幅降低了硬體資源的消耗。
| 算法 | PPO | DPO |
|---|---|---|
| 優點 | 通用性強、能處理任何形式的 reward | 簡單穩定、資源需求低 |
| 缺點 | 多個模型同時吃顯存,訓練不穩定、超參數難調 | 離線資料涵蓋不到的情況模型學不到,也沒有 RL 那種「線上探索」的能力 |
今天我們談完語言模型如何在靜態問答中對齊偏好,明天我們將跨出純文字對話,進入 AI Agent 執行複雜任務的真實戰場!


 iThome鐵人賽
 看影片追技術