iT邦幫忙

2026 iThome 鐵人賽

DAY 26
0
佛心分享-IT 人自學之術

30 天 從數據思維到自動化稽核實戰系列 第 26 篇

Day 26:風控實戰專案(一)— 金融 open data 導入、去識別化與問題定義(Ask & Prepare)

  • 分享至 

  • xImage
  •  

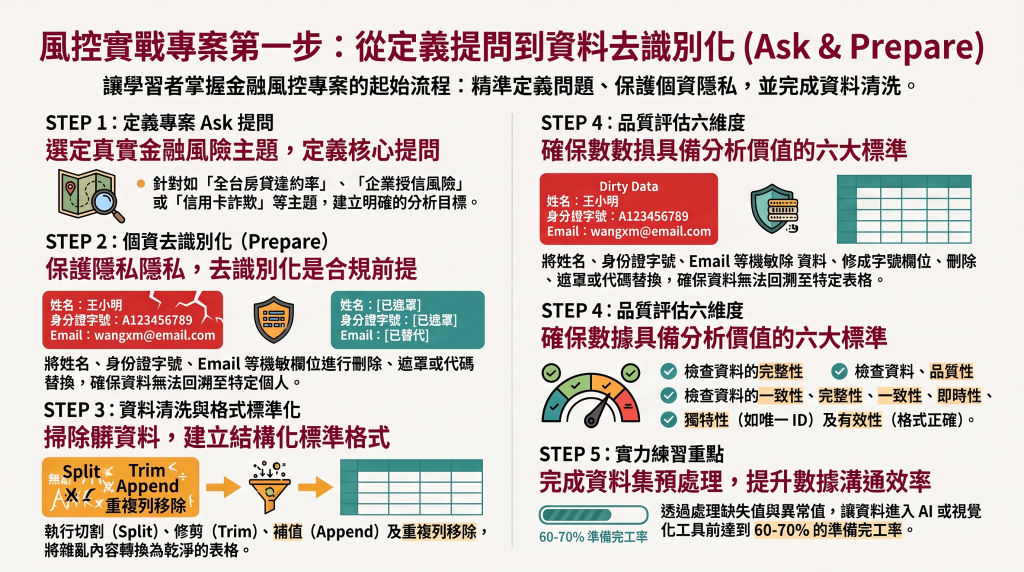
https://ithelp.ithome.com.tw/upload/images/20260913/20070969CbrfaOuCH4.png
收到!各位打火弟兄注意,我是今天的資料分析兼 AI 戰術教官。裝備檢查完畢,全部給我集中精神進入狀況!

今天的實戰救援任務是推進 「Day 26:風控實戰專案(一)— 金融 Open Data 導入、去識別化與問題定義(Ask & Prepare)」!

從今天開始,我們正式進入「風控實戰專案」連載演練。在數據分析與風控救援的火場裡,數據分析不是拿到資料就盲目塗刷,整個標準流程包含了:Ask(定義提問)➔ Prepare(準備資料)➔ Process(資料處理/清洗)➔ Analyze(數據分析)➔ Share(視覺化溝通)➔ Act(決策行動) 這六大黃金階段。

如果在專案第一階段沒有把 「Ask (提問與目標)」 定義清楚,也沒有把 「Prepare (資料準備與個資去識別化)」 鋪設到位,就冒然向 AI 拋出原始數據,不僅會陷入盲目分析的泥淖,更會引發敏感個資外洩與隱私違規的連環大火!

以下依照我們的「救災標準作業程序 (S.O.P)」進行全方位的專案第一階段拆解與實力演練:


🚨 1. 災情評估與風險控制 (Size-up & Problem Analysis)

在專案啟動與金融 Open Data 導入的數據火場中,目標模糊與資安破口是最致命的起火源:

  • 數據火場的致命盲點:
    1. 無目標分析(No Clear Ask):許多人在執行風控專案時,直接抓了一包「開放資料(Open Data)」或「信用卡/房貸數據」,就想請 AI「隨便幫我分析一下」。沒有明確的問題邊界(Ask),只會產出堆砌圖表卻毫無決策價值的廢報告。
    2. 資安違規與個資外洩(PII Leakage):金融 Open Data 或內部資料中常包含客戶姓名、身分證字號、聯徵 ID 或地址等個人可識別資訊(PII)。若直接未經處置貼給生成式 AI,等於將敏感個資暴露於公用模型的訓練風險中。
  • 打火弟兄最常犯的致命迷思:
    1. 迷思一:「認為公開政府 Open Data 已經完全乾淨,可以直接拿來建模。」 —— 錯!開放資料常存在格式不一(如民國年與西元年混用、字串夾雜逗點、欄位名稱過長)等髒資料污染源,必須重新進行格式標準化。
    2. 迷思二:「以為去識別化就是把姓名刪掉就好。」 —— 錯!身分證字號、電話末碼、精確住址甚至可連帶推導的唯一識別碼(Unique ID),都屬於廣義個資,必須運用遮蔽(Masking)或代號替換(Anonymization)徹底隔離!

🧯 2. 戰術下達與核心原理 (Tactical Strategy)

為了鋪設鋼鐵般的專案基礎,我們採用 「Ask & Prepare 專案雙核心戰術」:

1. Ask 階段:數據思維提問拆解(Define the Problem)

  • 核心戰術:將抽象的風險關注點(如房貸違約風險),拆解為 3 個可量化、可觀察、可執行的核心問題(Core Questions)。例如:各縣市逾期放款率(NPL)趨勢為何?哪些區域屬於高暴險警戒區?

2. Prepare 階段:去識別化與數據品質維度(Data Protection & Profiling)

  • 去識別化三防線(De-identification Rules):
    • 姓名與 Email:替換為代號(如 Customer_01、A@example.com)。
    • 身分證 / 帳號 / 唯一識別碼:手動遮蔽敏感位元(如 A123***789)或轉碼為通用代碼。
    • 日期與格式標準化:統一將民國年(如 115/08/01)轉換為標準西元年 YYYY/MM/DD。
  • 六大數據品質維度檢核:
    • 驗證資料集的 完整性(Completeness)、有效性(Validity)、一致性(Consistency)、獨特性(Uniqueness)、準確性(Accuracy)與即時性(Timeliness)。

🚒 3. 黃金救援步驟 (Actionable S.O.P)

事前佈線(Data Preparation - 金融 Open Data 選定與原始結構)

我們選定專案主題:「全台各縣市房屋貸款逾期放款與不動產風險分析專案」。

原始下載之開放資料集(含髒資料與敏感識別碼):
案件序號 (RID) 申貸戶姓名 聯徵識別碼 申報年月 所在縣市 房屋貸款餘額 (NT$) 逾期放款金額 (NT$) 備註摘要
001 張大明 A123456789 115年08月 臺北市內湖區 25,000,000 0 "繳款正常"
002 李小美 B220987654 115年08月 新竹市東區 18,500,000 18,500,000 "逾期 90 天,預警標籤 #NPL-901"
003 王五 C101112233 2026/08 高雄市左營區 12,000,000 Null "資料審核中"

深入火場(Analysis & Realization - Ask 定義與去識別化實力練習)

動作一:定義專案 Ask 提問(數據思維拆解)

風控小組確定本專案要回答的 3 大關鍵問題:

  1. 問題 1(描述性):全台各縣市的房貸總暴險金額與逾期放款率(NPL %)分佈為何?
  2. 問題 2(診斷性):哪些特定區域的房貸逾期率顯著高於全行平均(> 2.5%),是否存在區域集中度風險?
  3. 問題 3(處方性):針對高逾期率區域,應採取何種授信成數(LTV)限縮與風險抵減處方?

動作二:下達去識別化與格式標準化 AI Prompt
1. 輸入 AI 的去識別化與預處理 Prompt:
# Role
你是一位金融數據工程與資安合規專家。

# Goal
請協助對【全台房貸逾期放款開放資料集】進行「資安去識別化」與「欄位格式標準化」清洗。

# Requirements & Rules
1. **去識別化 (De-identification)**:
   - 將「申貸戶姓名」替換為代號 `Customer_A`, `Customer_B`。
   - 將「聯徵識別碼」進行遮蔽,僅保留首尾字元(如 `A123***789` -> `A***789`)。
2. **格式標準化 (Formatting)**:
   - 將「申報年月」統一轉為西元標準格式 `YYYY/MM`(如 `115年08月` 轉為 `2026/08`)。
   - 將「所在縣市」拆分為 `縣市` 與 `鄉鎮市區` 兩個獨立欄位。
   - 對「逾期放款金額」中的 Null 缺失值補值為 `0`。
3. 請輸出 Markdown 表格呈清洗後的預處理成果。

動作三:清洗與預處理後的乾淨資料集(Clean & De-identified Dataset)
案件代號 客戶代碼 遮蔽識別碼 申報年月 縣市 鄉鎮市區 房貸餘額 (NT$) 逾期金額 (NT$) 計算房貸逾期率 (%) 狀態標籤
RID-001 Customer_A A***789 2026/08 臺北市 內湖區 25,000,000 0 0.00% 正常
RID-002 Customer_B B***654 2026/08 新竹市 東區 18,500,000 18,500,000 100.00% 🚨 NPL 逾期高風險
RID-003 Customer_C C***233 2026/08 高雄市 左營區 12,000,000 0 0.00% 正常 (缺值補零)

殘火處理與儀表板(Visualization & Quality Check)

  1. 六大數據品質維度殘火驗算:
    • 完整性(Completeness):Null 值已補齊為 0,無空白漏洞。
    • 有效性(Validity):日期已統一為西元 2026/08。
    • 隱私合規性(Privacy Compliance):100% 消除姓名與完整身分證號,符合個資去識別化標準。
  2. 為階段二(Process & Analyze)鋪設水線:
    將預處理好的乾淨資料存為 Cleaned_Mortgage_Risk_2026.csv,準備在 Day 27 進行特徵工程與交叉分析!

🛡️ 4. 隊長的精神訓話 (Takeaway)

「Ask 提問先鎖定,Prepare 準備不放過;個資去識別化築防線,專案進火場零資安風險!」


上一篇
Day 25:打造「AI + 風控」π 型金融人才(Human-in-the-Loop)
下一篇
Day 27:風控實戰專案(二)— AI 樞紐分析、Gartner 診斷與假說驗證(Process & Analyze)
系列文
30 天 從數據思維到自動化稽核實戰 共 27 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言