
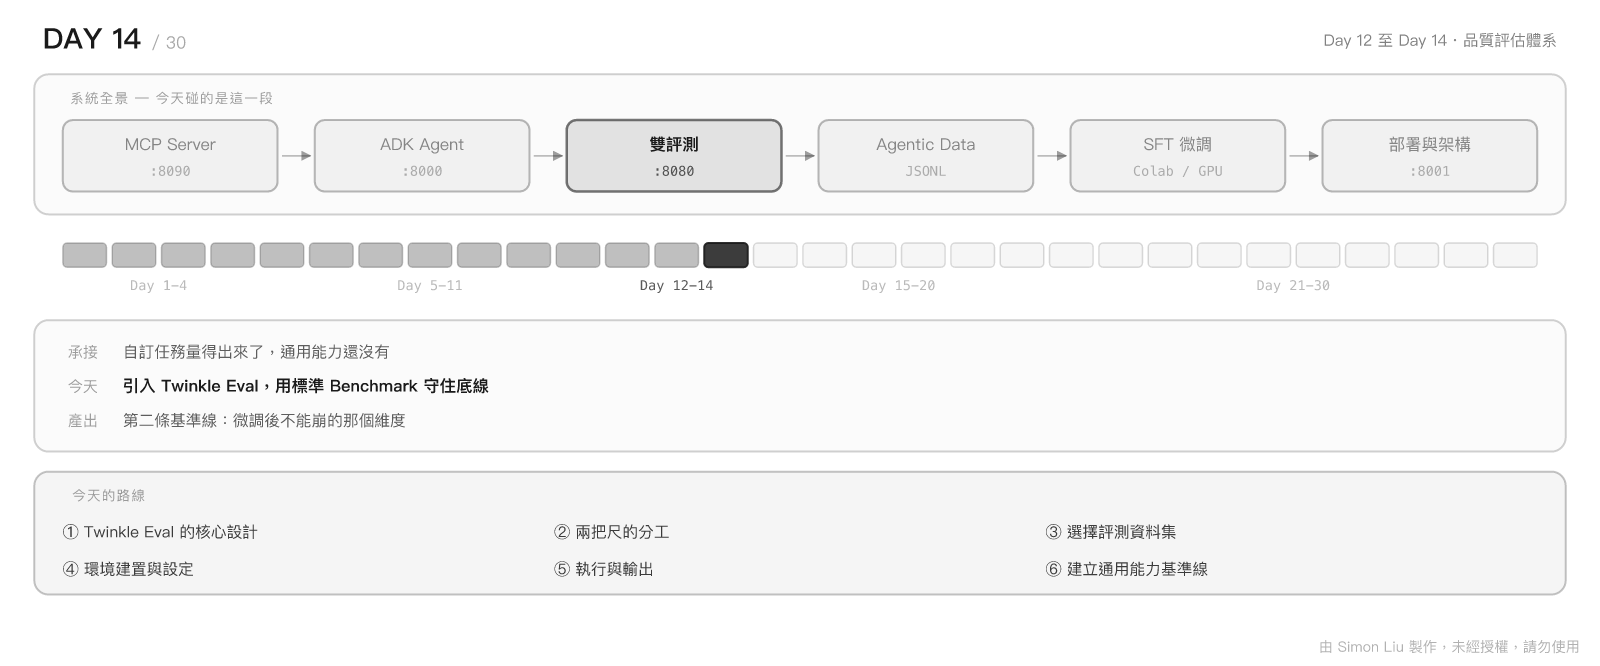
Day 12 與 Day 13 建立了以 ADEval 為核心的評測流程,它在工具呼叫的名稱、參數與順序上提供了相當嚴苛的診斷能力。到這裡為止,我們已經能夠精確回答一個問題:模型在 Leave Copilot 這組工具上,做得對不對。
然而,微調有一個廣為人知的副作用 —— 災難性遺忘(Catastrophic Forgetting)。當模型被大量特定領域的資料重新塑形之後,它在原本擅長的通用任務上,表現可能會明顯退步。
這帶出一個 ADEval 結構上回答不了的問題:模型變得更會操作我們的工具,但它是不是也變笨了?
ADEval 的測試案例全部來自 Leave Copilot,這是它精準的來源,也是它的邊界。無論微調後的模型在中文理解、數學推理或指令遵循上退步多少,ADEval 的分數都不會有任何反應。
因此,這一天要引入第二把尺:Twinkle Eval —— 一個由 Twinkle AI 與 APMIC 合作開發的高效能 LLM 評測框架(MIT 授權)。它負責的不是自訂任務,而是標準 Benchmark。
以下的內容,將會說明 Twinkle Eval 的核心設計、它與 ADEval 的分工,以及如何配置一組能在最後驗收時派上用場的通用能力基準線。
Twinkle Eval 是一個以並行 API 請求為核心的評測框架,透過 OpenAI 相容 API 呼叫已部署的模型端點,單機即可完成完整流程。
它有三個設計特別值得注意,而且每一項都直接對應到我們在 Day 11 討論過的評測困境。
2025 年之後推理模型大量出現,每次 API 回應時間顯著增加。傳統評測框架逐題同步呼叫,跑完一個 Benchmark 動輒數小時 —— 這會讓「訓練完就評測」的迭代節奏完全卡住。
Twinkle Eval 以 ThreadPoolExecutor 並行送出請求,官方實測相較於 iKala/ievals 有相當顯著的加速:
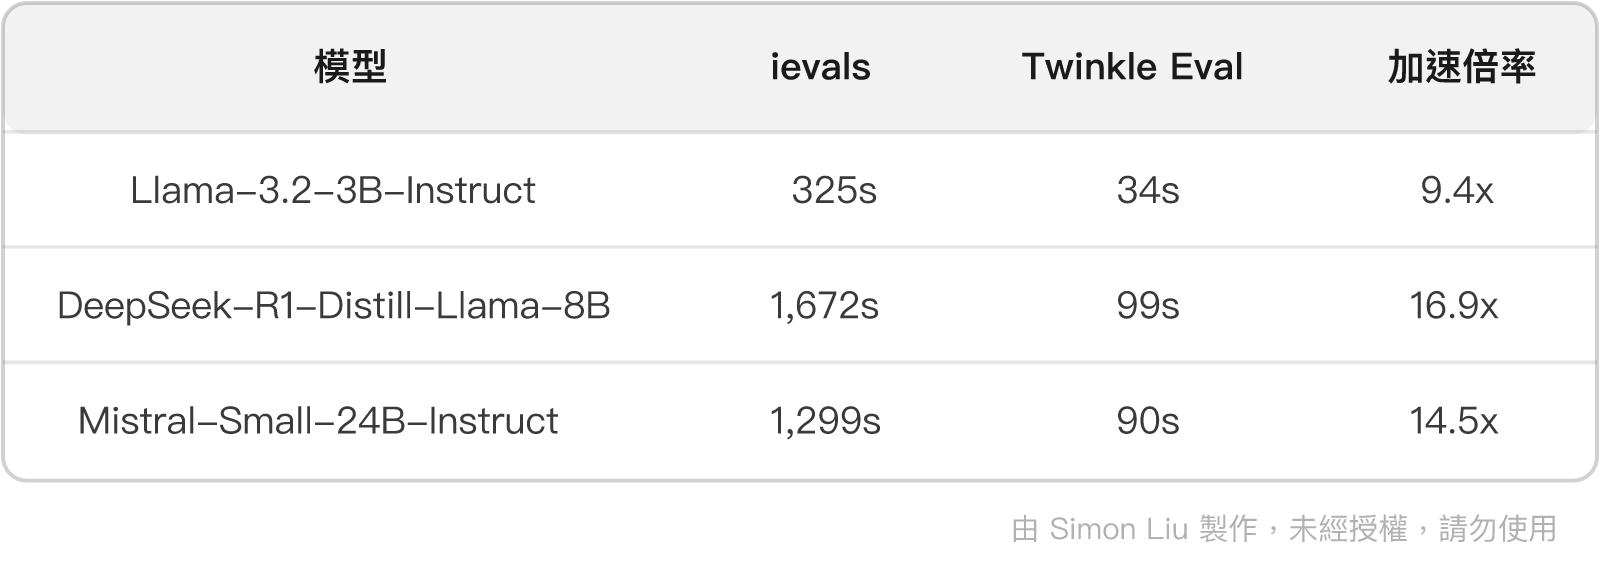
上述為 ikala/tmmluplus — basic_medical_science(954 題)的實測結果。
對這個系列的實際意義在於:系列後期若需要二次訓練,每一輪的通用能力驗收都能在幾分鐘內完成,而不是佔掉半個下午。
選擇題評測有一個容易被忽略的偏誤 —— 模型可能學到了「答案傾向出現在某個位置」,而不是真的理解題目。
Twinkle Eval 支援 shuffle_options,在每次執行時隨機排列選項順序,藉此消除位置偏好的干擾(此設計參考自相關研究)。
這一點對微調驗收特別重要。訓練資料若在格式上有任何規律性,模型都可能學到與任務無關的捷徑,而隨機化正是檢驗它有沒有走捷徑的方式。
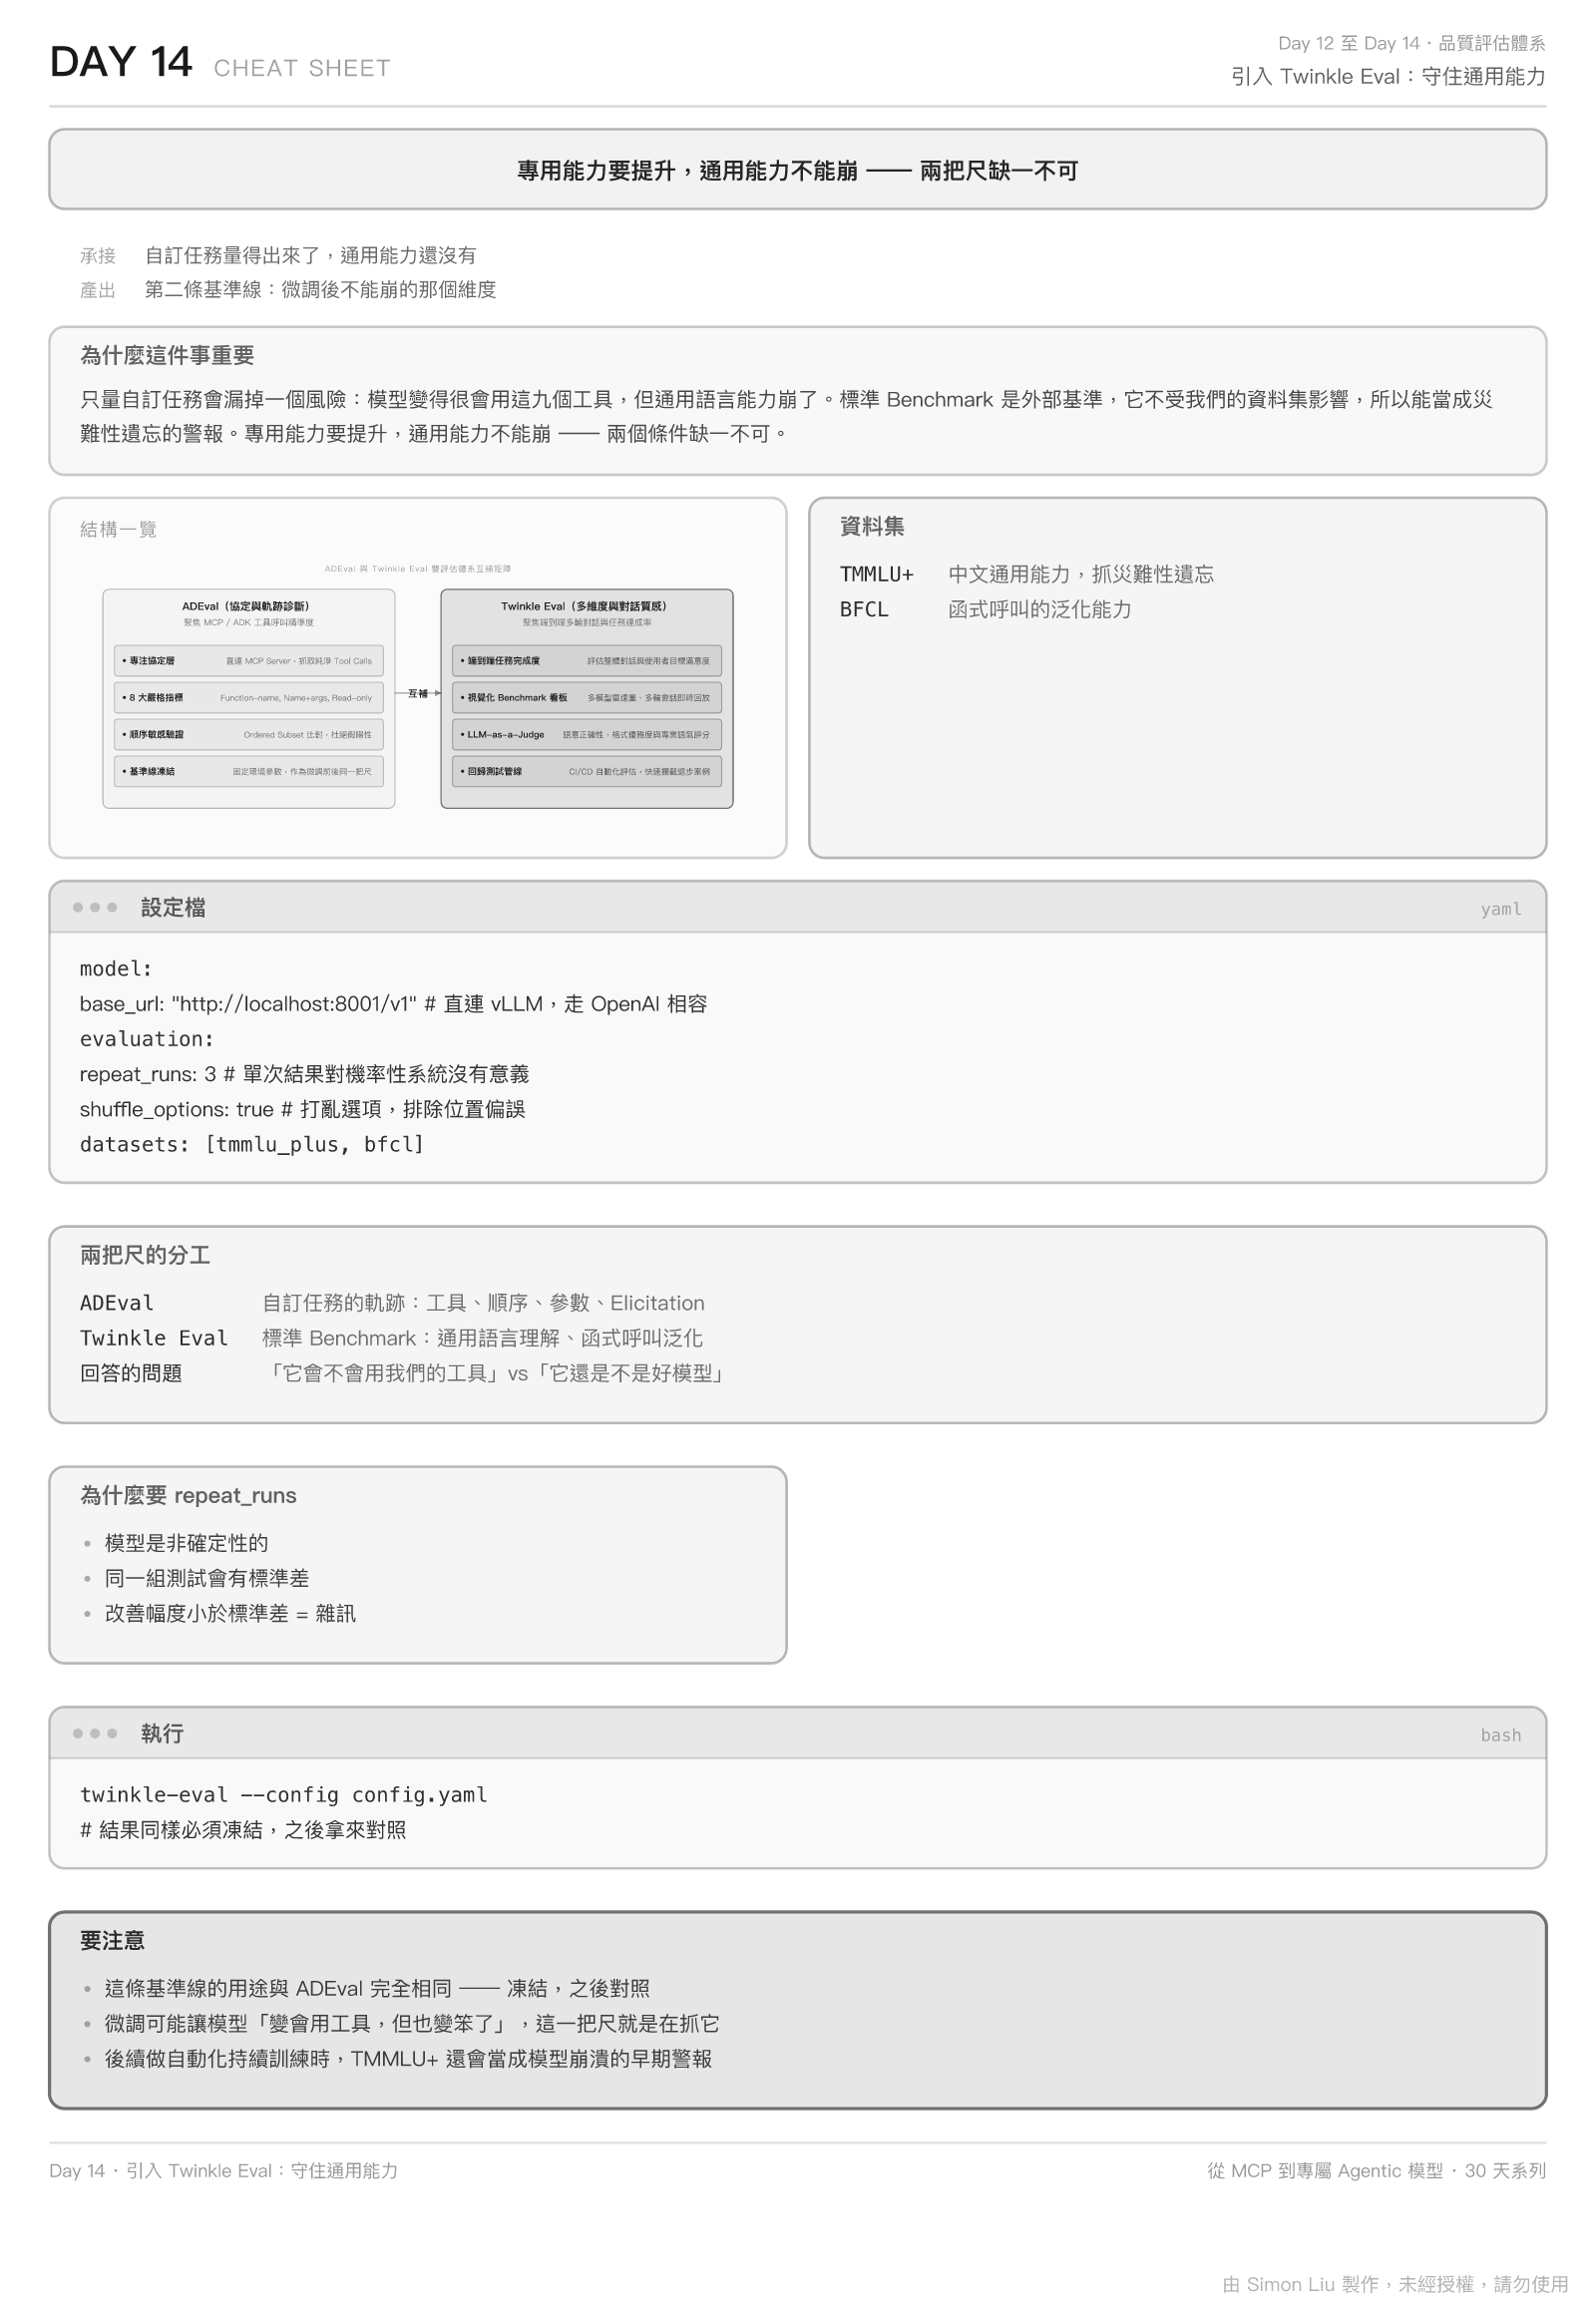
Day 11 曾說明,單次評測結果對機率性系統而言沒有意義。Twinkle Eval 用 repeat_runs 直接把這件事納入設計 —— 同一組測試重複執行多次,並輸出標準差。
這讓我們能區分兩種完全不同的情況:
最後比較微調前後時,如果改善幅度小於標準差,那個「提升」就只是雜訊。
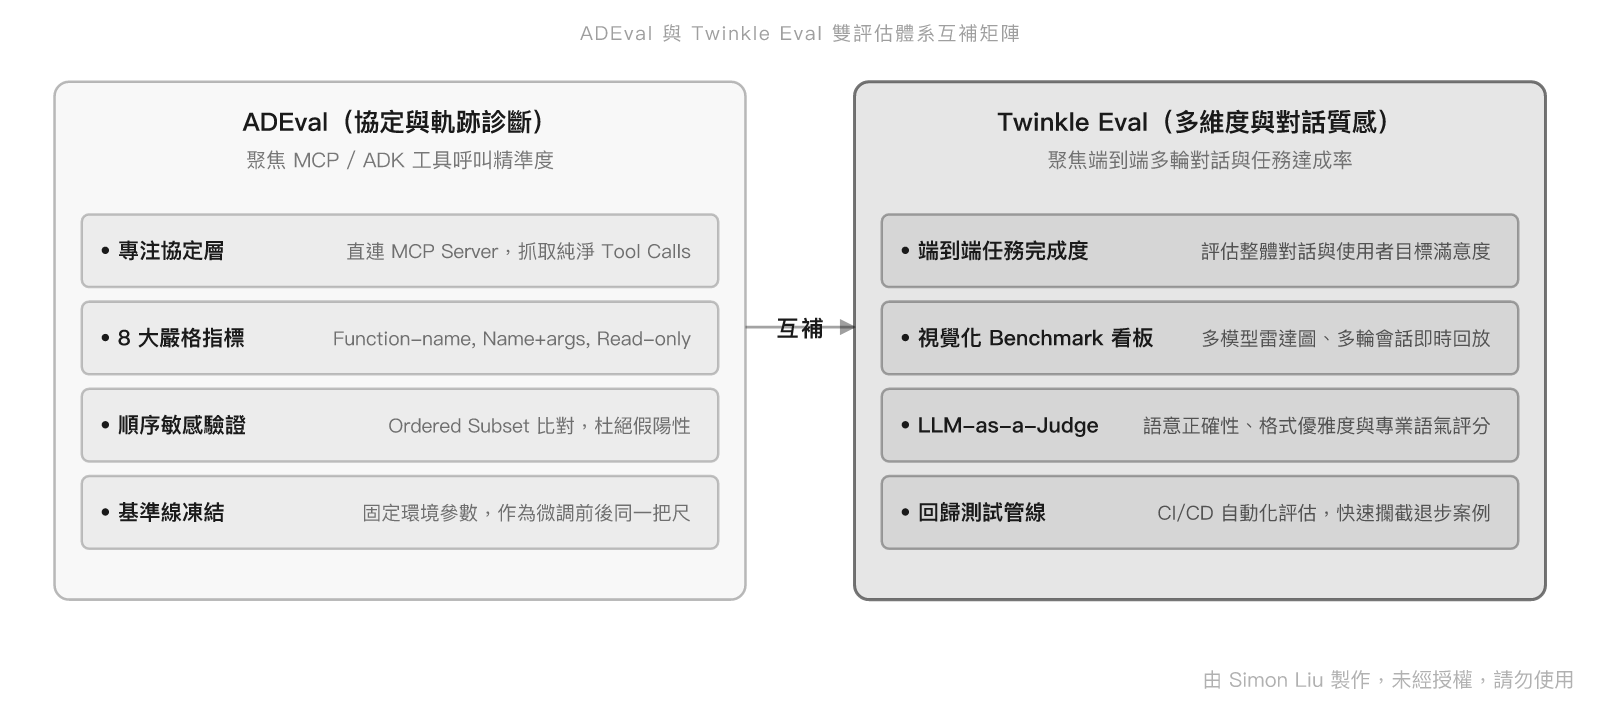
ADEval 與 Twinkle Eval 並非競爭關係,它們量測的是不同性質的能力:
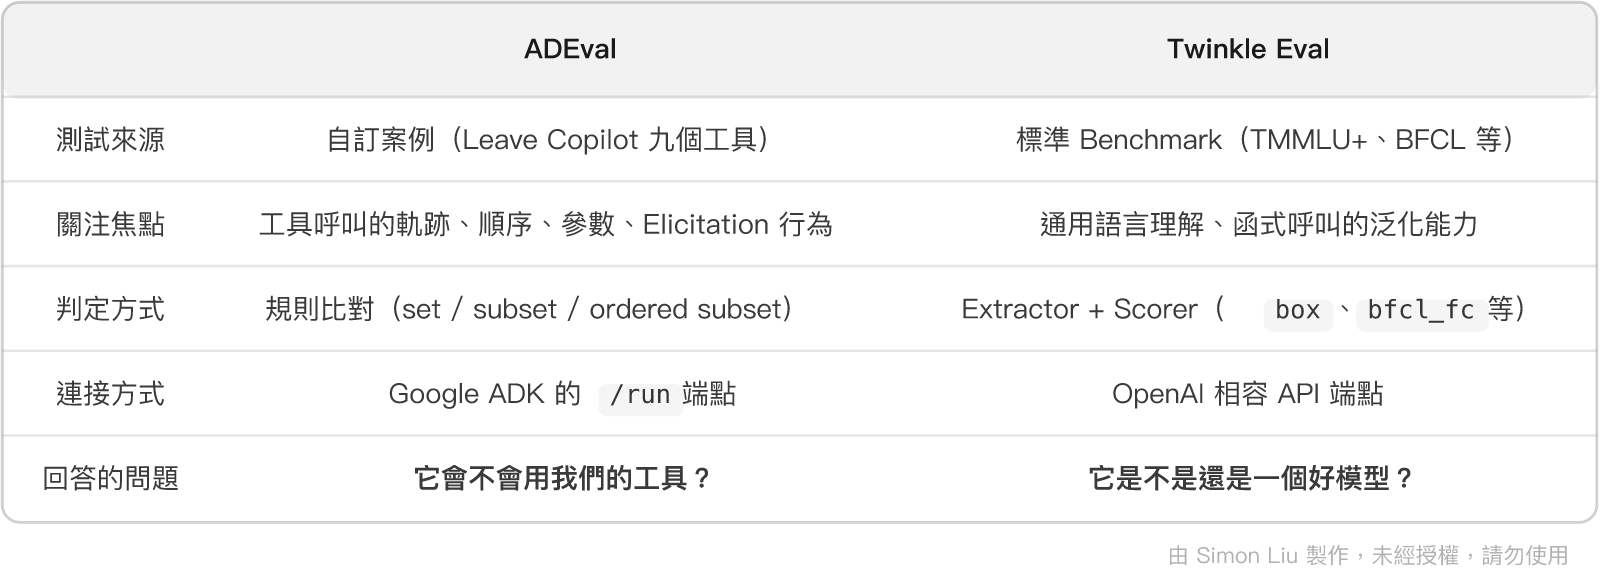
這個分工在系列後期會構成完整的驗收邏輯:專用能力要提升,通用能力不能崩。
若只有 ADEval,我們可能訓練出一個在 Leave Copilot 上接近滿分、但已經喪失基本語言理解能力的模型 —— 而那樣的模型在真實差勤場景中,連使用者模糊的口語指令都聽不懂。
Twinkle Eval 內建數十個資料集的下載支援,涵蓋十餘種評測類型(twinkle-eval --download-dataset list 會列出當下版本支援的完整清單)。對這個系列而言,有兩個特別關鍵。
TMMLU+ 是繁體中文的多任務語言理解評測。它在這裡扮演的角色是災難性遺忘的警報器。
我們的訓練資料全部圍繞請假工具,領域極窄。如果微調後 TMMLU+ 分數大幅下滑,代表模型為了學會工具呼叫,犧牲掉了原本的語言能力 —— 這時就必須回頭調整 LoRA rank 或減少 epoch 數。
BFCL(Berkeley Function Calling Leaderboard)評測的是標準函式呼叫能力,使用 bfcl_fc 或 bfcl_prompt 方法。
它與 ADEval 的差異相當關鍵:ADEval 測的是模型在我們這九個工具上的表現,BFCL 測的則是它面對沒見過的工具時還行不行。
這個對照能回答一個重要問題:微調到底是讓模型「學會了工具呼叫這件事」,還是只是「背下了這九個工具」?如果 BFCL 同步提升,代表前者;如果 BFCL 持平甚至下降,那就是後者。
Twinkle Eval 需要 Python 3.11 以上,透過 pip 安裝:
# 基本安裝
pip install twinkle-eval

# 函式呼叫評測(BFCL)需要額外依賴
pip install twinkle-eval[tool]
下載需要的資料集:
# 列出所有可下載的資料集
twinkle-eval --download-dataset list

# 本系列需要的兩個
twinkle-eval --download-dataset tmmluplus bfcl
產生設定範本:
twinkle-eval --init multiple_choice
設定檔採 YAML 格式,關鍵欄位如下:
llm_api:
  base_url: "http://localhost:8001/v1"   # 系列後期自架推論服務的端點
  api_key: "any"                          # 本地服務不驗證,但欄位必填
  api_rate_limit: -1                      # QPS,-1 為不限制
  max_retries: 5
  timeout: 600

model:
  name: "leave-copilot"                     # 對應自架服務公開的模型名稱
  temperature: 0.0                        # 評測一律用 0
  max_tokens: 4096

evaluation:
  dataset_paths:
    - "datasets/tmmluplus/"
  evaluation_method: "box"
  system_prompt:
    zh: |
      使用者將提供一個題目,並附上選項。
      請選出最正確的選項,以 \box{選項} 格式回答。
  repeat_runs: 3            # ★ 多次執行以取得標準差
  shuffle_options: true     # ★ 消除位置偏好

logging:
  level: "INFO"
其中 base_url 值得特別說明。Twinkle Eval 走的是 OpenAI 相容 API,這意味著它可以直接指向系列後期自架的推論端點 —— 不需要為了評測另外包一層轉接。
這也是為什麼部署方式的選擇會影響評測流程:換一種部署方式,就得確認它的 OpenAI 相容層是否完整支援所需的參數。
在正式執行之前,先用兩個指令確認設定無誤:
# 驗證設定檔格式與資料集路徑
twinkle-eval --validate --config config.yaml

# 預覽評測計畫,但不實際呼叫 API
twinkle-eval --dry-run --config config.yaml
--dry-run 特別實用。它會載入設定與資料集、顯示即將執行的評測計畫,但不消耗任何 API 額度 —— 對於題數動輒上千的 Benchmark,這能避免因為設定錯誤而白跑一輪。
確認無誤後執行:
twinkle-eval --config config.yaml --export json csv
若中途中斷,可以從時間戳恢復,不必從頭重跑:
twinkle-eval --resume 20260401_1430 --config config.yaml
輸出會落在 results/ 目錄:
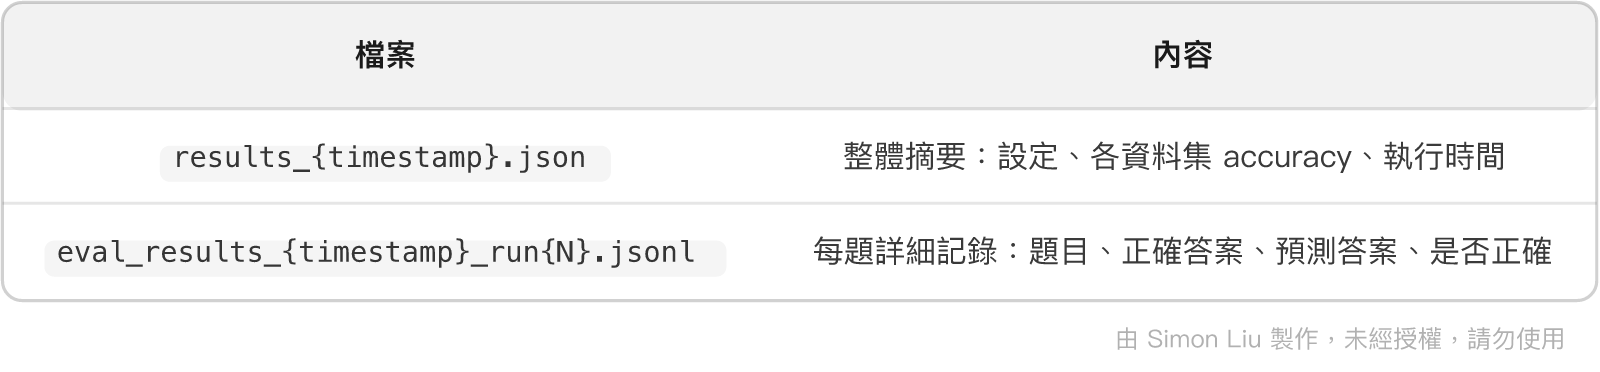
第二個檔案值得保留。當 TMMLU+ 分數下滑時,逐題記錄能讓我們看出是哪些科目退步了 —— 如果退步集中在特定領域,那通常是訓練資料的分佈問題,而不是全面性的能力損失。
也可以透過 Python API 整合進自動化流程:
from twinkle_eval import TwinkleEvalRunner

runner = TwinkleEvalRunner("config.yaml")
runner.initialize()
results = runner.run_evaluation(export_formats=["json", "csv"])
今天最重要的產出,是為尚未微調的基座模型跑一次完整評測,取得通用能力的基準線。
這組數字的用途與昨天的 ADEval 基準線完全相同 —— 它必須被凍結,並在系列後期拿來對照。
建議記錄以下欄位(實際數值待實測填入):
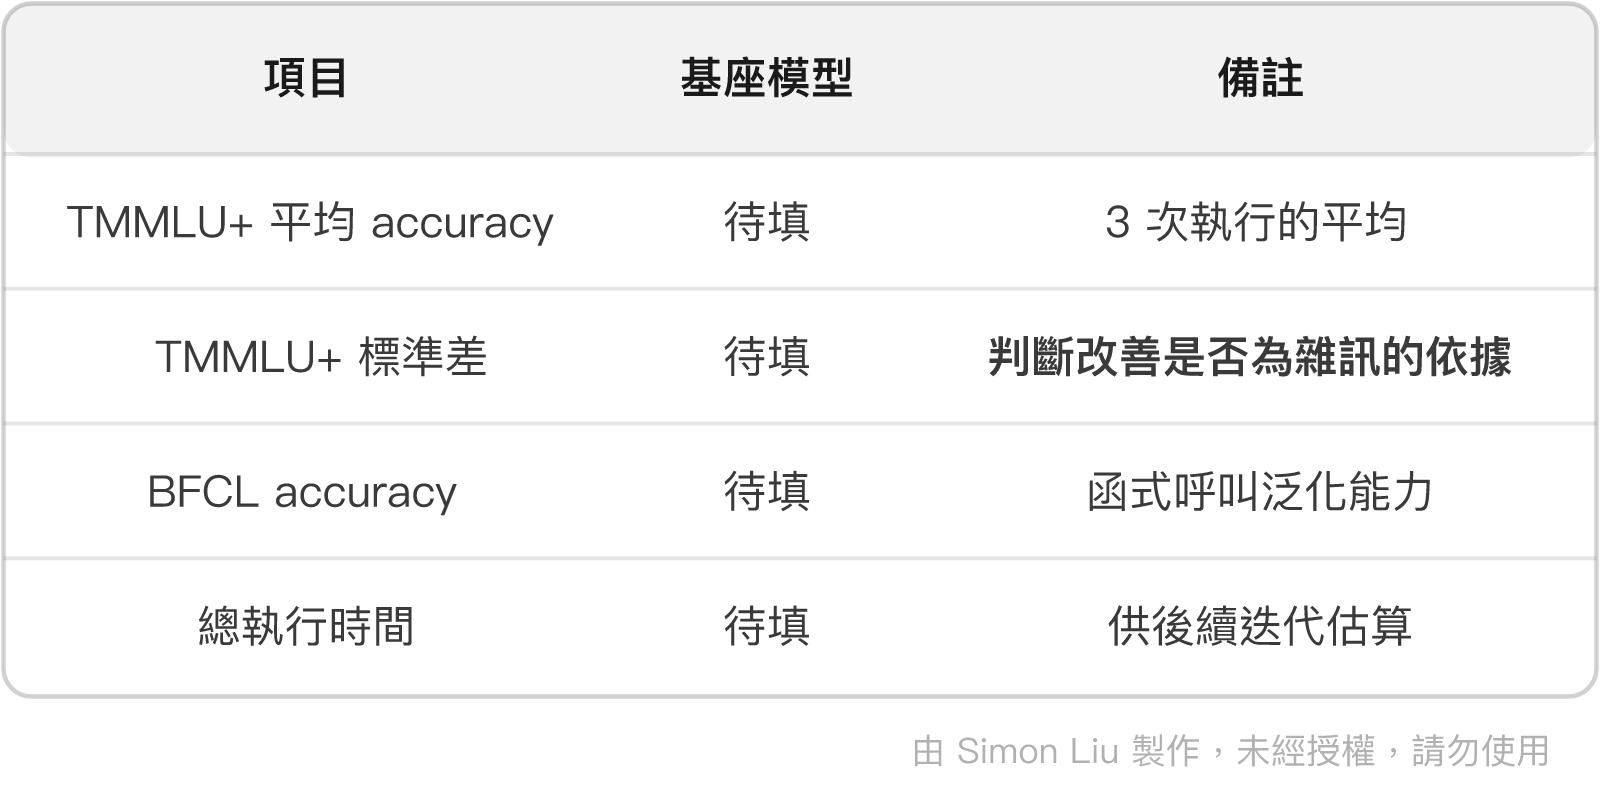
同時要凍結的還有:模型版本、temperature、repeat_runs、shuffle_options 設定,以及資料集版本。
這裡有一個容易被忽略的細節:
shuffle_options開啟時,每次執行的選項順序都不同。 這正是我們要的效果,但也意味著單次結果本來就會有波動 —— 所以repeat_runs至少要設 3,標準差才有意義。
評測體系到今天正式完備。我們手上有兩把尺,各自負責一個維度:ADEval 量自訂任務的軌跡正確性,Twinkle Eval 量標準 Benchmark 的通用能力。
總結來說,今天有三個重點值得帶走:
repeat_runs 與標準差讓「改善」變得可驗證: 如果三次執行的標準差是 5%,那 3% 的提升就是雜訊。這是把「感覺有變好」轉為「確實有變好」的分界線。至此,我們已經把基座模型在差勤任務與通用能力上的表現,都量得清清楚楚。從明天開始進入訓練資料階段 —— 把這些評測發現,轉化為專屬模型的訓練資料。
查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術