
在傳統的 LLM 微調中,訓練資料往往是簡單的 {"prompt": "...", "response": "..."} 配對。但在 Agentic 系統中,模型必須學會的是多輪工具調用與環境回饋的互動閉環。
這意味著我們需要將 Day 11 記錄的 Google ADK Event 日誌,轉化為標準的 Agentic Trajectory(軌跡資料集)。
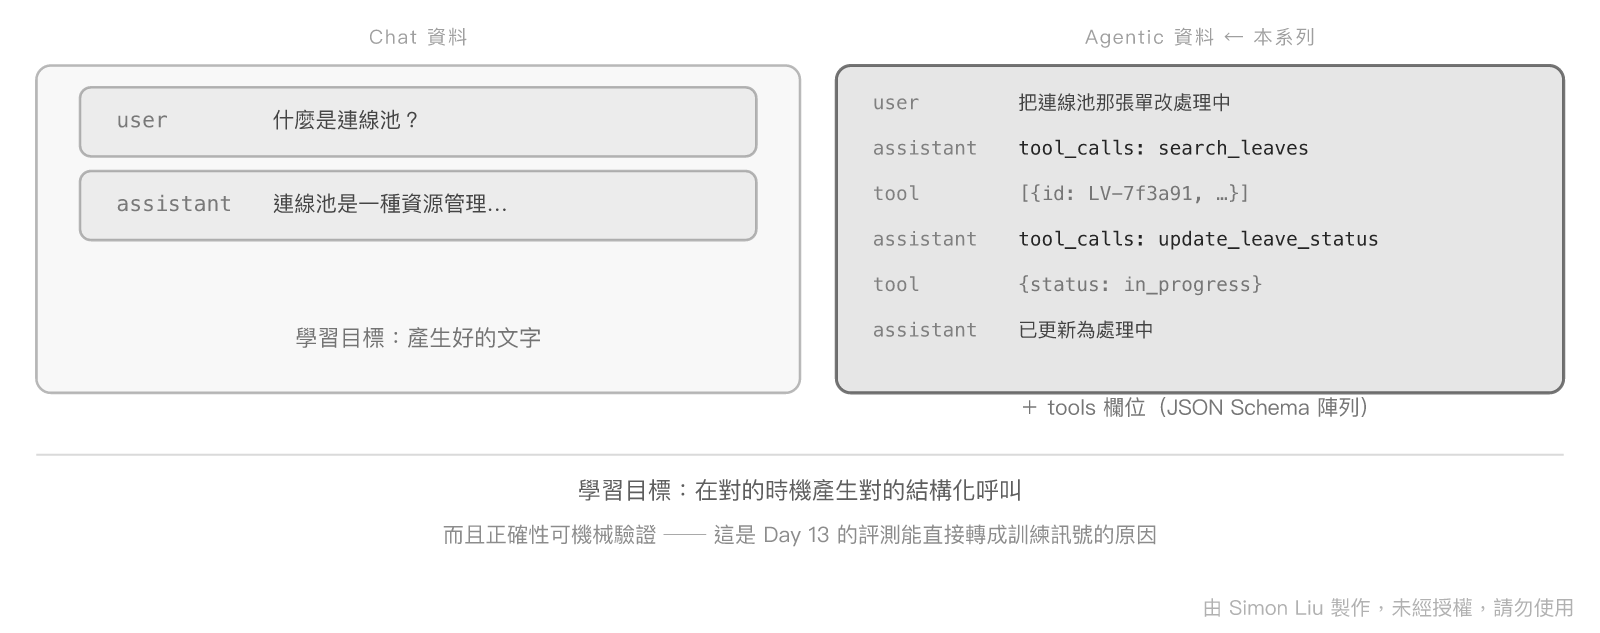
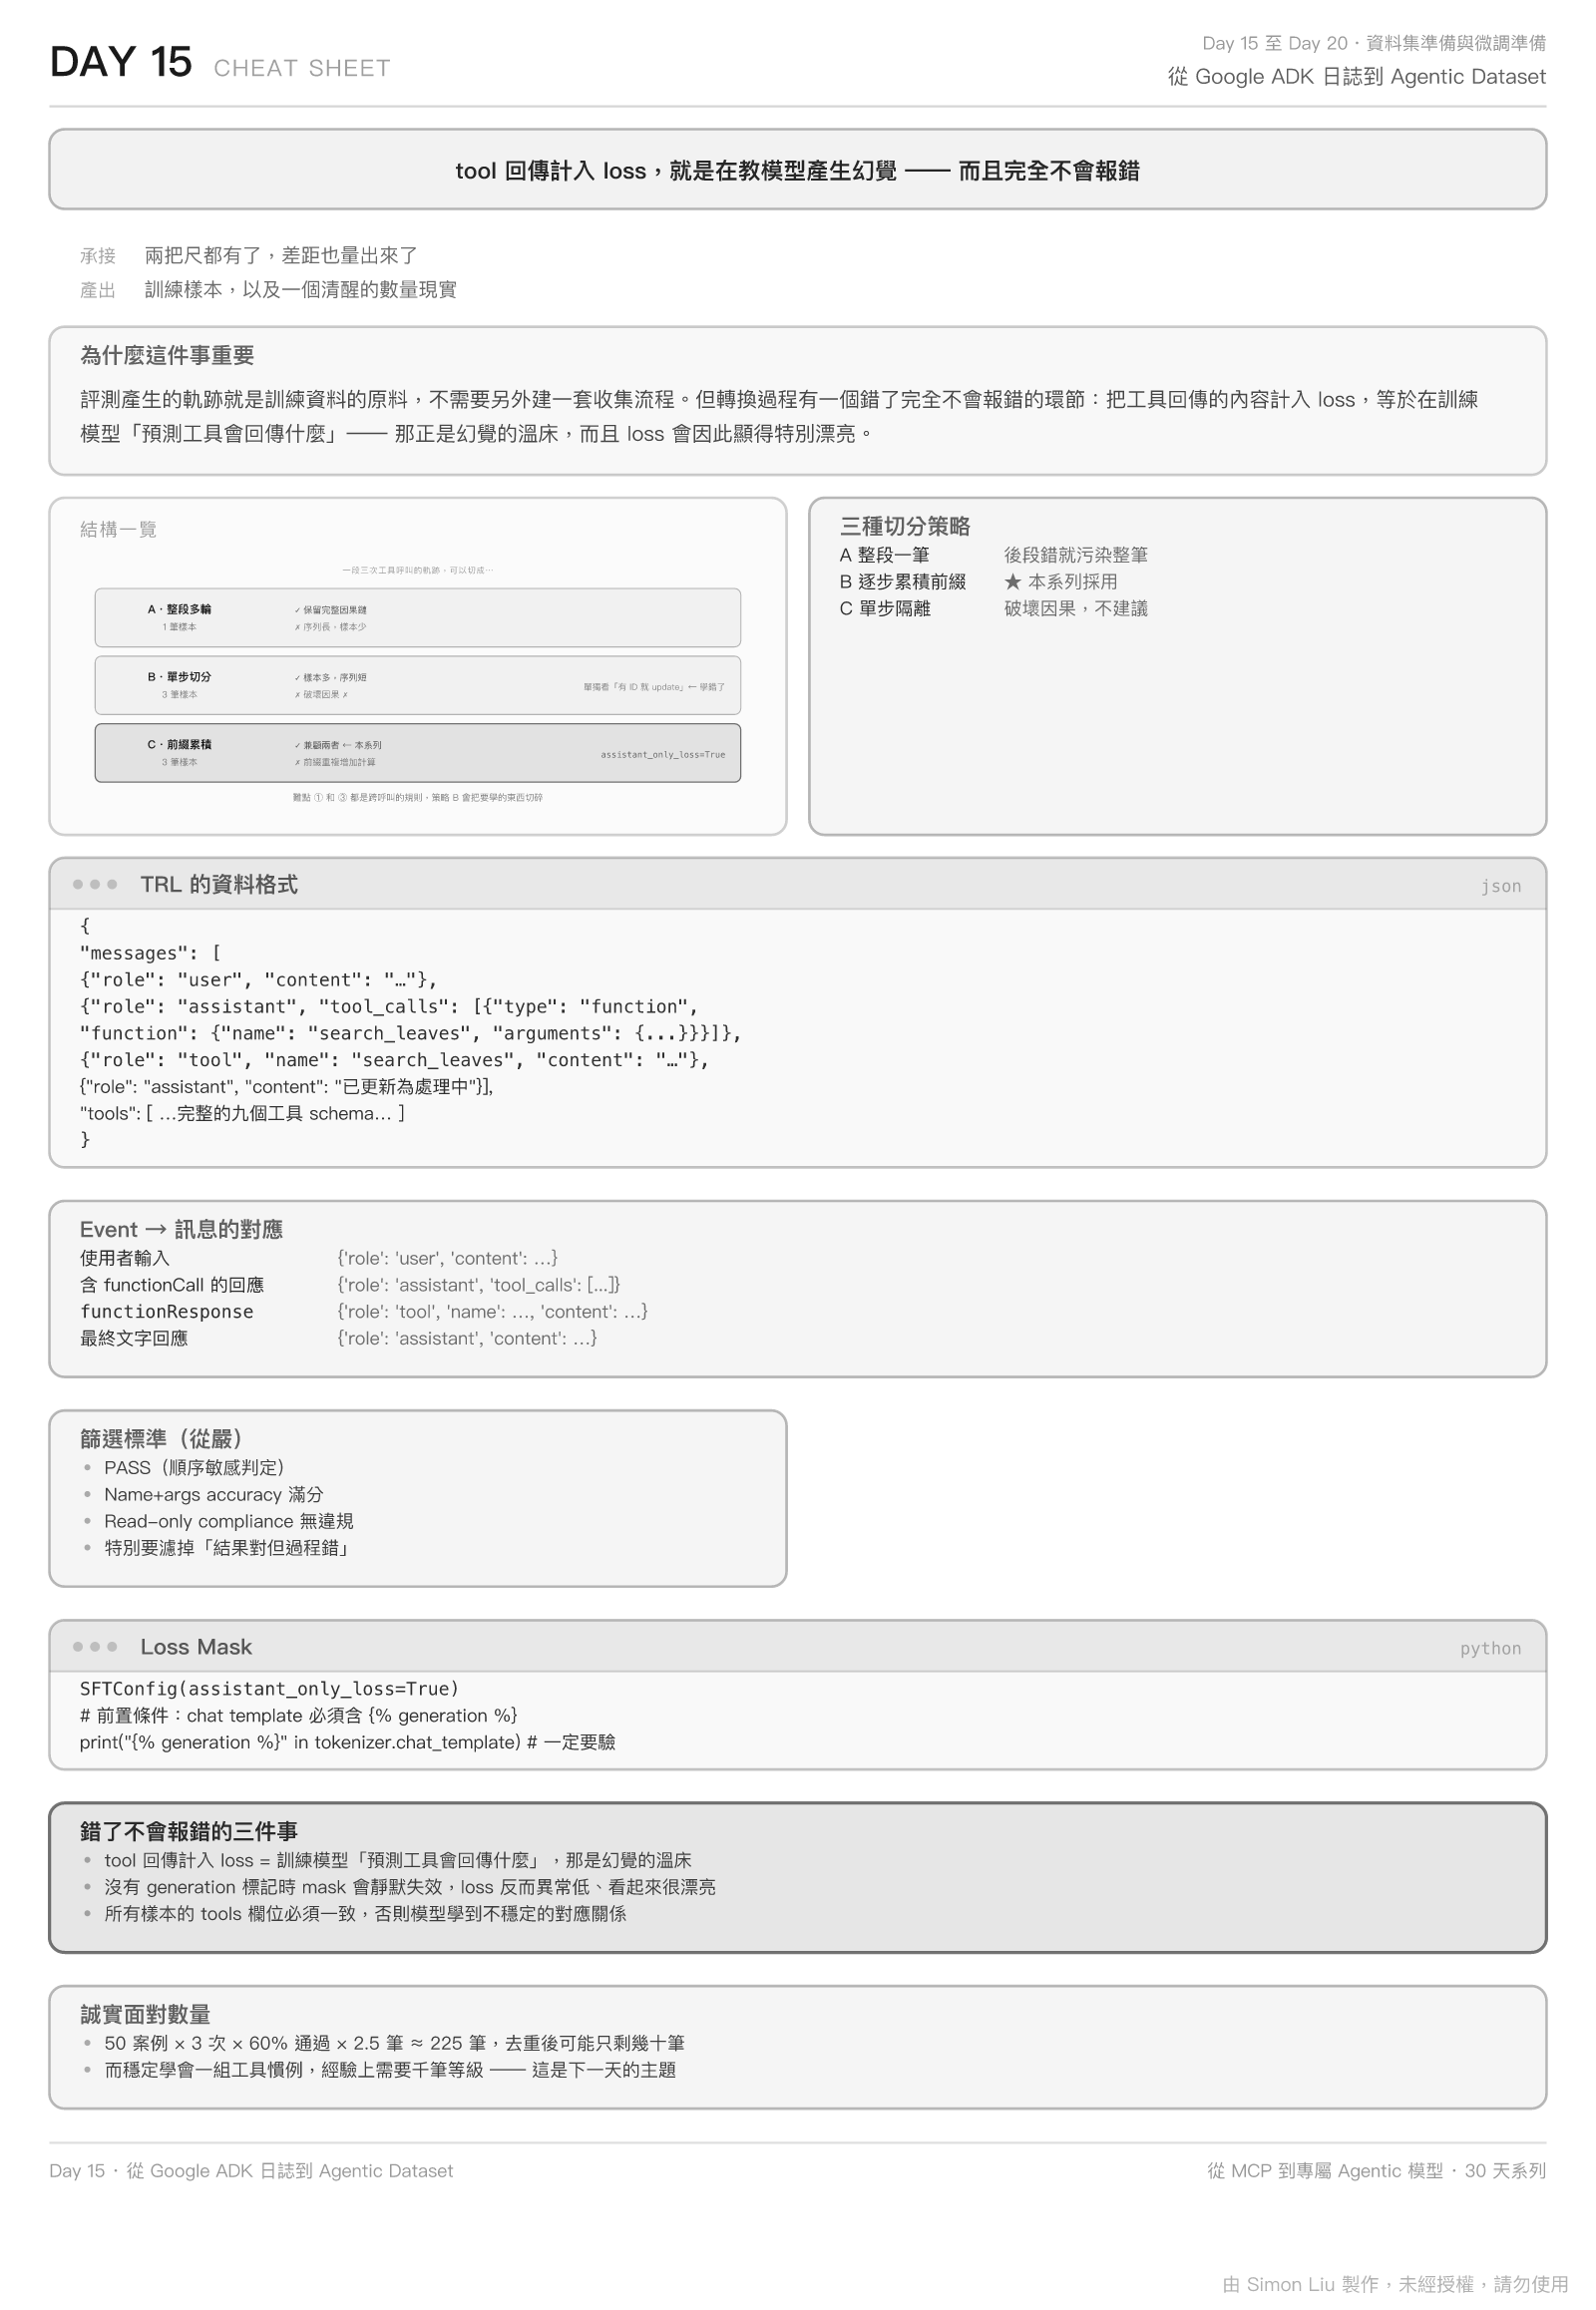
而這個轉換過程有一個相當實際的價值:評測過程中產生的軌跡紀錄,本身就是訓練資料的原料。 我們不需要另外建立一套資料收集流程,因為那些通過 Day 13 測試的執行紀錄,本來就是「模型正確操作工具」的完整示範。
以下的內容,將會說明軌跡的篩選標準、三種切分策略的取捨、轉換實作,以及一個錯了完全不會報錯的 loss mask 陷阱。
在切分之前,得先決定哪些軌跡值得留下。建議的標準相當嚴格:
expectedAnswer)從嚴篩選的理由在於錯誤成本的不對稱性:一筆錯誤軌跡所教會模型的壞習慣,往往需要用很多筆正確樣本才能矯正回來。
其中特別要濾掉一類案例:結果對但過程錯。例如模型先修改了假單、之後才執行查詢 —— 最終狀態正確,但行為完全違反難點 ①。這類案例在集合語意下會被判為通過,唯有用順序敏感的判定才擋得掉。
一段包含 3 次工具調用的完整差勤任務,該如何切分成訓練樣本?這個選擇會直接決定模型能不能學到跨呼叫的因果關係。
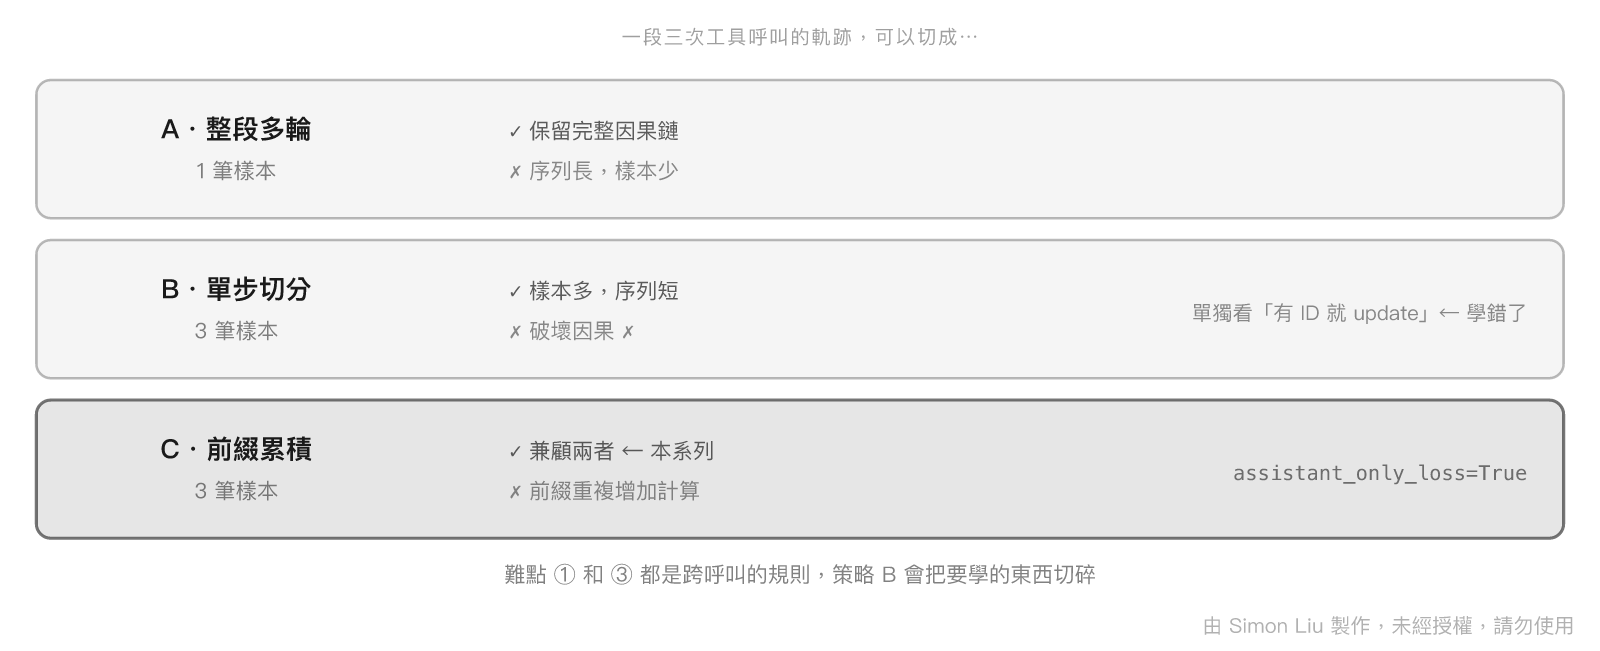
將整段對話從頭到尾作為一筆樣本。
max_length 上限。將第 1 步、前 2 步、前 3 步分別切成獨立樣本,每筆樣本保留完整的前綴歷史,但只在最後一個 assistant 回合計算 loss。
丟棄過去歷史,只保留上一動的工具回傳與當前決策。
難點 ① 與難點 ③ 都是跨呼叫的規則,策略 C 會把要學的東西切碎,因此不建議採用。
這是整個資料準備階段最容易做錯、而且錯了完全不會報錯的環節。
tool 角色的訊息是環境給予的觀察,不是模型該生成的內容。如果把它計入 loss,等於在訓練模型「預測工具會回傳什麼」—— 而那正是幻覺的溫床。
TRL 提供了對應的設定:
from trl import SFTConfig

training_args = SFTConfig(assistant_only_loss=True)
它確保 loss 只計算在 assistant 的回應上,忽略 system、user 與 tool 訊息。
一個會卡住的前置條件:這個功能需要 chat template 含有
{% generation %}與{% endgeneration %}標記。TRL 會為已知模型家族(如 Qwen3)自動 patch,其他模型則必須自行確認。若未生效,模型會把 user 訊息也算進 loss —— 而那部分它「看得到」,預測起來相當容易,因此 loss 會異常低,表面上看起來訓得很好。
驗證方式很簡單:
from transformers import AutoTokenizer

tok = AutoTokenizer.from_pretrained(MODEL_ID)
template = tok.chat_template or ""
print("generation 標記:", "{% generation %}" in template)
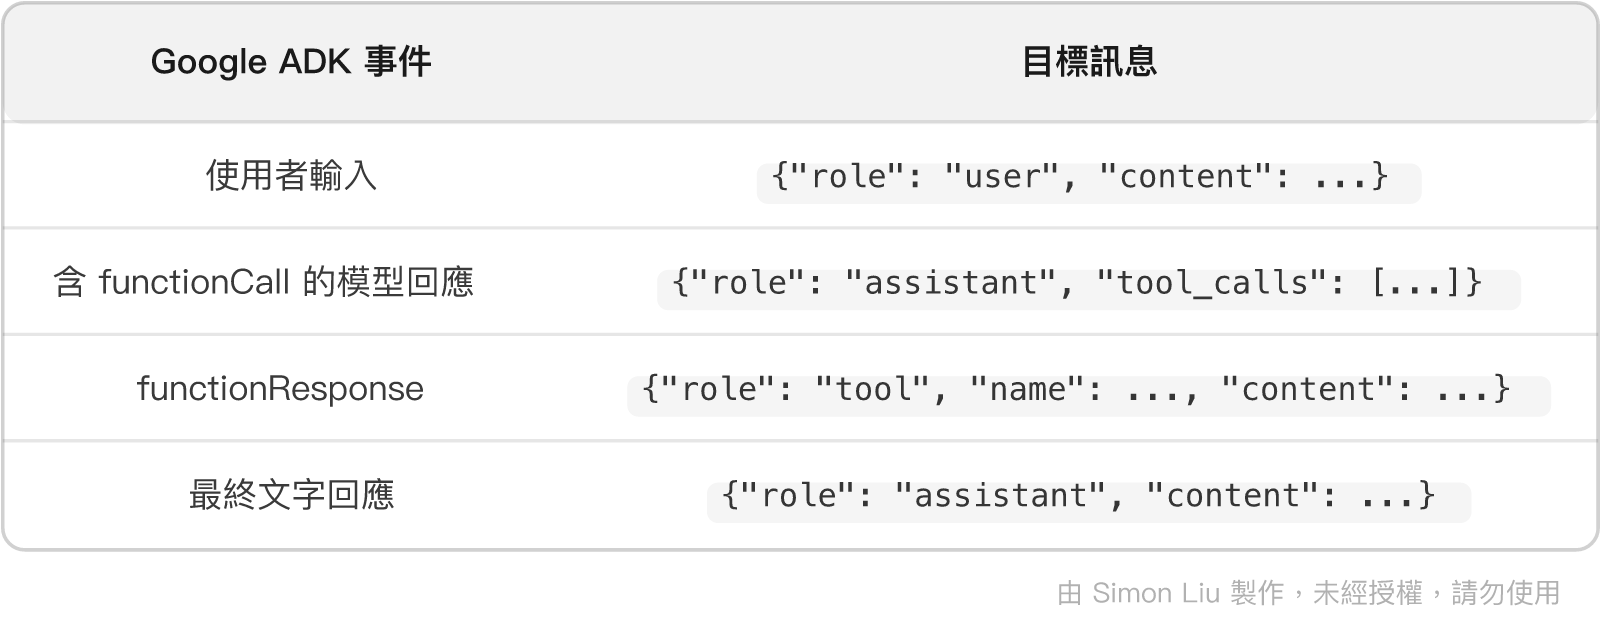
TRL 的 Tool Calling 資料格式要求每筆樣本包含對話訊息(含 tool_calls 與 tool 角色)以及 tools 欄位(工具的 JSON Schema 陣列)。
從 Google ADK 的 Event 轉換過來的對應關係如下:
實作範例:
import json


def convert_adk_trace_to_trajectory(trace_events, tools_schema):
    """把 Google ADK 的 event stream 轉成 TRL 可讀的訓練樣本。"""
    messages = []
    for ev in trace_events:
        if ev["type"] == "user":
            messages.append({"role": "user", "content": ev["text"]})
        elif ev["type"] == "tool_call":
            messages.append({
                "role": "assistant",
                "tool_calls": [{
                    "type": "function",
                    "function": {"name": ev["name"], "arguments": ev["args"]},
                }],
            })
        elif ev["type"] == "tool_result":
            messages.append({
                "role": "tool",
                "name": ev["name"],
                "content": json.dumps(ev["result"], ensure_ascii=False),
            })
        elif ev["type"] == "final":
            messages.append({"role": "assistant", "content": ev["text"]})
    return {"messages": messages, "tools": tools_schema}
這裡是 Day 3 選擇 MCP 的另一個回報:工具 schema 不必轉換。
async def dump_tools_schema(session) -> list[dict]:
    tools = await session.list_tools()
    return [
        {
            "type": "function",
            "function": {
                "name": t.name,
                "description": t.description,
                "parameters": t.inputSchema,   # 本來就是標準 JSON Schema
            },
        }
        for t in tools.tools
    ]
重要:所有樣本的 tools 欄位必須一致。 如果有些樣本給九個工具、有些給三個,模型會學到不穩定的對應關係。統一提供完整清單,讓模型自己學會選擇。
完成轉換之後,會得到一個相當清醒的數字。
假設有 50 個測試案例、每個跑 3 次、通過率 60%,用策略 B 每個案例平均產出 2.5 筆樣本:
50 × 3 × 0.6 × 2.5 ≈ 225 筆
而且這 225 筆之中存在大量重複 —— 同一個案例跑三次,成功的軌跡幾乎一模一樣。去重之後,可能只剩幾十筆。
以工具呼叫微調的實務經驗來說,要讓模型穩定學會一組工具的使用慣例,通常需要千筆等級的樣本。幾十筆的結果多半是:loss 確實會下降(模型把那幾十筆背下來了),但換個問法就失效。
這是 Day 15 至 Day 20 最關鍵的一道坎,明天將專門處理它。
軌跡資料的準備,是把「評測診斷結果」轉化為「模型改善素材」的關鍵一步。
總結來說,今天有三個重點值得帶走:
tool 角色絕對不能計入 loss: 那是環境給予的觀察,不是模型該生成的內容。而這個錯誤最麻煩的地方在於它完全不會報錯 —— loss 甚至會因為模型「抄」輸入而顯得特別漂亮。明天將探討如何設計負面樣本(Elicitation Decline)與資料擴增,把這幾十筆放大到足以支撐訓練的規模。
assistant_only_loss 與 {% generation %} 標記需求/run 事件串流格式inputSchema 為 JSON Schema查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術