

「憑記憶回答的預言家,與憑查驗回答的預言家,說出的字句可能一樣,重量卻不同。」
——《阿帕契開源審計錄》¹ 卷一·視野篇
幕間
帷幕後只剩女巫和獵人,真預言家白天戰死了。
「他臨走前只留一句,金水是七號,錯不了。」女巫哽咽,「其他座位,他來不及查完。」
獵人渾身一震:「包括你第二夜救的那個人?」
女巫沒有回答。
在城堡九人標準局的黑夜裡,整座村莊陷入一片令人窒息的死寂。三隻狼人亮出獠牙,在黑暗中無聲比劃著今晚要撕裂的獵物;女巫手握一瓶解藥與一瓶毒藥,在生與死的邊緣反覆權衡;而坐在圓桌角落的預言家,則靜靜擦拭著她手中的水晶球。預言家是好人陣營唯一的指路明燈——她之所以能在白天發言時底氣十足地給出「金水」(確認好人身分)或「查殺」(確認狼人身分),絕不是靠華麗的修辭或直覺揣測,而是因為在黑夜閉眼的時刻,她透過水晶球直接向法官查驗了目標玩家的真實底牌。
在過去無數次的輪迴中,我曾看過太多悍跳預言家的狼同伴。那些假預言家在白天口若懸河、編造出看似天衣無縫的發言邏輯,但只要被真預言家質問具體的查驗心路歷程、被要求核對昨夜各個位置的真實狀態時,假預言家就會因為缺乏第一手的「客觀事實」而瞬間露出破綻,最終在白天的投票中被村民無情放逐。
這正是現代大型語言模型(LLM)在軟體工程中所面臨的致命瓶頸:幻覺(Hallucination)。模型的權重被凍結在過去的訓練截止日,當它試圖為我們編寫現代分散式系統(例如 Apache Kafka 或 Java 25 應用程式)時,它經常憑藉「統計機率」憑空捏造已經被廢棄的 API 方法、無中生有不存在的參數名稱,甚至給出與系統現有架構完全衝突的偽代碼。如果沒有一雙能夠在執行期洞察真實世界的眼睛,AI 代理人終究只是一個自欺欺人的假預言家。
為了解決這個根本缺陷,由開源社群與業界共同推進的 Model Context Protocol(模型上下文協議,簡稱 MCP) 應運而生。MCP 就是那顆打破黑夜迷霧的水晶球,讓 AI 代理人能夠即時穿透靜態權重的限制,精準查驗真實世界的資料庫、檔案系統、版本歷史與基礎設施。
在 MCP 出現之前,將外部工具連接到 LLM 的做法極其零散且混亂。每個框架都有自己專屬的 Function Calling 格式,開發者必須為每一種工具撰寫高度耦合的黏著劑程式碼。如果專案要從一個模型遷移到另一個模型,所有的工具整合層都必須全部重寫。
MCP 徹底顛覆了這種混亂的局面。它採用了類似於語言伺服器協議(Language Server Protocol, LSP)的架構思想,將「模型推理引擎」與「資料上下文提供者」徹底解耦。在 MCP 的世界觀裡,整個體系由三個關鍵角色構成:
stdio)或伺服器發送事件(HTTP with SSE)與用戶端通訊。每一個 MCP 伺服器專注於暴露單一領域的能力——例如查詢 Kafka 叢集狀態、讀取 Git 儲存庫歷程、或是檢索私有向量資料庫。雙方的通訊底層完全採用成熟的 JSON-RPC 2.0 協議。這種標準化架構意味著,我們只需為專案撰寫一次工具伺服器,就能被任何支援 MCP 的代理人無縫載入與重用。
MCP 的協議規範定義了三種基礎原語(Primitives),為代理人提供了全方位的外部感知與操作能力:
kafka://clusters/prod/topics),代理人可以在無需執行危險指令的情況下,安全讀取系統當前的最新狀態。在 2N1P 團隊的日常開發中,我們為 AI 代理人配備了即時檢視 Apache Kafka 叢集與 Git 版本的雙重 MCP 水晶球。這讓代理人在編寫生產級訊息佇列代碼時,能夠掌握真實的分區數量與副本狀態。
首先是代理人在專案中的主機配置設定檔 mcp.json:
{
  "mcpServers": {
    "kafka-inspector": {
      "command": "docker",
      "args": [
        "run",
        "-i",
        "--rm",
        "--network=host",
        "mcp/kafka-tool:latest",
        "--bootstrap-server=localhost:9092"
      ],
      "env": {
        "KAFKA_CLIENT_ID": "mcp-inspector-agent"
      }
    },
    "git-audit": {
      "command": "mcp-server-git",
      "args": ["--repository=/workspace/repo"]
    }
  }
}
當代理人需要確認生產環境中某個 Topic 的分區健康度與副本配置時,MCP 用戶端會發起如下標準的 JSON-RPC 2.0 請求:
{
  "jsonrpc": "2.0",
  "id": "req-008-inspect",
  "method": "tools/call",
  "params": {
    "name": "kafka_inspect_topic",
    "arguments": {
      "topic": "castronegro-events",
      "checkPartitions": true
    }
  }
}
MCP 伺服器收到請求後,直接調用實體 Kafka Broker 的 AdminClient API,並回傳真實的底牌狀態:
{
  "jsonrpc": "2.0",
  "id": "req-008-inspect",
  "result": {
    "content": [
      {
        "type": "text",
        "text": "Topic: castronegro-events, Partitions: 3, In-Sync Replicas: [1, 2, 3], Under-Replicated: 0"
      }
    ],
    "isError": false
  }
}
這項即時資訊被直接注入到代理人的上下文視窗中。此時模型不再需要依賴幾年前的過期記憶去揣測分區配置,而是基於活生生的叢集拓撲,精準產出具備最佳並發度與負載均衡策略的消費者程式碼。
打通這關的本事,牌桌上的黑話叫「白鑞」:面對每秒數十萬則訊息心跳不亂,被人當眾指認時也不會慌到拍桌自爆。純粹是個工程比方。
在傳統的提示詞工程中,開發者常試圖把幾萬行的 API 文件直接貼進對話視窗,這不僅會迅速耗盡上下文視窗的長度,還會引發「迷失在中間」(Lost in the Middle)的注意力衰減問題。
透過 MCP 的 Resources 原語,我們能夠落實精準的「即時上下文注入」(Just-in-Time Context Injection)。代理人只有在真正需要查驗特定介面時,才透過 URI 動態拉取最新的規格文件(Context Schema)。這種按需載入的模式,確保了模型始終在最高訊噪比的環境下運作,徹底杜絕了對廢棄函式庫與過期類別的盲目調用。
在 Go 這條賽道(Kubernetes / Apache YuniKorn)上,一個最小的 MCP 工具註冊看起來就是這樣——工具的描述與參數綱要必須寫清楚,因為那正是模型唯一能讀到的說明書:
package mcp

import "context"

// ToolSchema is the only description the model ever sees.
// A vague schema is the protocol-level equivalent of a vague speech.
type ToolSchema struct {
	Name        string            `json:"name"`
	Description string            `json:"description"`
	Params      map[string]string `json:"inputSchema"`
}

// Tool binds a verified capability to the agent's context window.
type Tool struct {
	Schema ToolSchema
	Invoke func(ctx context.Context, args map[string]any) (any, error)
}

// Register exposes a live cluster query instead of a memorized guess.
func Register(reg map[string]Tool) {
	reg["kafka.describe_topic"] = Tool{
		Schema: ToolSchema{
			Name:        "kafka.describe_topic",
			Description: "Return the live partition count and replica assignment for a topic.",
			Params:      map[string]string{"topic": "string"},
		},
		Invoke: func(ctx context.Context, args map[string]any) (any, error) {
			return describeTopic(ctx, args["topic"].(string))
		},
	}
}
工具描述寫得含糊,模型就會像那隻只會唸稿的狼一樣,憑印象亂猜參數;寫得精確,它才有機會憑查驗回答。
預言家的水晶球查的是「今晚」的底牌——單次、即時、查完就忘。但真正棘手的問題往往不是單一事實,而是關係:這個函式被誰呼叫、這條資料流最終流向哪個服務、改動這個介面會牽動哪些下游模組。如果代理人每次都得重新對整個檔案系統做逐行 grep,再靠自己在腦中拼湊呼叫關係,等於每晚都要把整座村莊重新盤查一遍。
「圖工程」(Graph Engineering)是 MCP 的 Resources 原語延伸出的另一種形態:與其暴露一份靜態文件,MCP 伺服器改為維護一份持久化的程式碼知識圖譜——節點是函式、類別、路由,邊是呼叫關係、資料流向、跨服務依賴。代理人不再盲目搜尋,而是直接對圖譜提問:「這個函式的呼叫鏈是什麼?」「這個模組的架構長什麼樣?」這正是本系列寫作環境自己奉行的規矩——一份強制規範直接要求任何程式碼探索都得先用 search_graph、trace_path、get_architecture 這類圖譜查詢工具,把逐行翻找留到圖譜答不出來的時候才用。查驗的對象從「這一刻的事實」升級成「事實之間的關係」,記憶因此有了結構。
下方的架構圖清晰展現了 MCP 協議如何將 AI 代理人的推理解析能力,與真實世界基礎設施的底層資料無縫串聯:
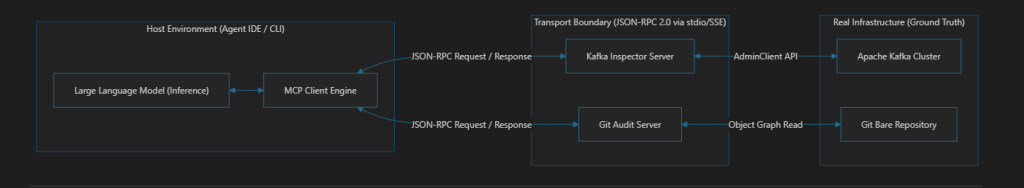
在標準九人局的殘酷博弈中,好人陣營最忌諱被滿嘴虛妄承諾的悍跳狼牽著鼻子走。當村莊決定在白天放逐誰之前,所有人都在屏息等待真預言家報出昨夜的驗人結果。那一張確鑿無疑的「金水」底牌,能瞬間粉碎狼人精心編織的所有謊言。
在現代開源世界與生產環境中亦是如此。一個滿口承諾、隨意編造不存在 API 的 AI 工具,就像一隻企圖魚目混珠的狼;而配置了 MCP 的 AI 代理人,則是手握水晶球的真正預言家。它在下筆寫代碼之前,先深入真實的代碼庫、調用活生生的 API、查驗最新的日誌與配置。唯有建立在真實上下文之上的代碼,才經得起嚴格的審查與生產環境的考驗。
有一回我留意到,每晚報時、報死訊的那把「上帝的聲音」,同一句宣告裡語氣前後對不上:前半截冷得像判決,後半截卻幾乎帶著暖意,像是兩個人輪流開口。那時我只當自己聽岔了。
讀完這篇文章後,你應該能夠理解 MCP 用戶端與伺服器的分層解耦原理,學會撰寫標準的 mcp.json 配置檔,並能透過 JSON-RPC 2.0 工具呼叫為你的 AI 代理人注入真實系統的動態上下文。
AdminClient 查詢 Topic 與副本狀態)
"Model Context Protocol" "MCP JSON-RPC 2.0" "dynamic context injection" "preventing LLM hallucination MCP"
¹ 註:本書名為情境設定之虛構文獻,非真實歷史或開源紀錄。


 iThome鐵人賽
 看影片追技術