
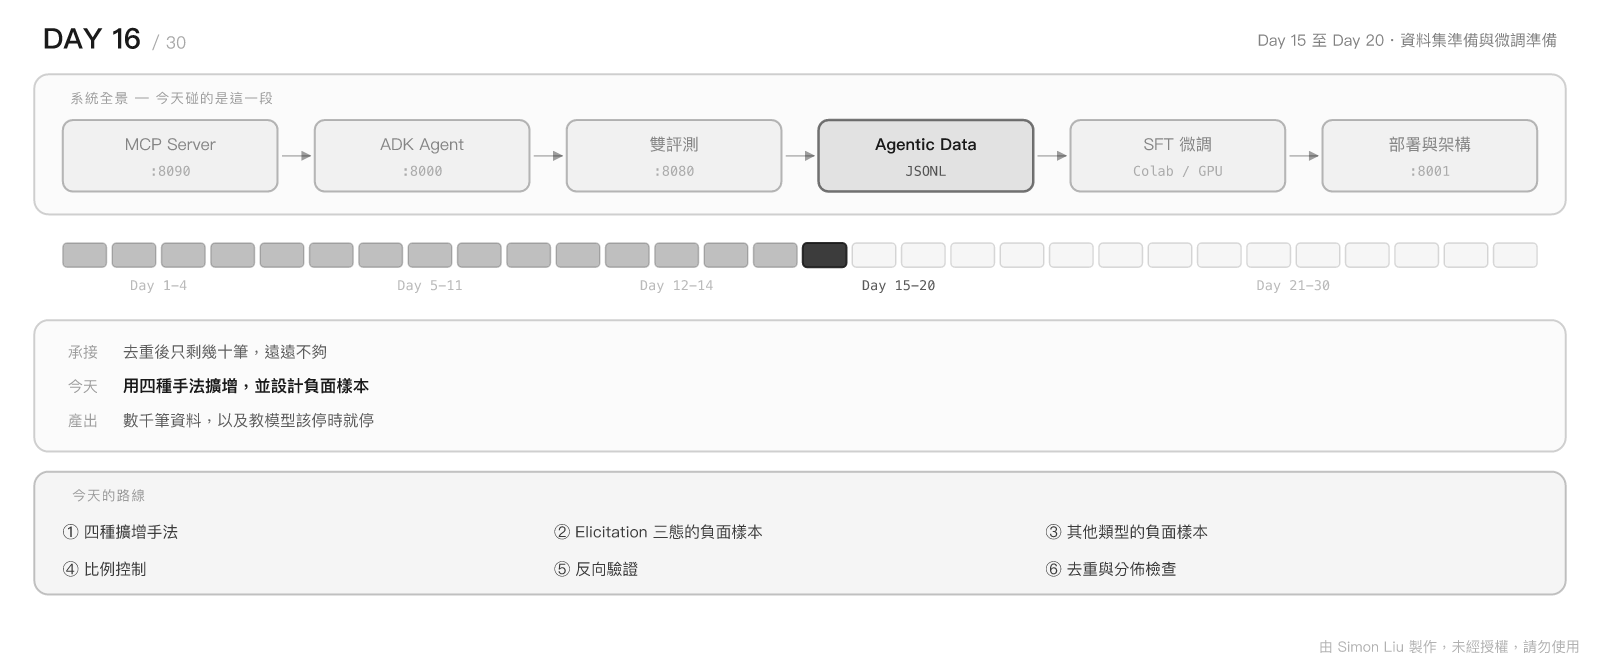
昨天的結論相當明確:從評測軌跡萃取出來的黃金資料,去重之後只有幾十筆,而這個量級不足以讓模型穩定學會一組工具的使用慣例。
面對資料不足,最直覺的做法是「請大模型生成更多」。但這裡存在一個必須非常小心的陷阱:如果讓模型自行想像「正確的工具呼叫應該長什麼樣」,我們就是在用它的猜測來訓練它自己。
因此,資料擴增的核心原則只有一條:擴增的對象是表達方式與參數組合,而不是「正確行為」本身。 正確的工具序列由規則決定,必須由程式或既有的正確軌跡推導出來,不能交給模型發想。
除此之外,今天還要處理資料集的另一半 —— 負面樣本。到目前為止所有的訓練資料都在教模型「怎麼把事情做對」,而這樣的資料集會養出一個過度積極的 Agent。
以下的內容,將會說明四種擴增手法各自的可信度、Elicitation 三態的負面樣本設計、比例控制的實務判準,以及如何用 ADEval 反向驗證合成資料。
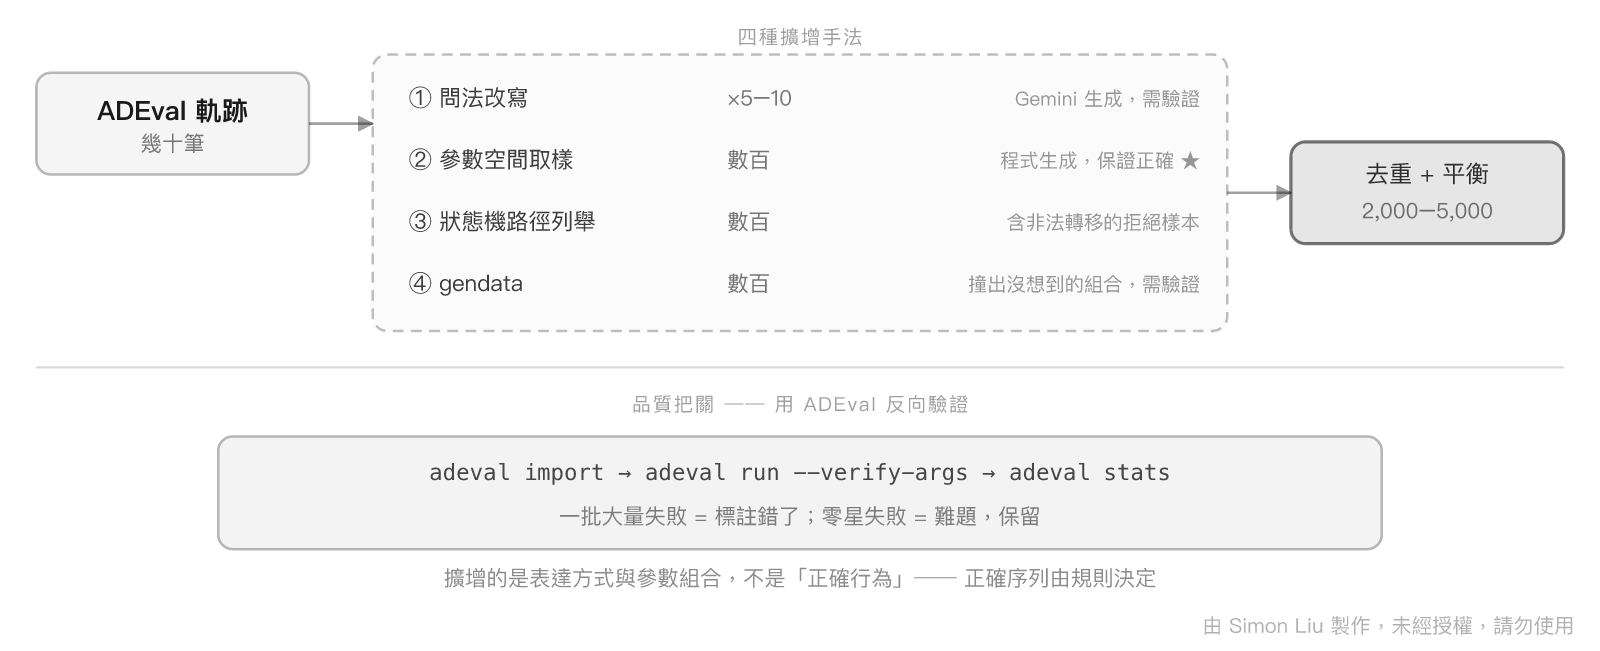
同一個工具呼叫序列,實際上可以對應到無數種自然語言的問法:
原始:把我那張家庭旅遊的特休送出審核

改寫:
  - 幫我把家庭旅遊那張假單送出去審核
  - 我要請的家庭旅遊那筆,麻煩送簽
  - 把那張家庭旅遊的特休狀態往前推一階
  - 家庭旅遊的假單我填好了,幫我送出
用 Gemini 批次生成時,關鍵在於明確約束改寫的邊界:
PROMPT = """以下是一句請假系統的操作指令。請生成 8 個語意完全相同、
但表達方式不同的版本。需要涵蓋:
- 正式與口語
- 中英夾雜(工程師的實際說法)
- 有無贅字
- 不同的資訊排列順序

不可改變操作的目標、對象或參數值。

原句:{question}"""
「不可改變參數值」這條約束是必要的。 少了它,模型會自作主張把「三個月前」改成「三十天前」,而預期的工具參數仍然是原本的 —— 資料就髒了。
這是最可信的一種手法,因為它完全由程式生成,不經過模型。
import itertools

STATUSES = [None, "draft", "submitted", "approved", "taken"]
ASSIGNEES = [None, "u_2841", "u_1103"]
DATES = [None, "2026-08-01T00:00:00Z", "2026-07-15T09:30:00Z"]

for status, assignee, date in itertools.product(STATUSES, ASSIGNEES, DATES):
    args = {k: v for k, v in {
        "status": status, "employee_id": assignee, "start_after": date
    }.items() if v is not None}
    question = render_question(args)     # 依參數組合造出對應的中文問法
    yield build_sample(question, "search_leaves", args)
45 種組合,每種再配 5 個問法變體就是 225 筆,而且每一筆的預期工具與參數都是程式算出來的,保證正確。
取樣時要確保涵蓋:每個 enum 值、選填參數的有無組合、邊界值,以及難點 ④ 的陷阱(小時 vs 天、ISO 8601 的各種合法寫法)。
假單狀態機的合法轉移只有三條,非法的有九條。把它們全部列出來:
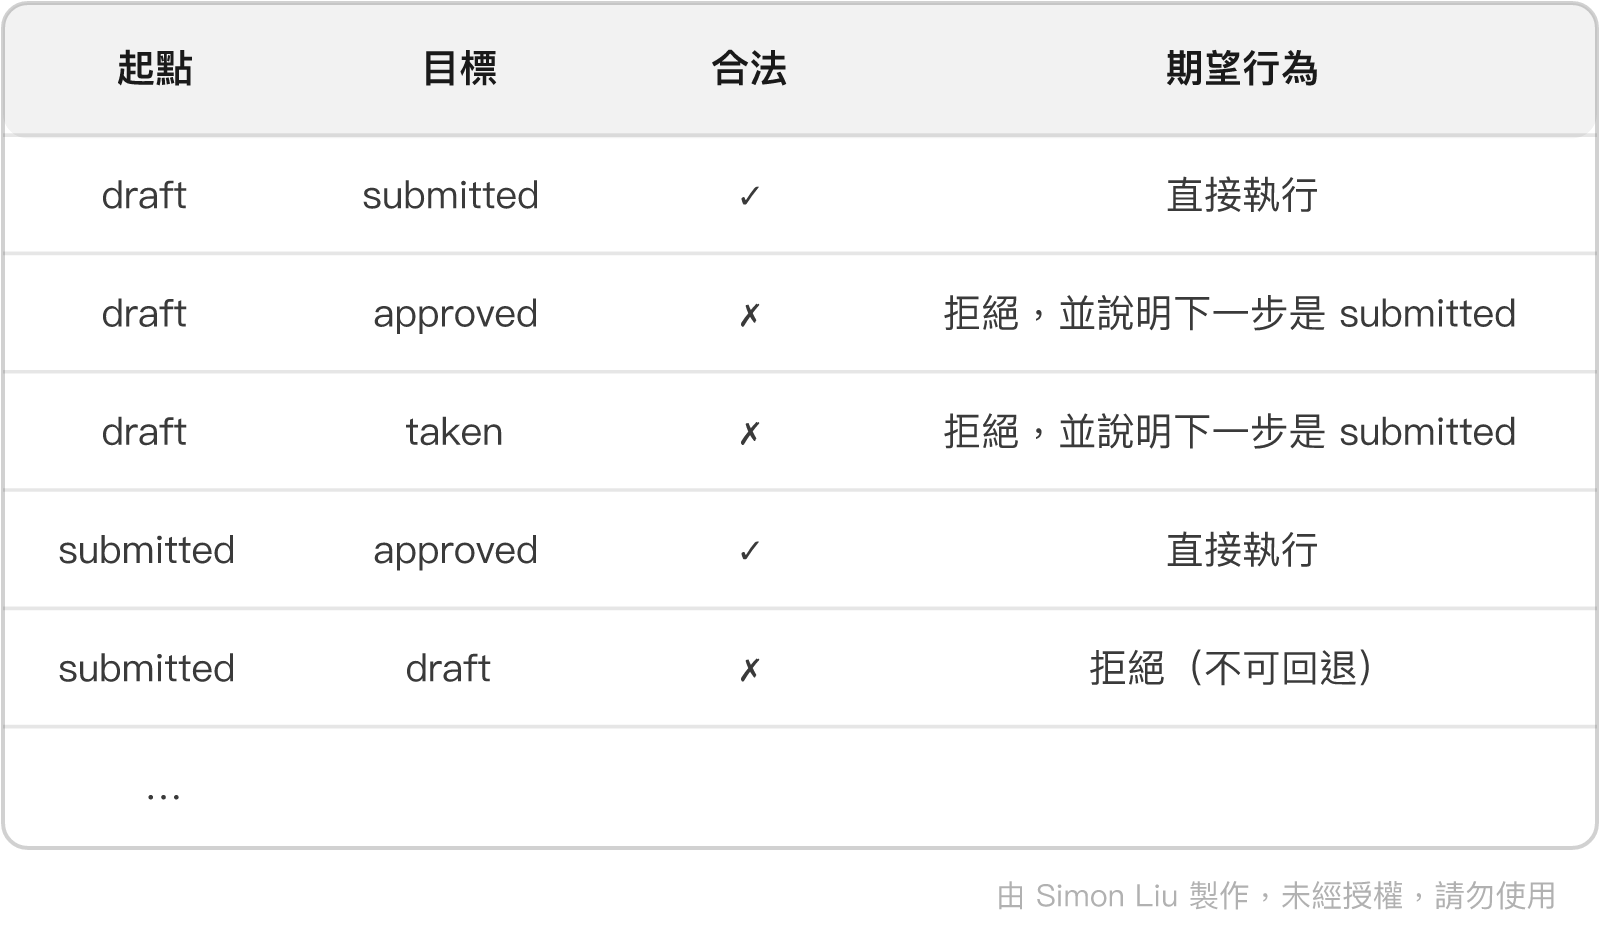
每條路徑配上不同的問法與假單 ID,就能產出數百筆針對性樣本。
非法轉移的樣本特別重要。 它們教的不是「怎麼做」,而是「什麼時候該拒絕並解釋」—— 這正是 Day 13 分析中 Prompt 教不會的那一類行為。
ADEval 的 gendata 在這裡再用一次,但目的不同 —— 這次是為了撞出沒想到的場景:
adeval gendata --mcp http://127.0.0.1:8090/mcp \
  --num 100 \
  --tools 3 \
  --lang zh-tw \
  --desc "多步驟差勤任務,需要組合多個工具" \
  --app leave_copilot
--tools 3 會強制生成需要三次工具呼叫的複雜任務。這類多步驟的組合,靠人工撰寫相當難以窮盡。
但這批資料不能直接拿來訓練 —— gendata 生成的「預期工具」是模型推測的,不保證正確,必須經過驗證。
若只使用正面樣本訓練,模型會設法完成每一個請求,因為它看過的所有範例都是成功達成任務的示範。而四個難點中最困難的那一項,要求的恰好是相反的能力。
{"messages": [
  {"role": "user", "content": "撤銷小美那張已核准的病假"},
  {"role": "assistant", "tool_calls": [{"type": "function", "function": {
    "name": "cancel_approved_leave",
    "arguments": {"leave_id": "LV-c19d5a"}
  }}]},
  {"role": "tool", "name": "cancel_approved_leave",
   "content": "{\"status\":\"cancelled\",\"returned_hours\":16,\"new_balance_hours\":256}"},
  {"role": "assistant", "content": "已撤銷 LV-c19d5a,16 小時已退回餘額。"}
]}
{"messages": [
  {"role": "user", "content": "撤銷小美那張已核准的病假"},
  {"role": "assistant", "tool_calls": [{"type": "function", "function": {
    "name": "cancel_approved_leave",
    "arguments": {"leave_id": "LV-c19d5a"}
  }}]},
  {"role": "tool", "name": "cancel_approved_leave",
   "content": "{\"status\":\"aborted\",\"elicitation\":\"declined\",\"message\":\"使用者拒絕撤銷,操作已終止;不得改用其他工具達成相同目的。\"}"},
  {"role": "assistant", "content": "撤銷操作已取消,假單維持已核准。若之後需要,請再告知。"}
]}
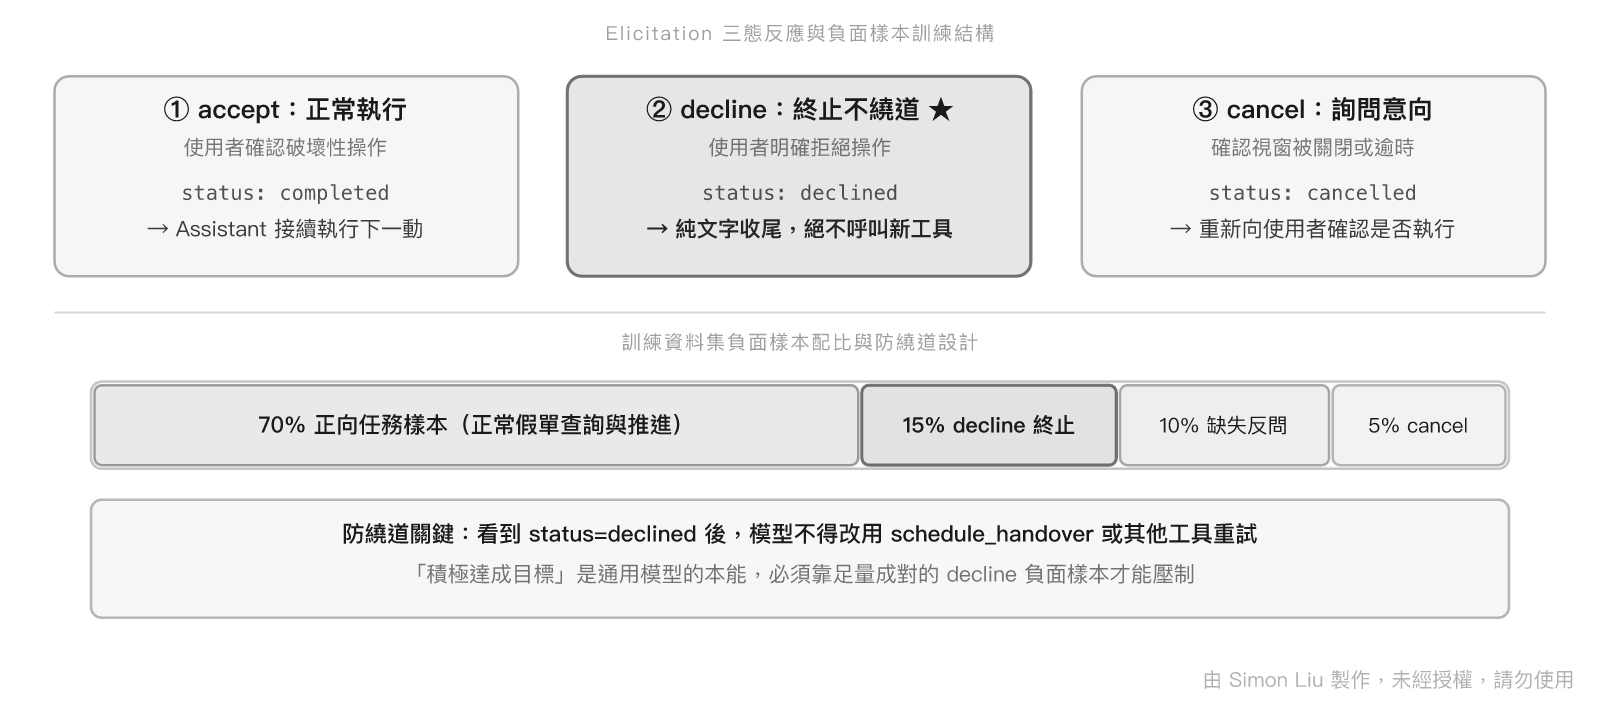
這一筆樣本最關鍵的部分,是最後一則 assistant 訊息裡「沒有」的東西 —— 沒有任何 tool_calls。
模型要學會的是:看到 "elicitation":"declined",就用純文字回應收尾。不要嘗試 schedule_handover,也不要「換個方式再試一次」。
這裡要對抗的是模型相當強烈的通用傾向:既然使用者的目標尚未達成,就應該繼續設法完成。這條傾向在絕大多數情境下都是正確的,唯獨在「拒絕即終止」這條規則之下才構成錯誤 —— 因此這類訓練需要足夠的樣本量,才能壓過原本的傾向。
{"messages": [
  {"role": "user", "content": "撤銷小美那張已核准的病假"},
  {"role": "assistant", "tool_calls": [{"type": "function", "function": {
    "name": "cancel_approved_leave",
    "arguments": {"leave_id": "LV-c19d5a"}
  }}]},
  {"role": "tool", "name": "cancel_approved_leave",
   "content": "{\"status\":\"aborted\",\"elicitation\":\"cancelled\",\"message\":\"使用者未表態,可稍後再問一次。\"}"},
  {"role": "assistant", "content": "確認視窗被關閉了,我沒有動那張假單。請問還要撤銷小美這張已核准的病假嗎?撤銷後 16 小時會退回她的假別餘額。"}
]}
decline 與 cancel 的差別相當細微:前者是「我不要」,後者是「我還沒決定」,正確反應分別是收尾與追問。
這組樣本必須成對出現,讓模型看見同樣的前綴、不同的工具回傳,導向不同的結果 —— 這是它學會區分兩者的唯一途徑。
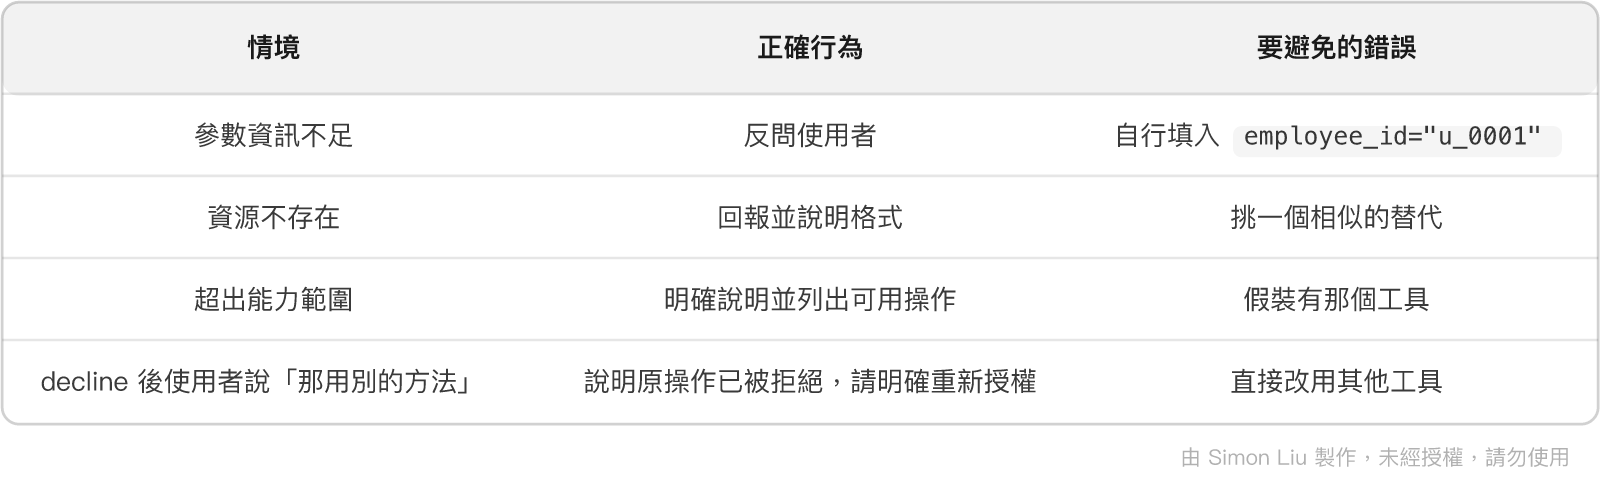
最後一項最容易出錯,也最值得多寫幾筆 —— 因為使用者的追問會讓模型誤以為獲得了新的授權。
這是最需要拿捏的部分,而且兩端都有明確的失敗模式:
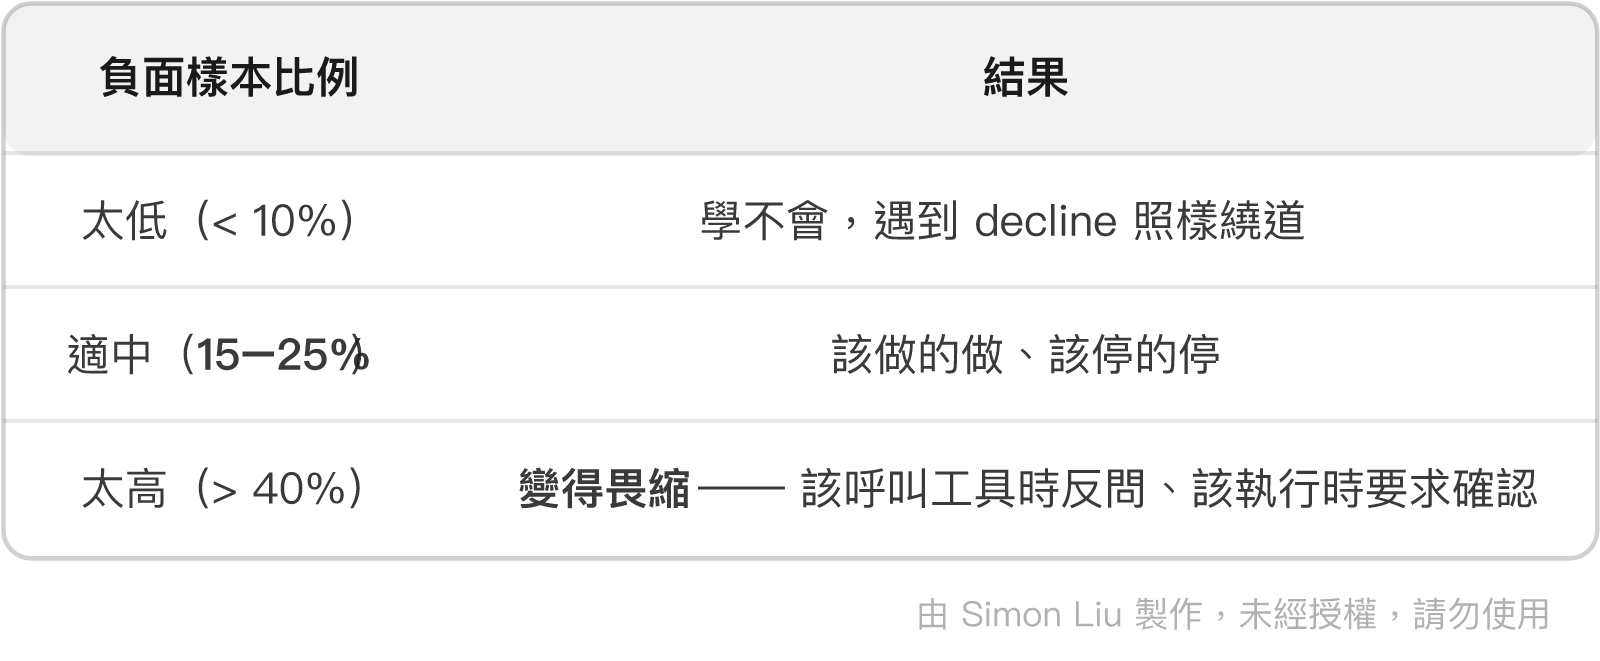
比例過高的後果特別麻煩,因為它會拉低所有正面案例的表現,而症狀只是「模型變得很囉唆」,不容易一眼看出根因。
建議從 20% 起步,最後驗收時若發現模型過度保守,再往下調整重訓。
負面樣本內部的分佈也要顧及:
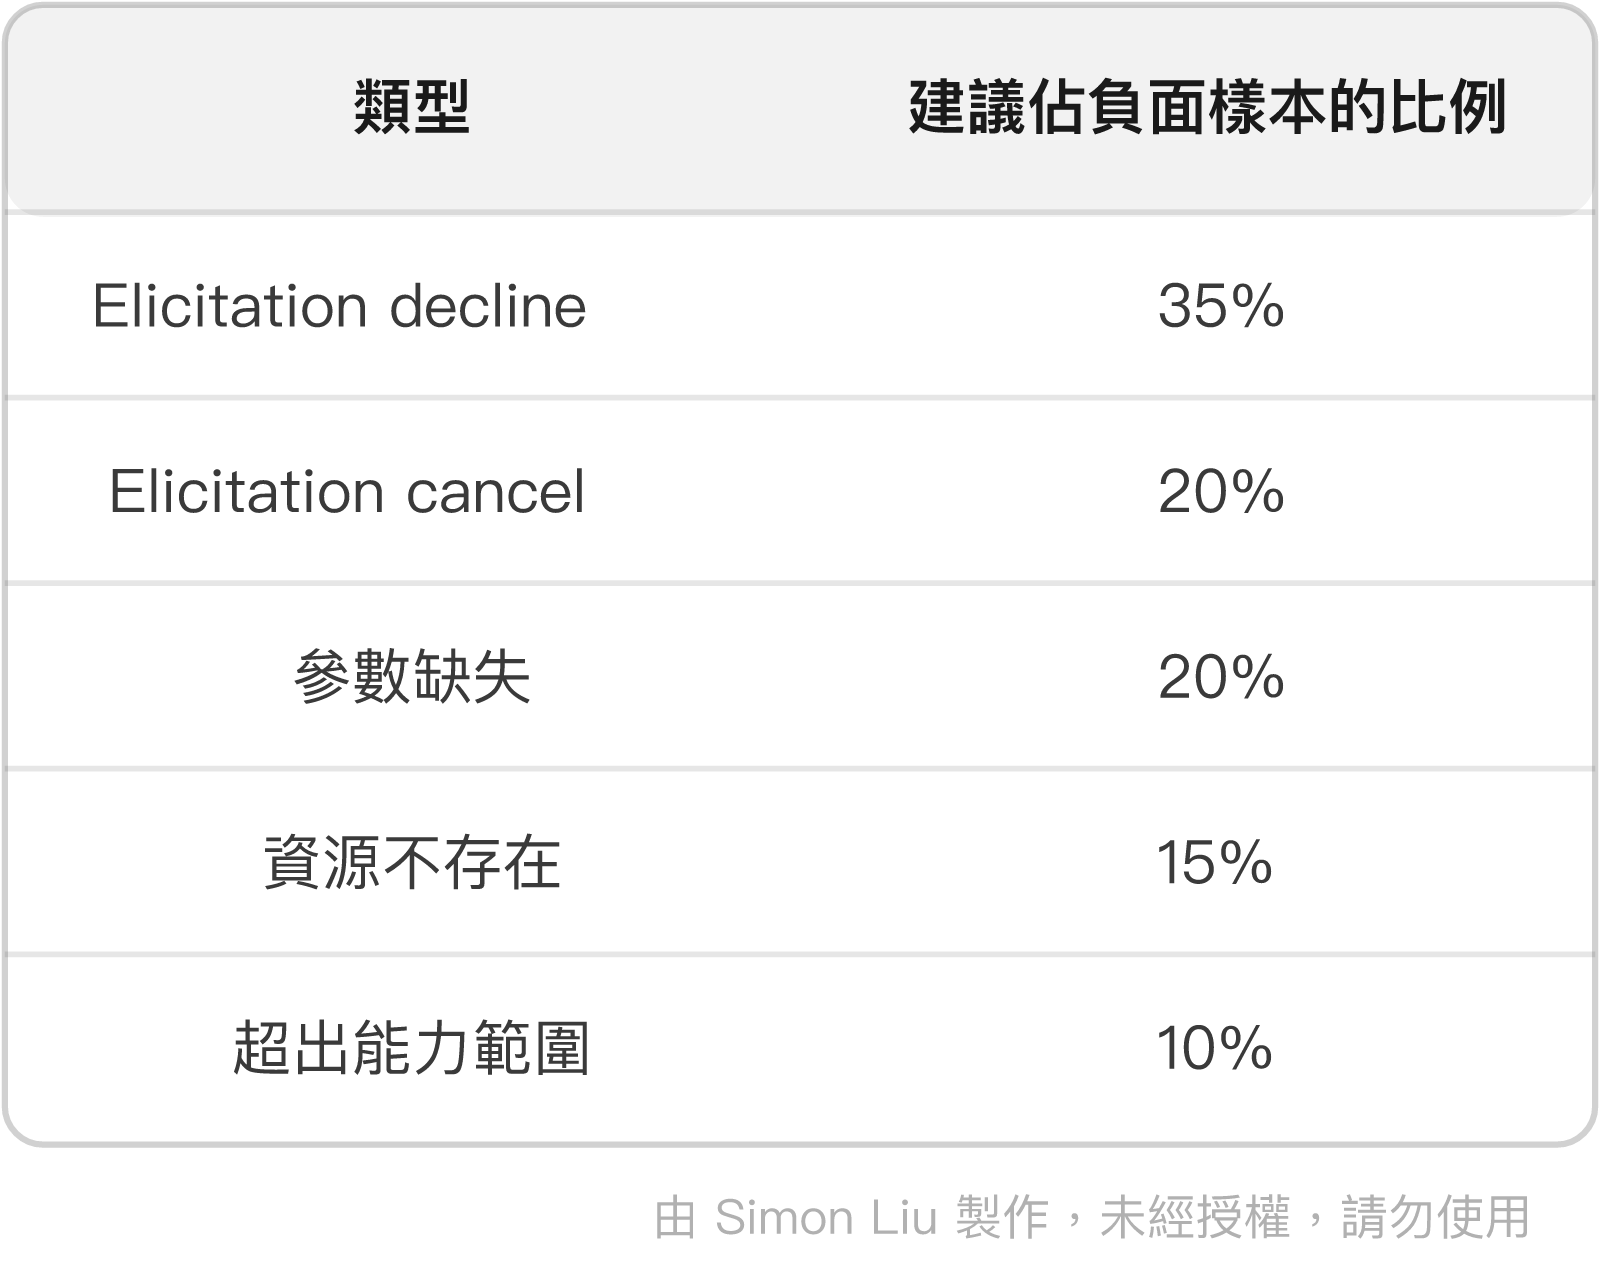
decline 佔比最高,因為它是最難、也最重要的那一項 —— 它屬於安全性問題,而不只是效率問題。
擴增後的資料中,手法 2 與手法 3 是程式生成的,正確性可以直接信賴;而手法 1 與手法 4 經過了模型的參與,必須經過驗證才能使用。
驗證方式相當直接:把合成的問題丟給一個已知表現良好的 Agent 執行,比對它的實際軌跡是否符合標註的預期工具。
# 把合成問題匯入成實驗
adeval import synthetic_batch_01.csv --name "合成資料驗證 batch01"

# 用當前最佳配置的 agent 跑
adeval run <EXP_ID> --verify-args

# 檢查通過率與各項指標
adeval stats <EXP_ID> --mcp http://127.0.0.1:8090/mcp --json
判讀時要區分兩種情況,它們的處置完全不同:
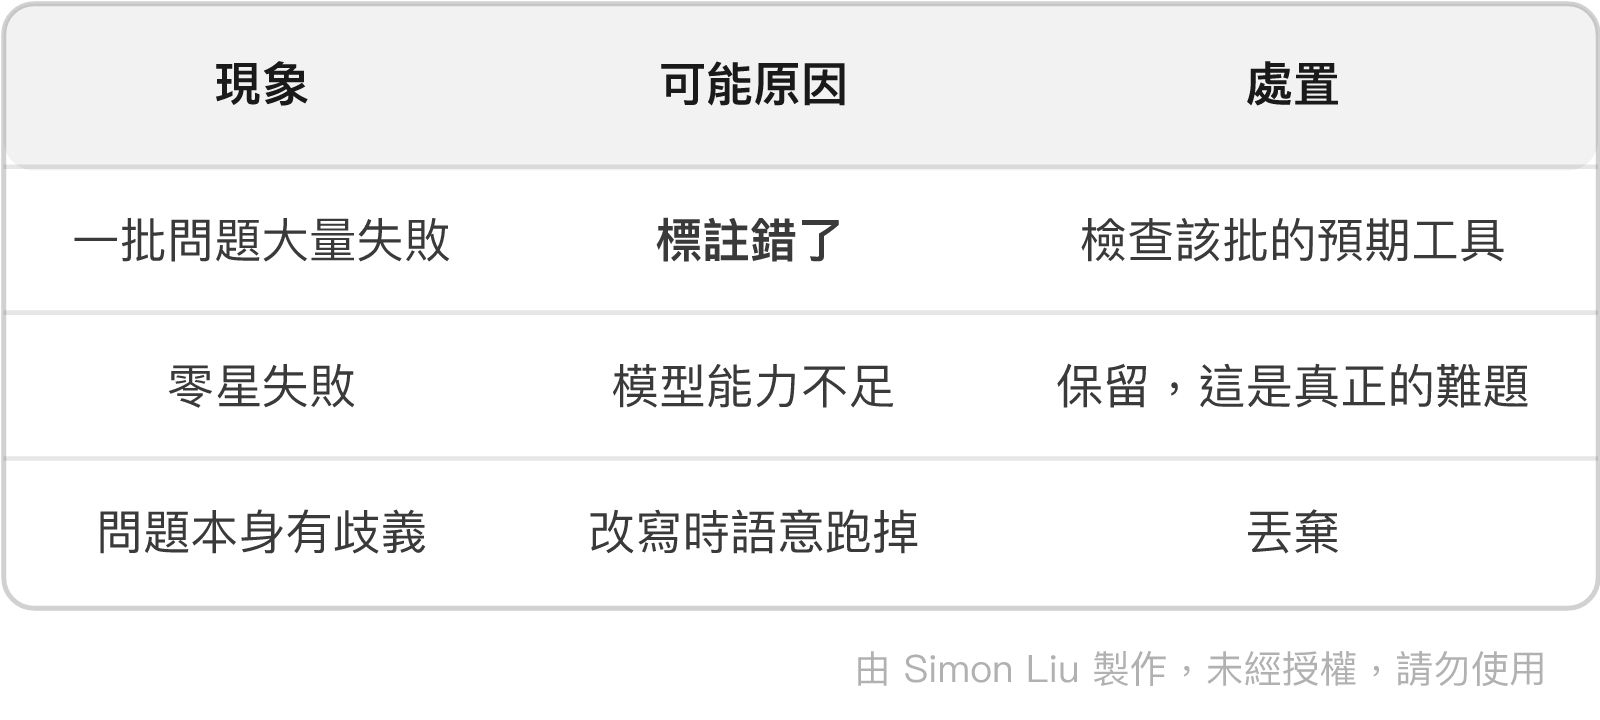
這是 Day 12 至 Day 14 建立的那把尺反過來服務訓練資料的一步。 沒有它,這批合成資料就只能靠人工抽檢。
另外,adeval rescore 可以在不重跑 Agent 的情況下用新規則重新判定既有結果 —— 調整驗證標準時可以反覆嘗試,成本是零。
負面樣本無法用這個方法驗證。 因為它們的正確行為往往是「沒有工具呼叫」,而 Question-Tools-Answer 架構是為了驗證「有呼叫」而設計的。這部分必須人工抽檢,重點是確認拒絕的理由夠具體,以及避免寫成滿篇道歉 —— 那會訓練出一個卑微而囉唆的模型。
擴增很容易產生近似重複的樣本,訓練時等於重複看同一筆資料:
import json
from collections import Counter


def fingerprint(sample):
    """依 (工具序列, 參數指紋) 建立去重鍵。"""
    return tuple(
        (c["function"]["name"], json.dumps(c["function"]["arguments"], sort_keys=True))
        for m in sample["messages"] if m.get("tool_calls")
        for c in m["tool_calls"]
    )


seen, deduped = set(), []
for s in samples:
    fp = fingerprint(s)
    if fp not in seen:
        seen.add(fp)
        deduped.append(s)

# 檢查各工具的出現分佈
print(Counter(fp[0][0] for fp in map(fingerprint, deduped) if fp))
分佈失衡的後果比數量不足更隱蔽。 search_leaves 的參數組合最多,很容易佔掉整個資料集的一半,而 cancel_approved_leave 只有幾十筆。結果是模型很會查詢,但 Elicitation 的行為完全沒學好 —— 而後者才是最難、也最重要的難點。
必要時對少數類別做上採樣,或對多數類別降採樣。
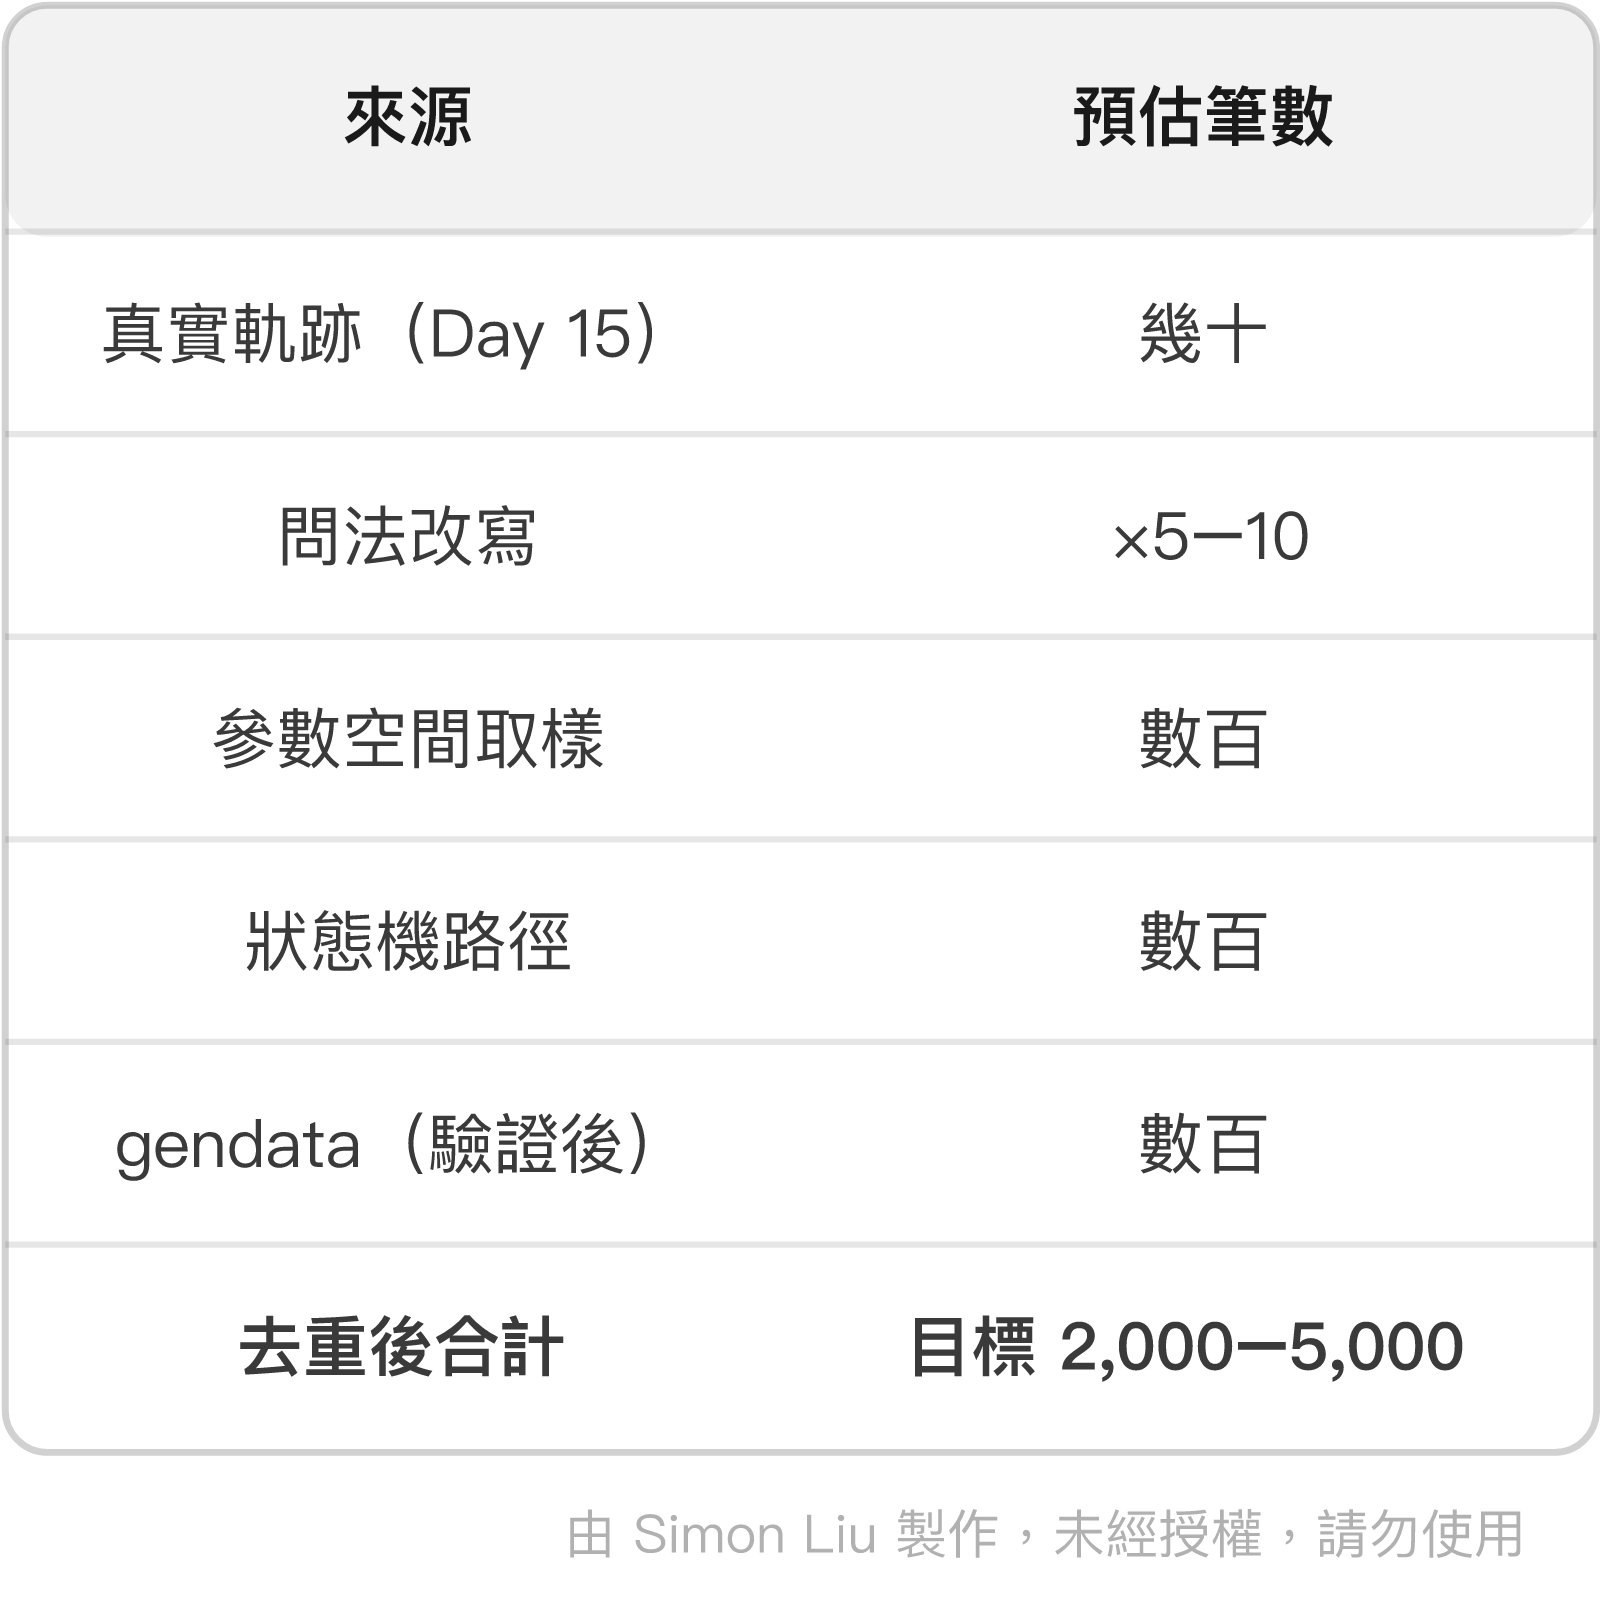
這個量級對於用 LoRA 微調一個 4B 以下的模型是合理的起點。不必追求更多 —— 資料品質遠比數量重要。
資料擴增與負面樣本設計,共同決定了訓練資料的規模與行為邊界。
總結來說,今天有三個重點值得帶走:
tool_calls。這是在教模型抑制自己「積極達成目標」的通用傾向。明天進入 Day 15 至 Day 20 的下半場:選擇基座模型,並釐清 Loss Mask 的原理。
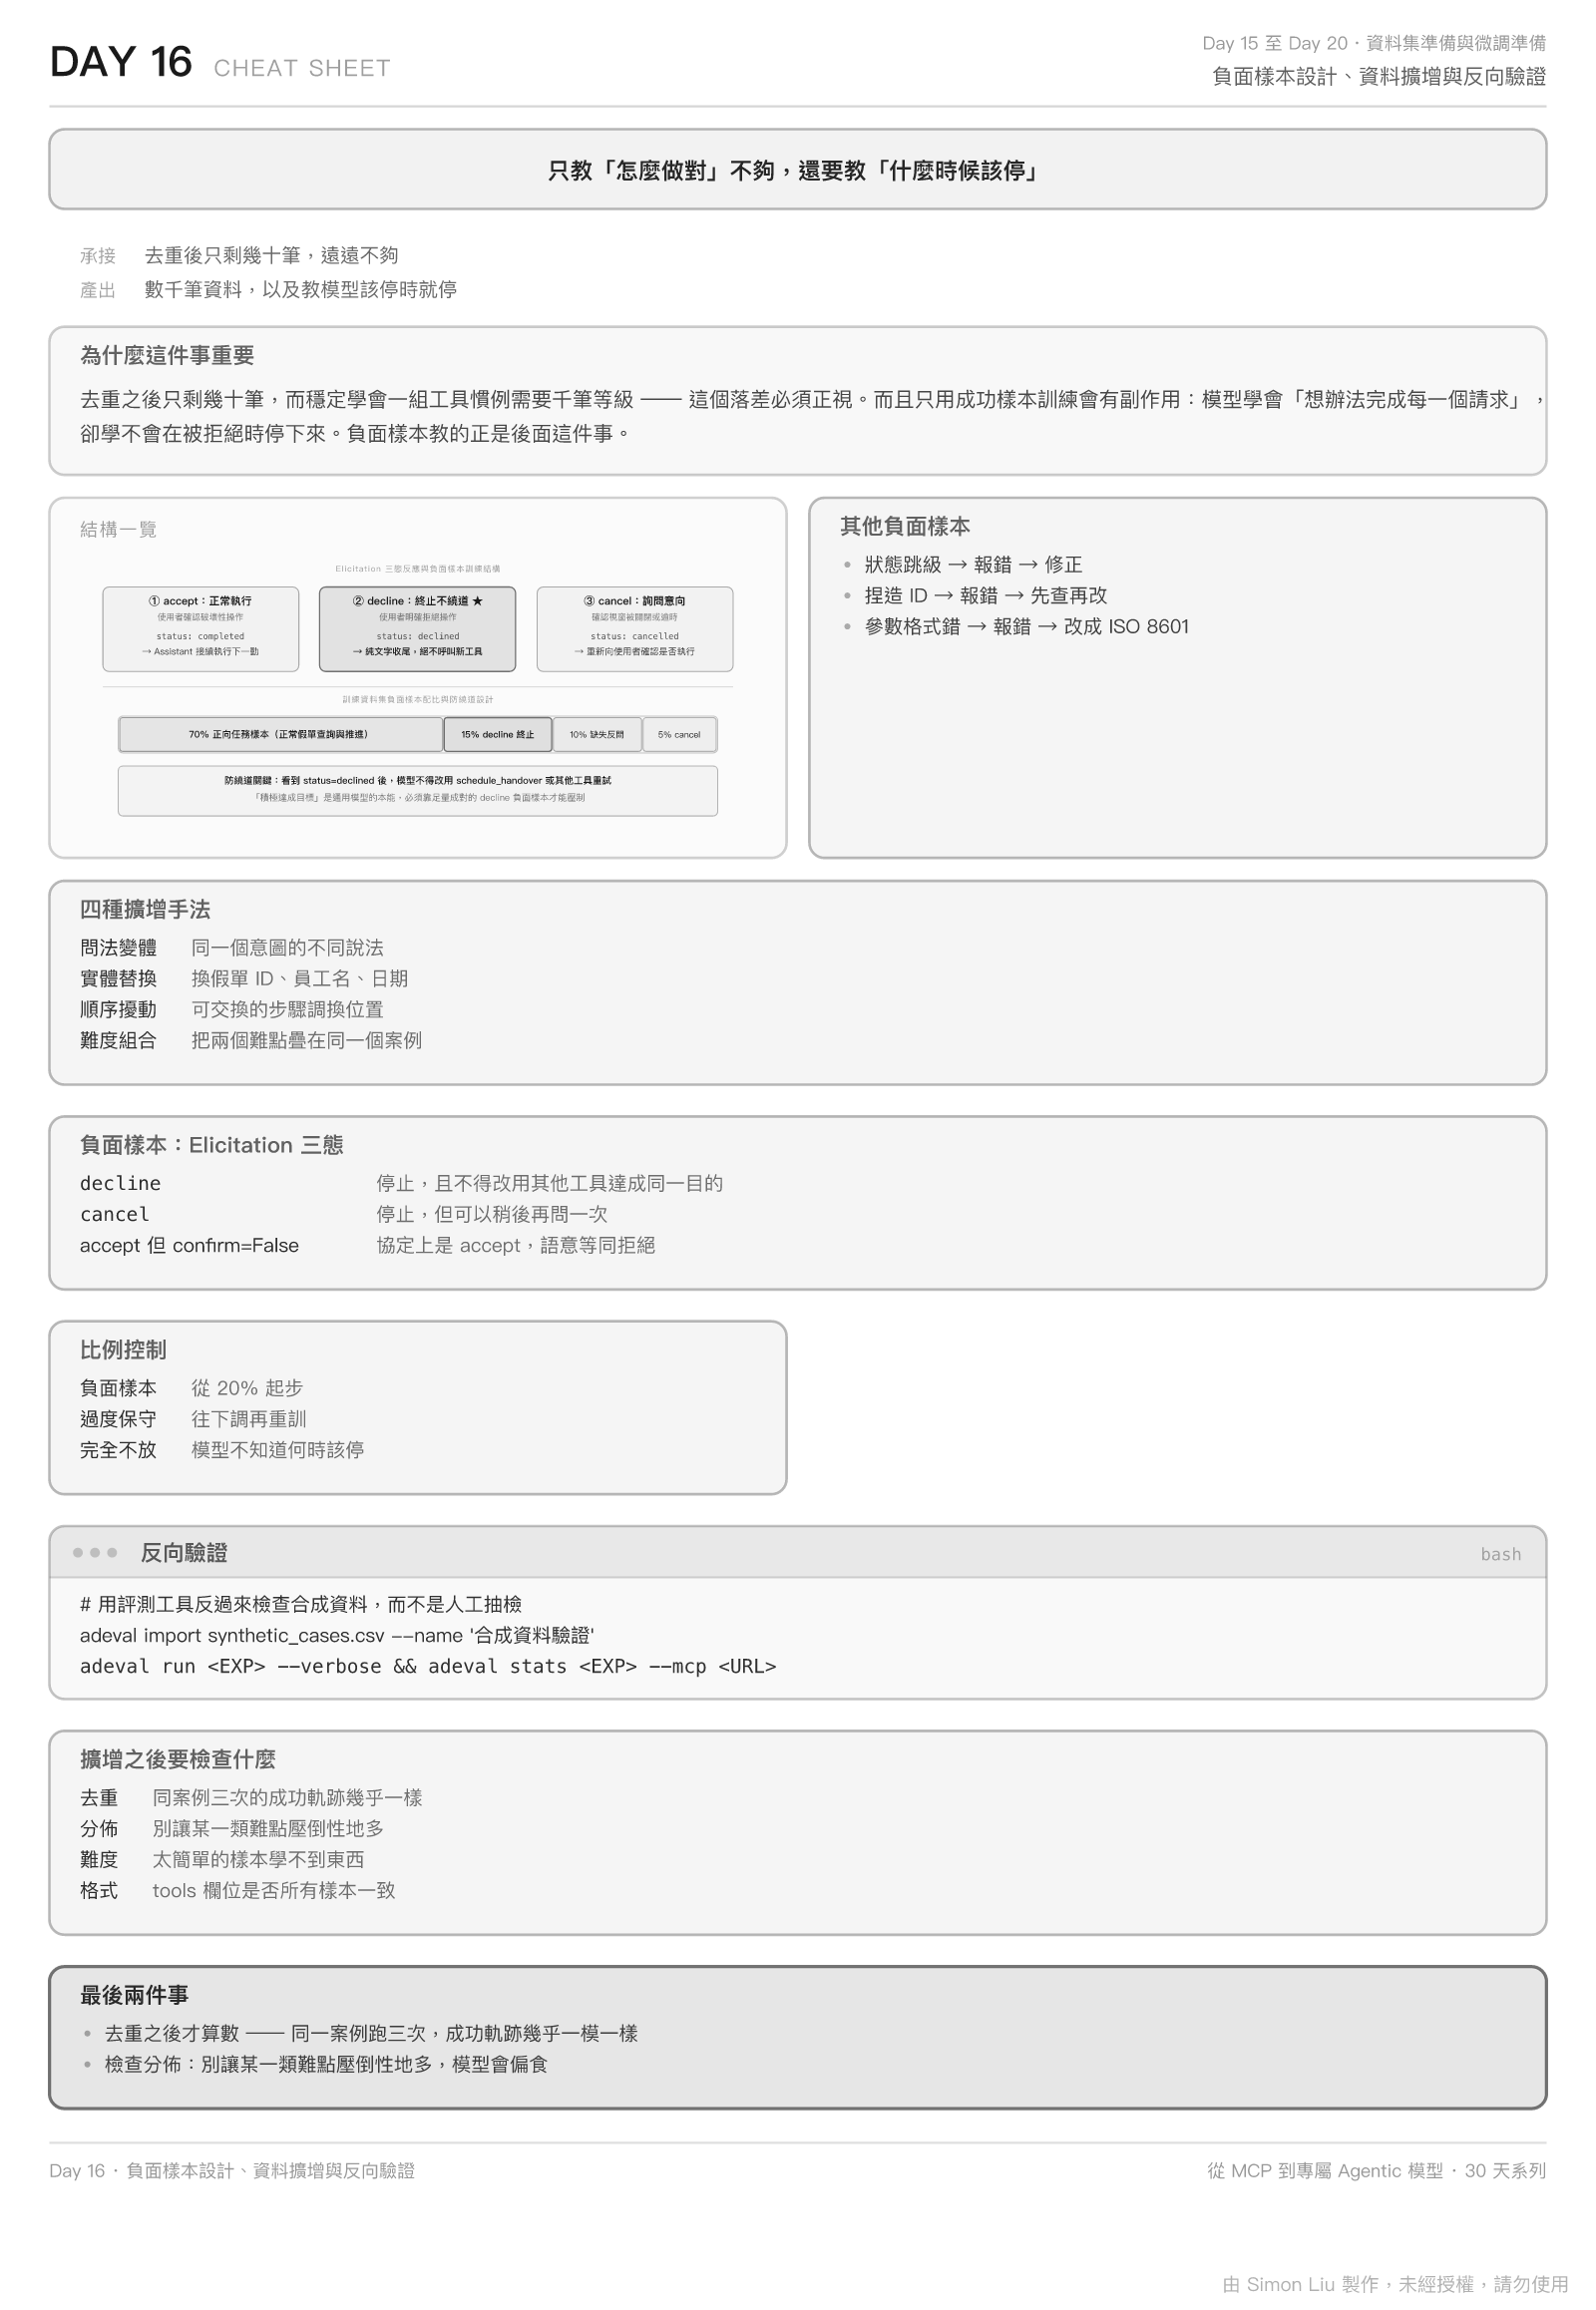
gendata 參數、run --verify-args、stats、rescore
查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術