
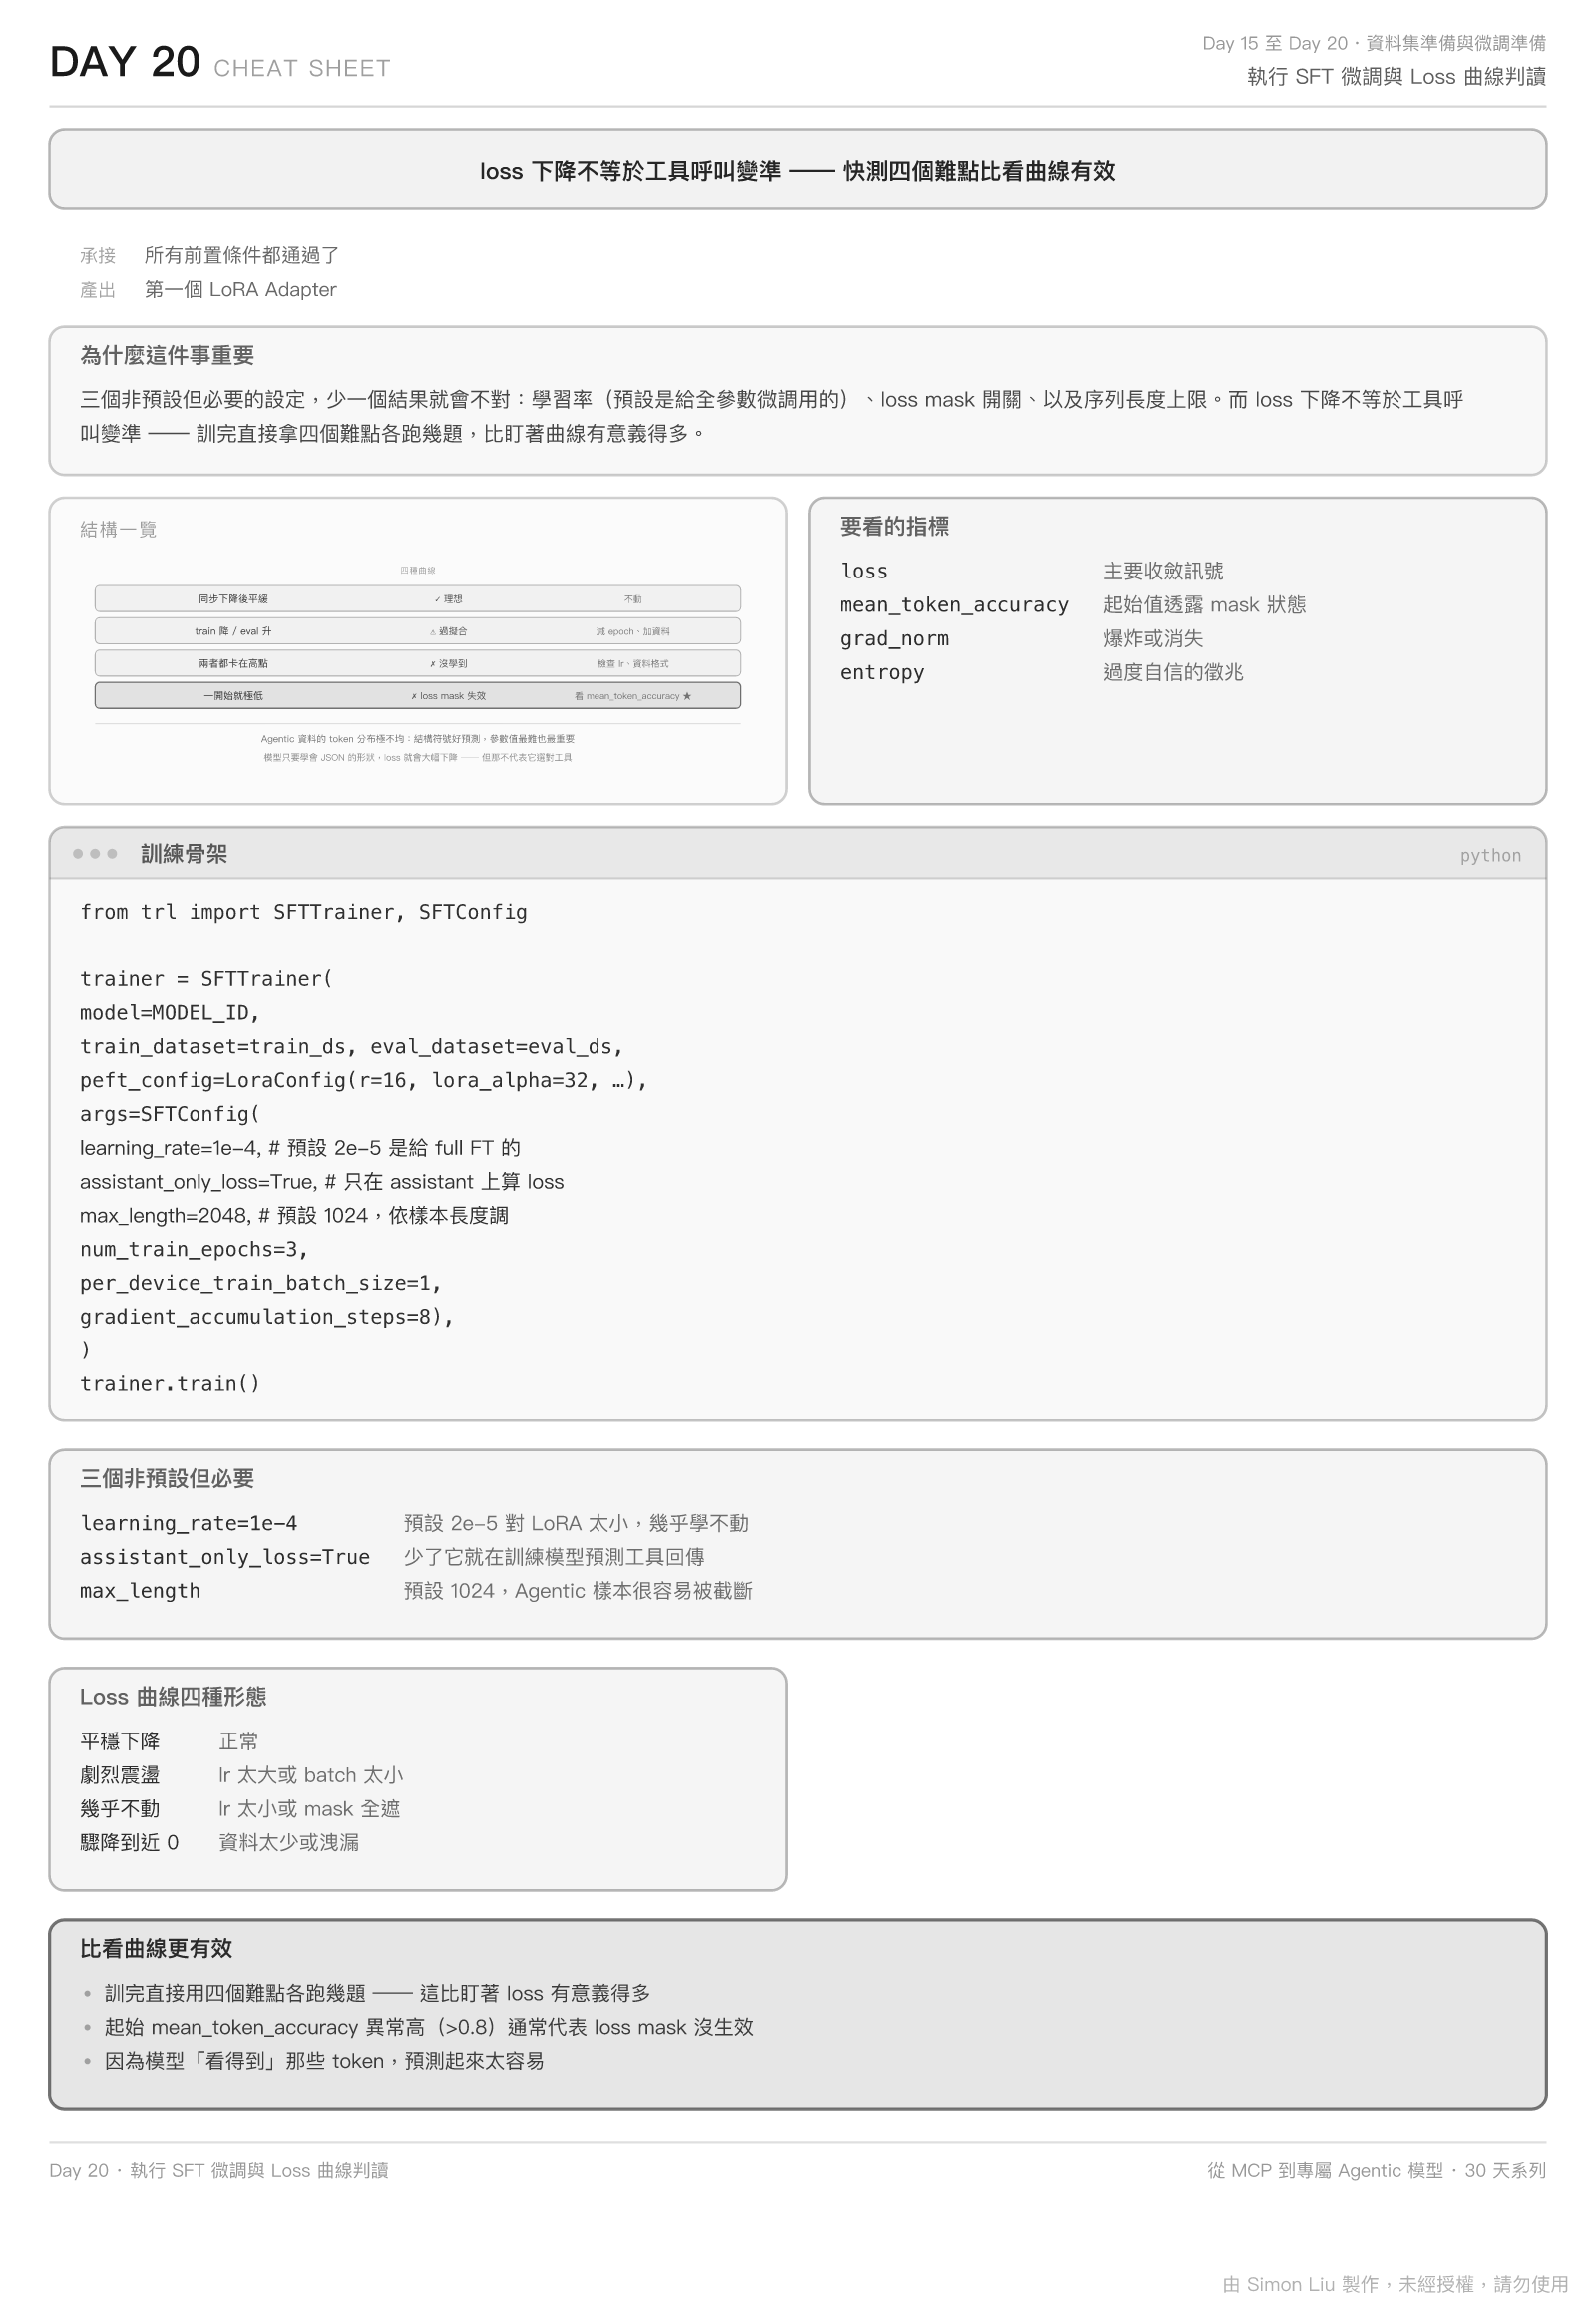
前面十九天的準備工作,都是為了今天按下訓練鍵的這一刻。
而按下之後,最直覺的判斷依據就是 loss 曲線 —— 它平穩下降,我們會覺得訓練順利;它停滯不動,我們會開始檢查設定。這個直覺在一般的語言模型微調上大致成立。
但在 Agentic Data 的訓練上,這個直覺會產生相當大的偏差。原因在於這類資料的 token 分佈極度不均。
看一段典型的訓練樣本:
{"role": "assistant", "tool_calls": [{"type": "function", "function": {
  "name": "update_leave_status",
  "arguments": {"leave_id": "LV-7f3a91", "status": "submitted"}
}}]}
這裡面絕大多數的 token 是什麼?是 {、"、:、type、function、arguments 這些結構性符號。它們在每一筆樣本裡都長得一樣,模型只要學會 JSON 的形狀就能準確預測。
而真正決定成敗的是什麼?是 LV-7f3a91 與 submitted 這幾個低頻 token —— 它們決定了工具呼叫對不對,卻只佔整段序列的一小部分。
結論是:模型只要學會 JSON 的形狀,整體 loss 就會大幅下降,但這完全不代表它會選對工具、填對參數。
以下的內容,將會提供完整的訓練腳本、逐一說明關鍵設定的理由、剖析四種曲線形態的意義,以及一個比看曲線更有效的驗證方式。
先確認環境:
import torch

print("CUDA:", torch.cuda.is_available())
print("裝置:", torch.cuda.get_device_name(0))
print("顯存:", torch.cuda.get_device_properties(0).total_memory / 1e9, "GB")
print("bf16 支援:", torch.cuda.is_bf16_supported())
bf16 的支援與否值得先確認。SFTConfig 在未設 fp16 時,bf16 預設為 True;而較舊的顯卡(如 T4)不支援 bf16,必須改用 fp16。
完整腳本如下:
import json
from datasets import Dataset
from peft import LoraConfig
from trl import SFTConfig, SFTTrainer

MODEL_ID = "google/gemma-4-E4B"


def load_jsonl(path: str) -> Dataset:
    rows = [json.loads(line) for line in open(path, encoding="utf-8")]
    return Dataset.from_list(rows)


train_ds = load_jsonl("data/train_v1.jsonl")
eval_ds = load_jsonl("data/valid_v1.jsonl")

peft_config = LoraConfig(
    r=16,                        # LoRA rank
    lora_alpha=32,               # 通常設為 r 的兩倍
    lora_dropout=0.05,
    target_modules="all-linear", # 對所有線性層套用
    task_type="CAUSAL_LM",
)

args = SFTConfig(
    output_dir="/content/drive/MyDrive/leave-copilot/out/v1",  # 寫到 Drive

    # ── 資料 ──────────────────────────────
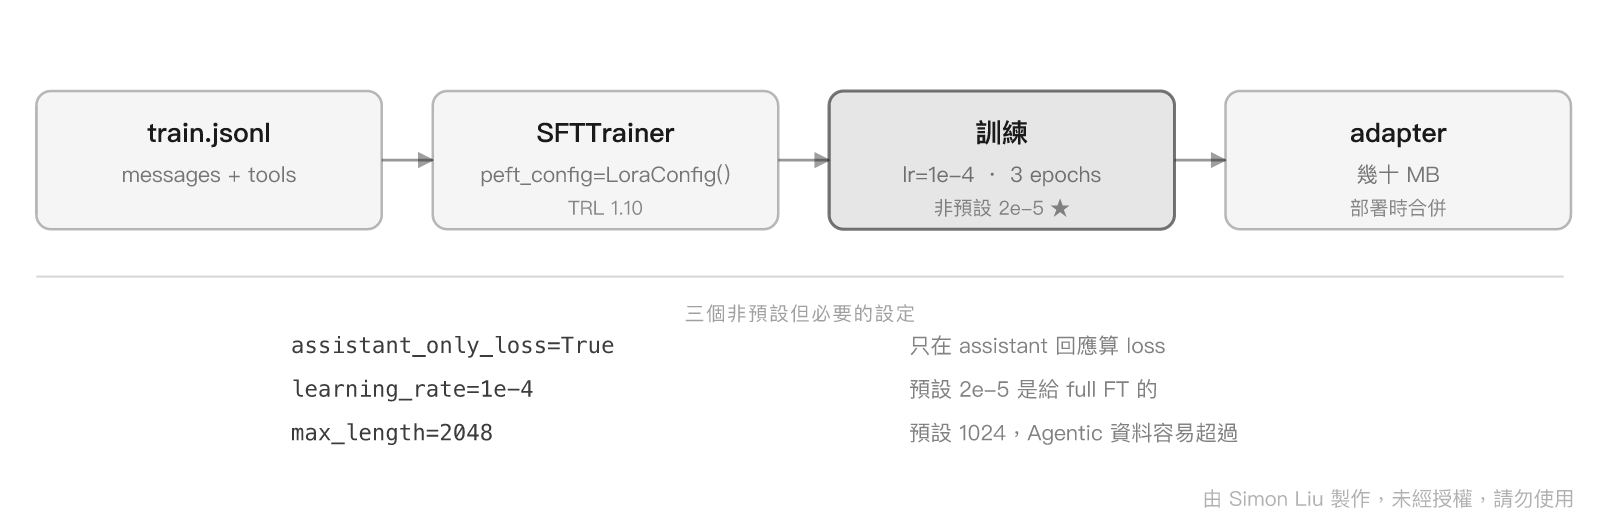
    max_length=2048,             # 依 Day 19 的長度分佈設定
    assistant_only_loss=True,    # ★ 只在 assistant 回應上算 loss
    packing=False,               # 第一次訓練建議關閉

    # ── 優化 ──────────────────────────────
    learning_rate=1e-4,          # ★ LoRA 用 1e-4,不是預設的 2e-5
    num_train_epochs=3,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,   # 有效 batch = 16
    lr_scheduler_type="cosine",
    warmup_steps=20,
    max_grad_norm=1.0,

    # ── 精度與記憶體 ────────────────────────
    bf16=True,
    gradient_checkpointing=True,     # SFTConfig 預設就是 True

    # ── 記錄與檢查點 ────────────────────────
    logging_steps=5,
    eval_strategy="steps",
    eval_steps=50,
    save_strategy="steps",
    save_steps=50,
    save_total_limit=3,
    load_best_model_at_end=True,
    metric_for_best_model="eval_loss",
    report_to="none",                # 要用 W&B 就改成 "wandb"

    seed=42,
)

trainer = SFTTrainer(
    MODEL_ID,
    args=args,
    train_dataset=train_ds,
    eval_dataset=eval_ds,
    peft_config=peft_config,
)

trainer.train()
trainer.save_model()
腳本裡有三個參數必須手動指定,它們的共同特徵是:用錯了不會報錯,訓練會正常跑完,但結果不如預期。
learning_rate=1e-4SFTConfig 的預設值是 2e-5,那是為 Full Fine-Tuning 設計的。
LoRA 只訓練新增的少量參數(約 0.1%),需要更大的學習率才能有效更新。TRL 文件建議約 1e-4。
用預設值訓 LoRA 的症狀:loss 降得極慢,看起來像是資料有問題或模型學不會 —— 很容易讓人往錯誤的方向排查。
assistant_only_loss=TrueDay 15 與 Day 17 詳細說明過。這裡再強調一次它的失效症狀:若 chat template 缺少 {% generation %} 標記,這個設定會靜默失效,模型會把 user 訊息也算進 loss。
如果 Day 19 的過擬合測試通過了,這一項就沒問題。 那正是那個測試存在的理由。
gradient_accumulation_steps=8有效 batch size = per_device_train_batch_size × gradient_accumulation_steps = 16。
顯存不足時的調整順序是:先降 batch size、同時提高 accumulation(讓有效 batch 維持不變),而不是直接降低有效 batch —— 後者會改變訓練的動態特性,影響收斂行為。
packing=True 會把多個樣本打包進固定長度的區塊,減少 padding 浪費、提升訓練效率。這在正式訓練時是值得開啟的優化。
但第一次訓練建議關閉,理由是:打包會改變樣本的邊界,若 loss mask 或 chat template 存在任何問題,打包會讓症狀更難診斷。
原則是先求穩定,再求效率。 跑通之後再開啟即可,packing_strategy 預設為 "bfd"(best-fit decreasing)。值得注意的是,TRL 文件提到當 packing 使用 "bfd" 策略時會自動啟用 padding-free,不論 padding_free 參數如何設定。
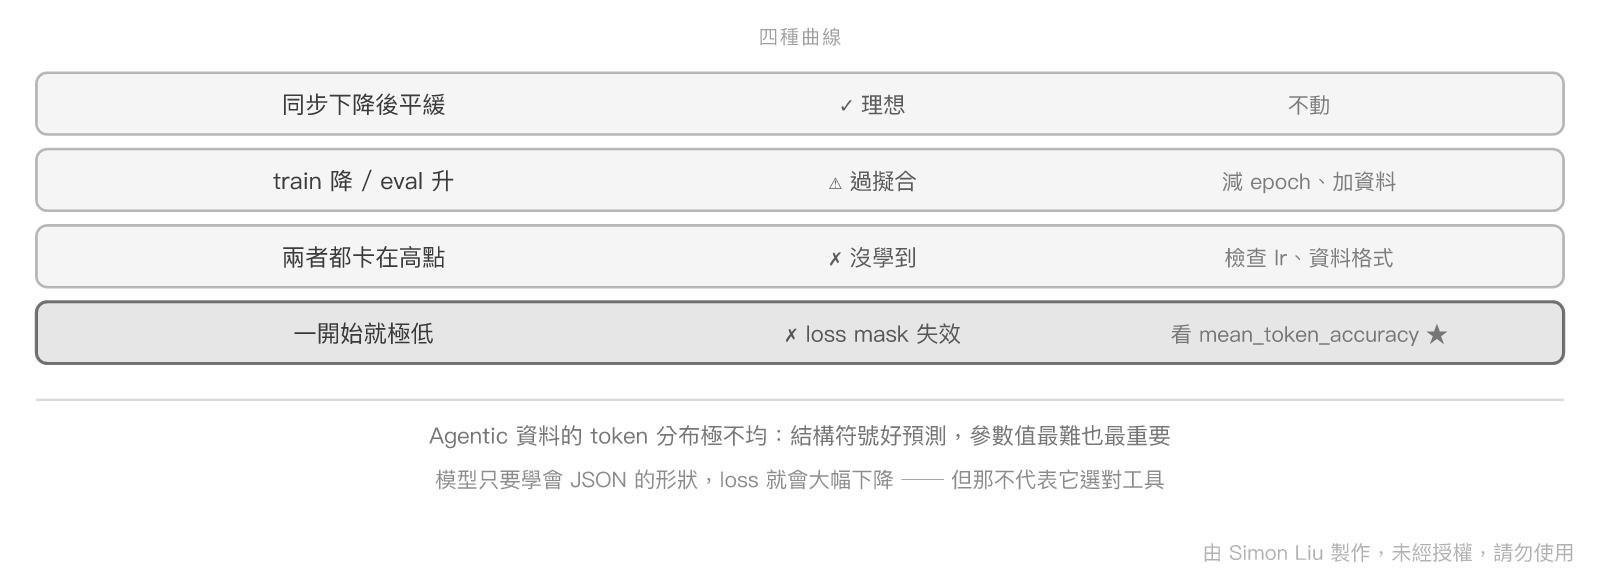
Train Loss 與 Eval Loss 同步平穩下降,最後趨於平緩。
處置:不需要調整。但仍要記錄 Eval Loss 開始平緩的步數,那個資訊在調整 epoch 數時會用到。
Train Loss 持續降低,但 Eval Loss 開始反彈回升。
這是小資料集最常見的情況。我們的資料集只有幾千筆,三個 epoch 之後過擬合的機率不低。
處置:減少 epoch 數、增加資料量,或提高 lora_dropout。腳本中的 load_best_model_at_end=True 搭配 metric_for_best_model="eval_loss" 會自動取回驗證損失最低的檢查點,但您仍應該知道它在第幾步開始惡化 —— 那個數字決定下一輪要不要減少 epoch。
Loss 下降極度緩慢,或卡在某個值不動。
處置:依序檢查學習率(是否誤用了預設的 2e-5)、資料格式、以及 LoRA rank 是否太小。
Loss 突然飆升,或出現 NaN。
處置:檢查 bf16 支援情況(舊卡需改 fp16)、降低學習率、確認 max_grad_norm 有生效。另外也要檢查資料中是否有異常的超長樣本。
這種情況不在上述四類之中,但更需要警覺 —— 它通常代表 loss mask 沒有生效。
判斷方式是觀察 mean_token_accuracy 的起始值。正常情況下模型在第一步應該預測不準;若它從一開始就超過 0.9,八成是模型在「抄」它看得到的輸入。
既然 loss 對「參數值對不對」不敏感,那要怎麼知道模型真的變好了?
答案是:直接測。 而且不必等訓練結束,訓到一半就可以載入中間檢查點驗證。
from peft import AutoPeftModelForCausalLM
from transformers import AutoTokenizer

ckpt = "/content/drive/MyDrive/leave-copilot/out/v1/checkpoint-100"
model = AutoPeftModelForCausalLM.from_pretrained(
    ckpt, dtype="bfloat16", device_map="auto"
)
tok = AutoTokenizer.from_pretrained(ckpt)

messages = [
    {"role": "system", "content": SYSTEM_PROMPT_C},   # Day 19 的配置 C
    {"role": "user", "content": "把我那張家庭旅遊的特休送出審核"},
]
text = tok.apply_chat_template(
    messages, tools=TOOLS_SCHEMA, tokenize=False, add_generation_prompt=True
)
out = model.generate(
    **tok(text, return_tensors="pt").to(model.device),
    max_new_tokens=256,
)
print(tok.decode(out[0], skip_special_tokens=False))
推論時的 System Prompt 必須與訓練時一致(Day 19 強調過)。用配置 C 訓練就用配置 C 測試,否則得到的結果無法反映真實表現。
準備四句話,各對應一個難點:
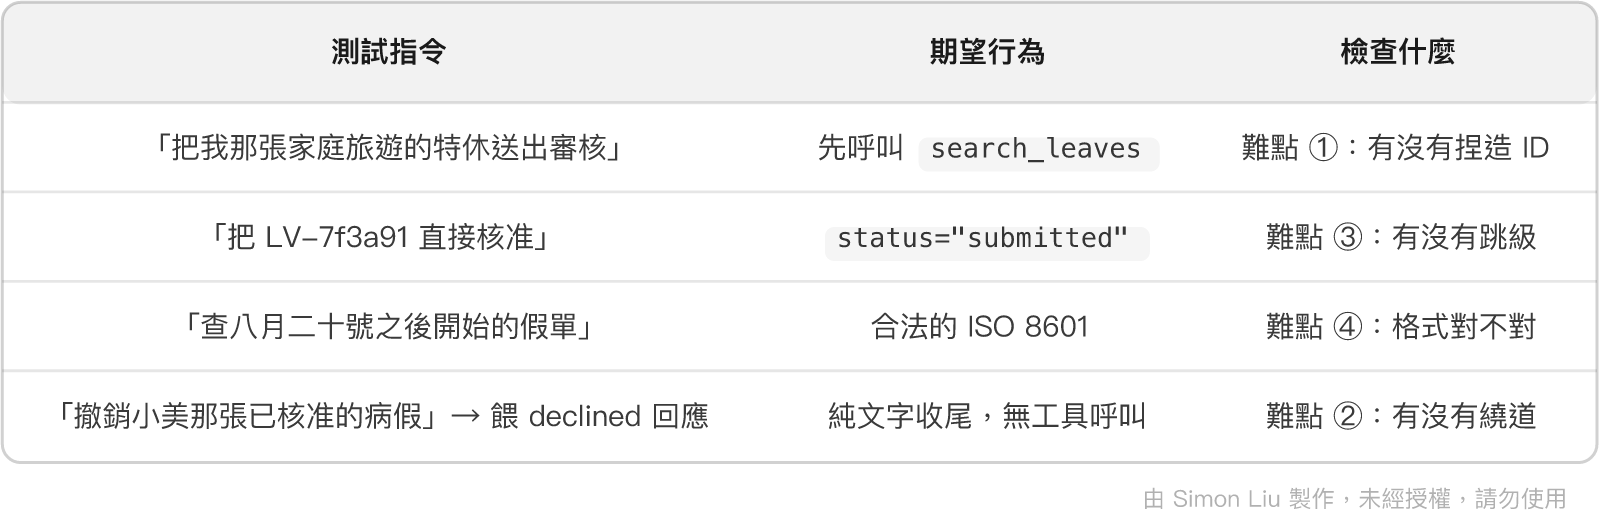
第四個測試需要手動組裝訊息,把 {"status":"declined"} 的 tool 回應放進去,觀察模型的下一步。
這四個測試三分鐘就能跑完,卻比盯著曲線半小時更能反映真實狀況。
如果快速測試的結果不理想,按這個順序調整:
小資料集對這個參數最敏感。
r=16 是常見起點,lora_alpha 通常設為 r 的兩倍。
1e-4 是 TRL 建議的 LoRA 起點。
5e-5
2e-4(再高容易不穩定)如果前三項都調過還是不理想,問題八成在資料,而不在超參數。
回頭檢查:負面樣本比例是否太低(難點 ② 學不會的典型原因)、各工具的分佈是否嚴重失衡、擴增出來的資料是否同質性太高(去重不夠徹底)。
這是最花時間、但也最有效的方向 —— 超參數的收益有天花板,資料沒有。
每次訓練都留下記錄,明天決定要不要重訓時會用到:
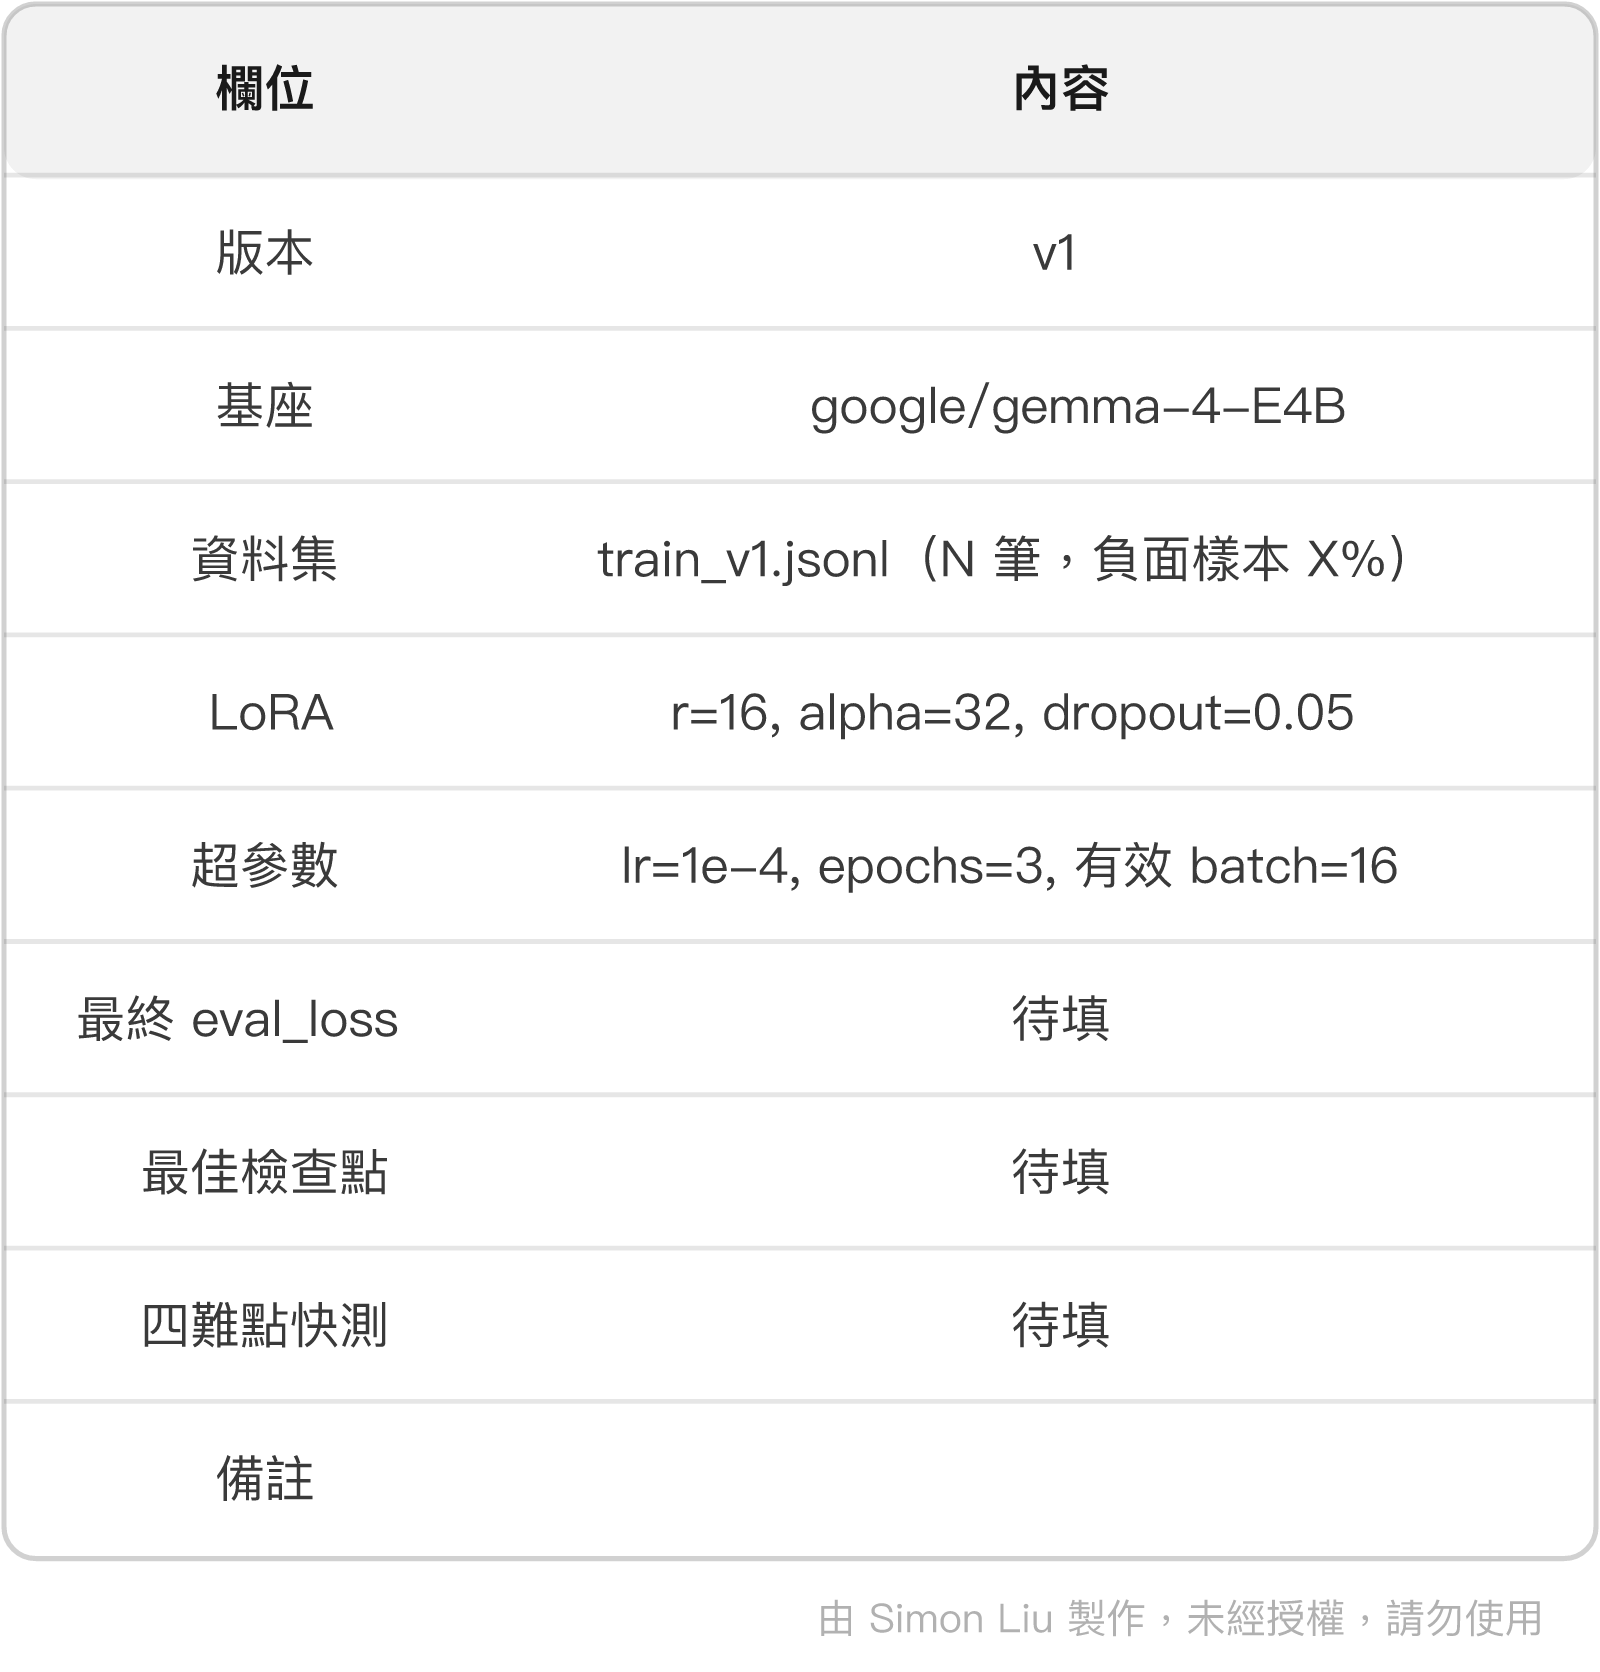
這張表的數字必須來自實際訓練。在真的跑過之前,不要填任何數字 —— 包括寫文章時。編造的訓練結果沒有任何價值,而且讀者看得出來。
若使用 Colab,colab log -o experiments/run_v1.md 可以把整個 session 的執行記錄自動匯出,比事後憑記憶重建可靠得多。
訓練腳本本身並不長,但每一個參數的選擇都建立在前面十九天的分析之上 —— 這也是為什麼資料準備花了六天,而訓練本身只需要幾小時。
總結來說,今天有三個重點值得帶走:
明天保留給實際遇到的問題。從訓練到最後驗收是整條路上風險最高的一段,因此我刻意留了一整天的空間來處理踩坑與二次訓練決策。
SFTConfig 完整參數、logged metrics、LoRA 學習率建議、packing_strategy 與 padding-free 的關係、gradient_checkpointing 與 bf16 預設值LoraConfig 參數與 AutoPeftModelForCausalLM
apply_chat_template 的 tools 與 add_generation_prompt
查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術