
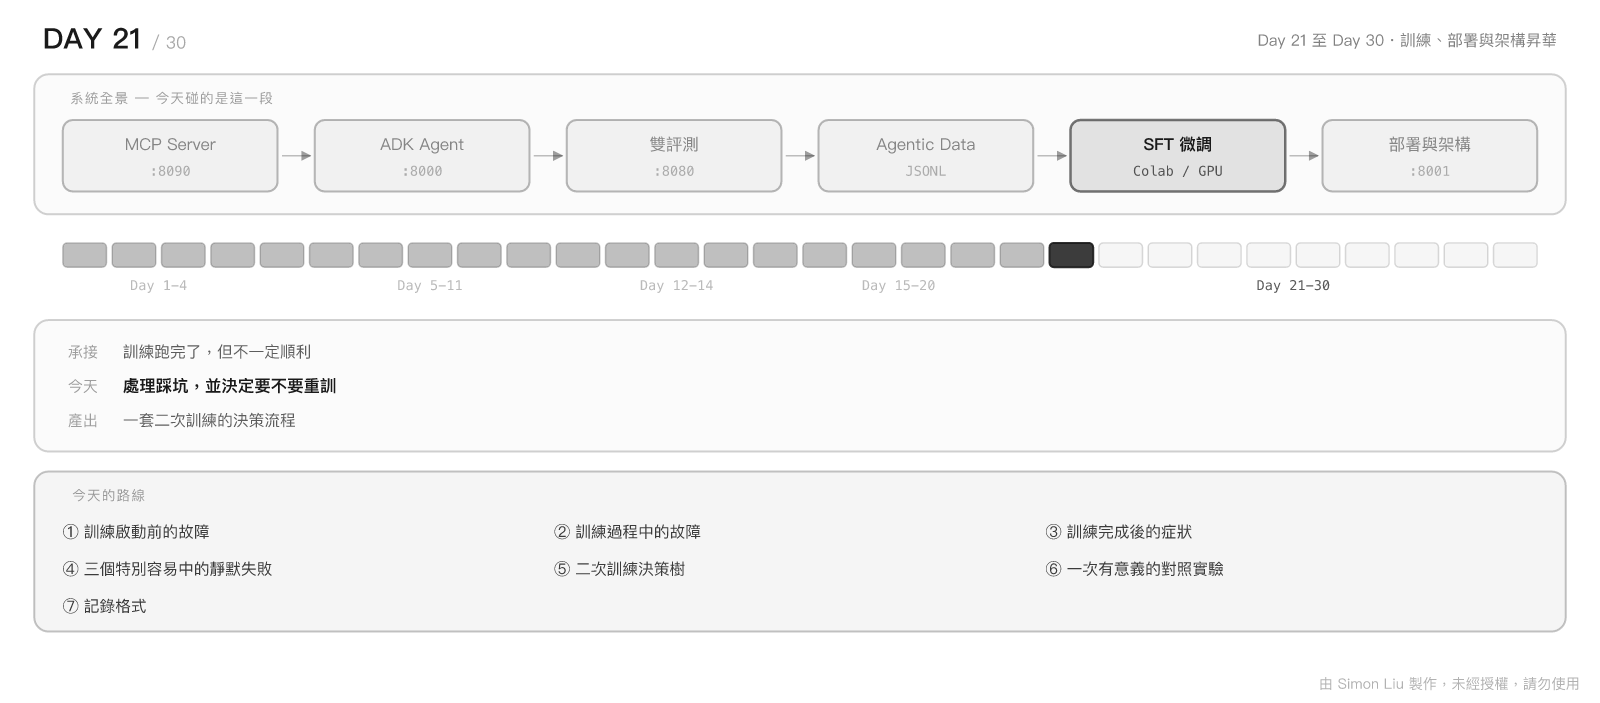
在規劃這個 30 天系列時,這一天的位置是刻意安排的。
從訓練到最後的驗收,文章能不能順利產出,取決於一件我無法完全控制的事:實驗跑不跑得出來。訓練失敗、顯存不足、資料格式錯誤、GPU 資源排不到 —— 任何一項都會讓進度停滯,而連載本身是不能中斷的。
因此這一天被設計成緩衝:無論訓練成功或失敗,都有內容可以分享。
但更重要的是,這一天處理的問題有一個共同特徵,而那個特徵才是它值得單獨成篇的原因:
微調過程中的失敗,大多不是模型能力問題,而是管線設定問題。而這類問題最麻煩的地方在於 —— 它們不會拋出任何異常。
程式正常執行、loss 正常下降、訓練正常結束,一切看起來都很順利,直到您實際測試模型,才發現它什麼都沒學到。
以下的內容,將會依照「訓練前 / 訓練中 / 訓練後」三個階段整理故障診斷表,深入剖析三個最容易中的靜默失敗,並提供一套判斷「要不要重訓」的決策流程。
這個階段的錯誤通常會直接拋出異常,相對容易處理。
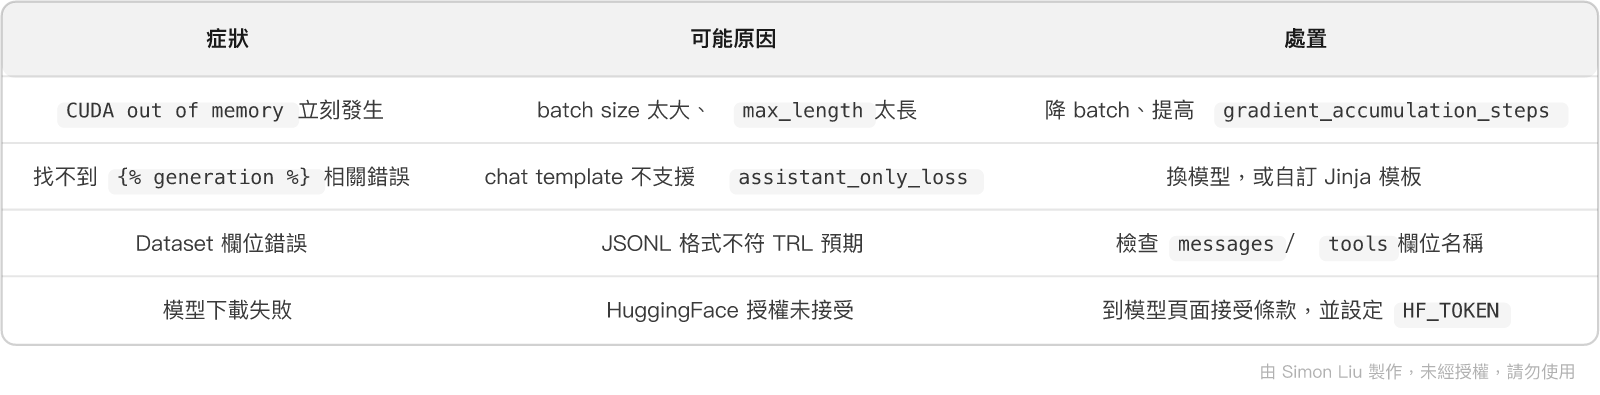
CUDA out of memory 是最常見的一個。調整時建議依序嘗試:
per_device_train_batch_size,同時提高 gradient_accumulation_steps —— 讓有效 batch size 維持不變,訓練動態不受影響。packing=True —— 減少 padding 造成的浪費。padding_free=True —— 需要 FlashAttention 2 或 3。gradient_checkpointing 在 SFTConfig 中預設就是 True(與 TrainingArguments 不同),這已經幫您省下不少顯存,代價是訓練速度略慢。
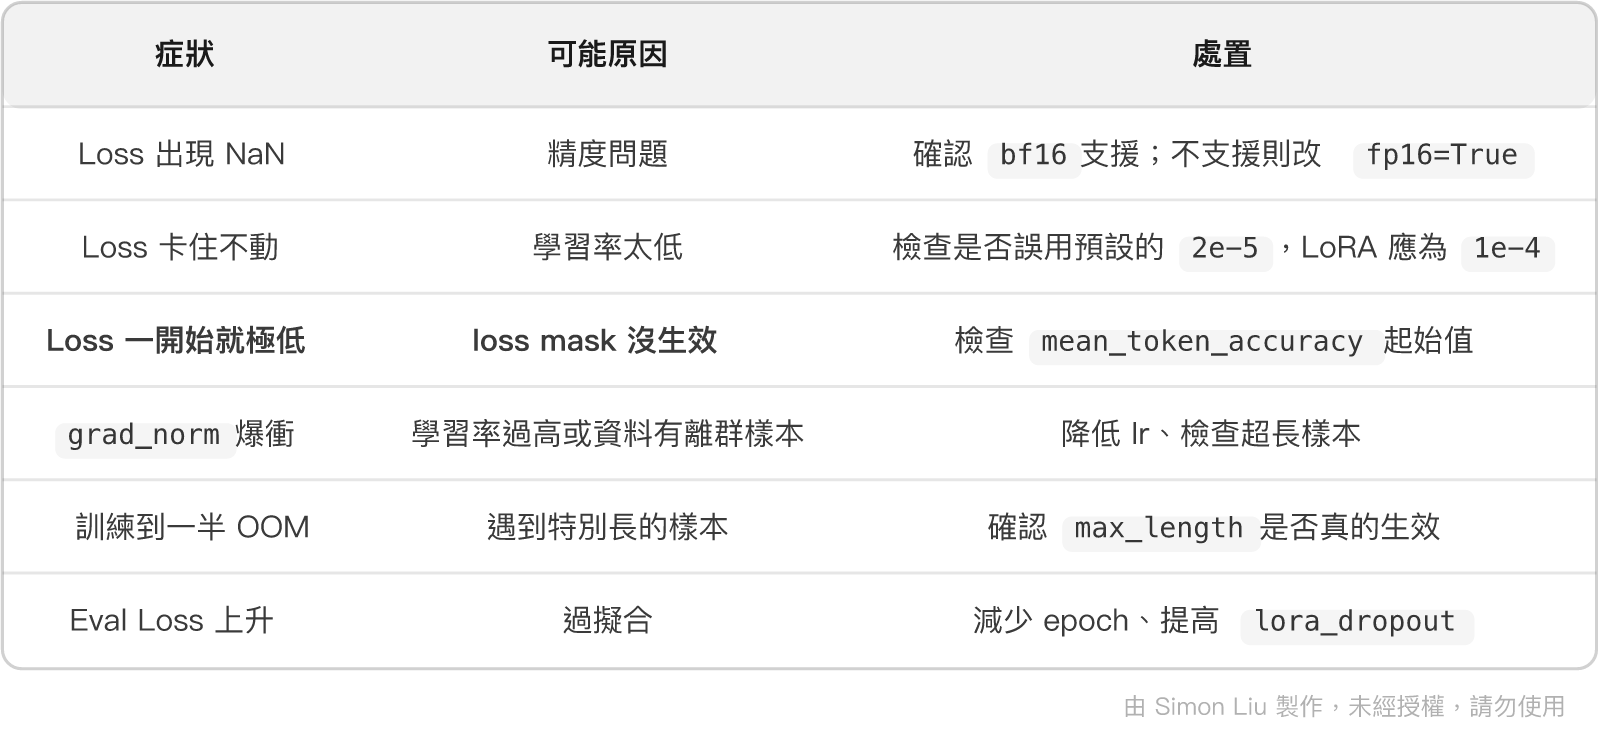
這個階段的問題最難診斷,因為訓練本身「成功」了。
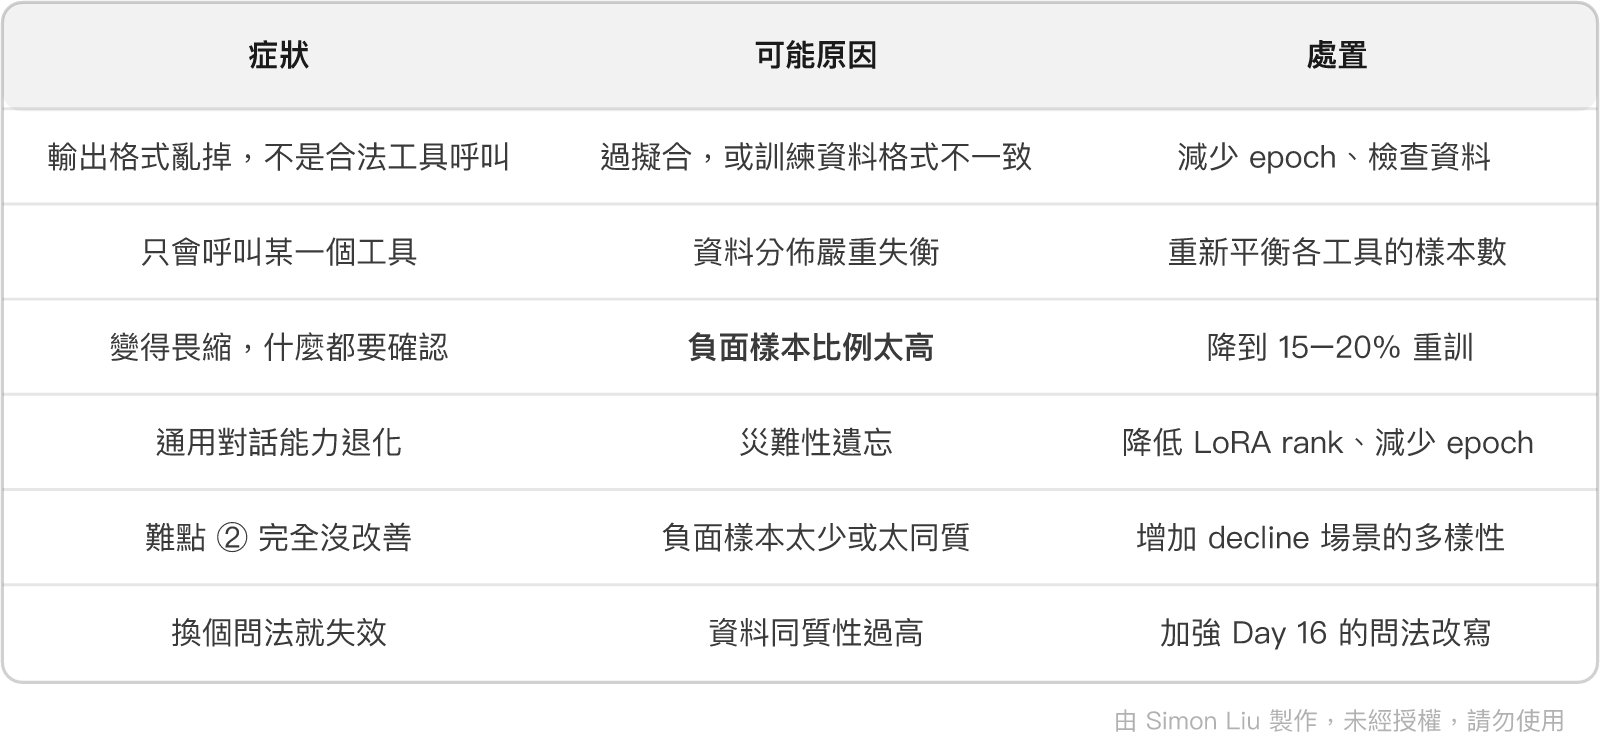
其中「通用對話能力退化」這一項,正是 Day 14 引入 Twinkle Eval 的原因 —— 光看 ADEval 的分數,這個問題完全不會顯現。
上面的表格涵蓋了大部分情況,但有三個問題值得單獨展開,因為它們完全不會報錯,而且症狀具有誤導性。
發生條件:assistant_only_loss=True 因 chat template 缺少 {% generation %} 標記而失效。
為什麼危險:訓練不會報錯,loss 還會漂亮地下降 —— 因為模型把 user 與 system 訊息也算進了 loss,而那些內容它在推理時「看得到」,預測起來相當容易。
換句話說,模型正在學習複述輸入,而不是學習生成正確的工具呼叫。
判斷方法:檢查訓練日誌中 mean_token_accuracy 的起始值。
正常:第 1 步 ≈ 0.3–0.6,隨訓練逐步上升
異常:第 1 步 > 0.9  ← loss mask 很可能沒生效
預防方法:Day 19 的過擬合測試。若那個測試通過了,這一項就沒問題 —— 這正是那個測試存在的價值。
發生條件:用 Day 19 的配置 C 訓練,測試時卻用了完整的配置 A,或是忘記加上 System Prompt。
為什麼危險:模型看到的上下文分佈與訓練時不同,表現會莫名其妙地差 —— 而您會誤以為是訓練失敗,開始調整超參數、增加資料,卻始終找不到原因。
為什麼容易犯:訓練腳本與推論腳本通常是分開寫的,複製貼上時很容易漏改。
預防方法:把 System Prompt 抽成共用常數:
# prompts.py
SYSTEM_PROMPT_C = (
    "你是差勤助手。操作假單前須先查詢取得真實 ID;"
    "狀態須逐級推進;破壞性操作被拒絕後即終止。"
)
然後在訓練與推論兩邊都 from prompts import SYSTEM_PROMPT_C,而不是各自複製一份。
發生條件:Day 19 提過的分組切分沒有做,用了單純的隨機切分。
為什麼危險:驗證 Loss 看起來相當漂亮,實際測試卻不行。因為同一個原始案例的問法變體同時出現在訓練與驗證集,模型等於在「驗證」它已經背過的內容。
判斷方法:把 assert 留在腳本裡:
train_origins = {s["_origin_case_id"] for s in train}
valid_origins = {s["_origin_case_id"] for s in valid}
assert not (train_origins & valid_origins), "資料洩漏"
補救方法:重新依原始案例分組切分後重訓。
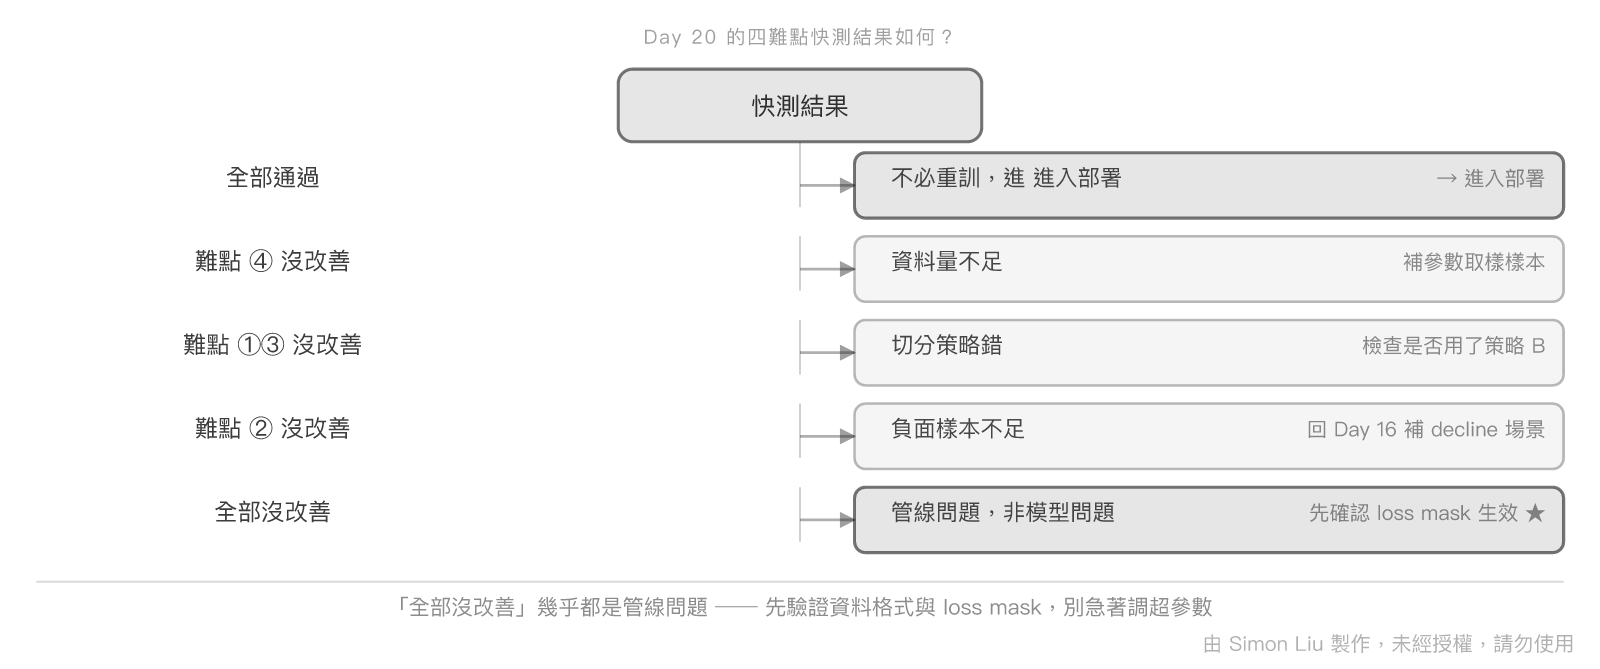
Day 20 的四難點快測跑完之後,用結果來決定下一步:
這是理想情況。可以直接進入部署階段。
參數格式是最容易學會的一類(Day 13 的分析中,few-shot 對它就有明顯效果)。如果微調後仍然沒改善,通常是該類樣本的量不夠。
處置:回到 Day 16 的參數空間取樣,系統性補充邊界值與格式變化。
這兩個難點都是跨呼叫的規則。如果模型沒學會,第一個要懷疑的是切分策略。
處置:檢查是否誤用了單步隔離(Day 15 的策略 C)。單獨看「已經有 search 結果,接下來呼叫 update」這一步,模型學到的會是「有 ID 就 update」,而不是「必須先查才有 ID」。
這是最難的一項,也是最常需要多輪調整的。
處置:回到 Day 16,檢查三件事 —— decline 樣本的比例是否足夠、decline 場景是否夠多樣(不同工具、不同上下文)、以及 decline 與 cancel 是否成對出現。
這是最重要的一條判斷。
如果四個難點全都沒有改善,那幾乎可以確定不是資料或超參數的問題,而是管線出了狀況 —— 最可能就是上一節的三個靜默失敗之一。
處置:先回頭驗證 loss mask 是否生效、Prompt 是否一致、資料是否洩漏,不要急著調整超參數。 在管線有問題的情況下調參,只會浪費時間並得到誤導性的結論。
如果昨天的訓練順利完成,這一天最值得做的是一組對照實驗 —— 它會直接成為最後驗收的素材。
Day 9 曾提到一個真實的取捨:訓練資料要不要包含 Thought(也就是 PlanReActPlanner 產生的 /*PLANNING*/ 與 /*REASONING*/ 內容)。
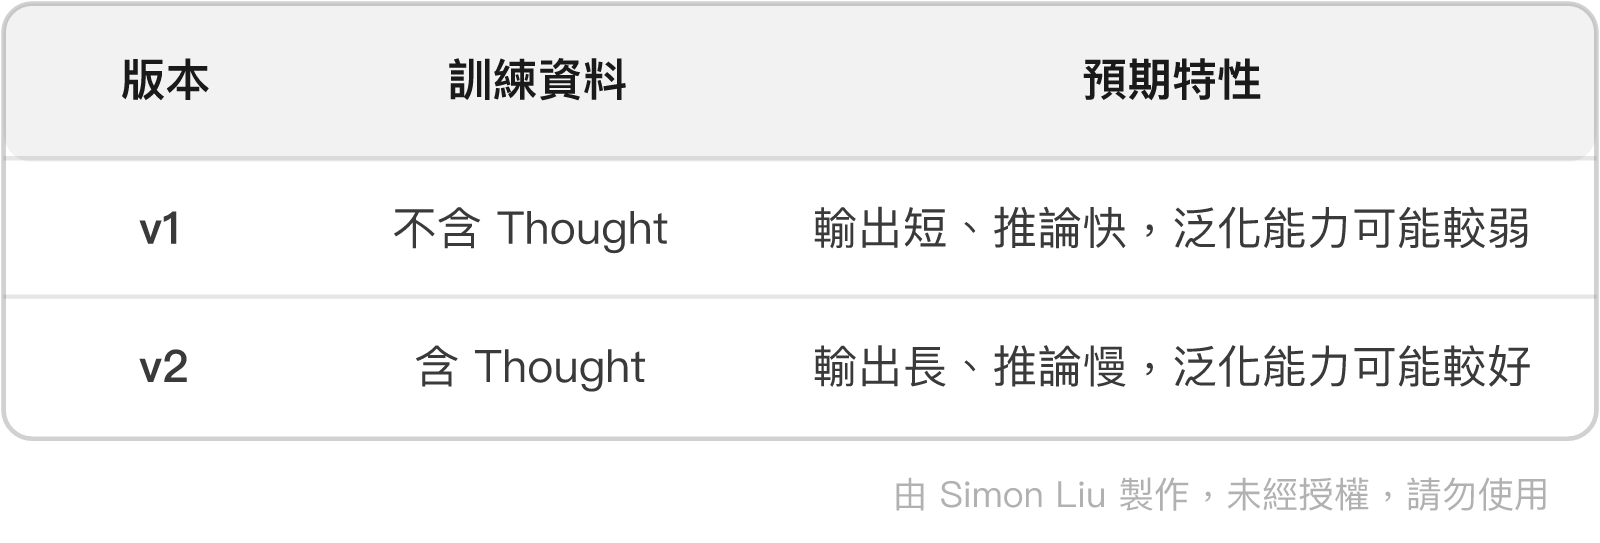
兩個版本使用同一份基礎資料、同一組超參數,唯一的差異就是有沒有 Thought。屆時用一個 adeval benchmark 指令就能比完。
這是一個能用數據回答的實務問題,而且答案對讀者有直接價值 —— 「要準確還是要快」是每個做 Agent 的人都會遇到的取捨,而多數討論停留在直覺層面。
無論成功或失敗,每一輪都要留下記錄:
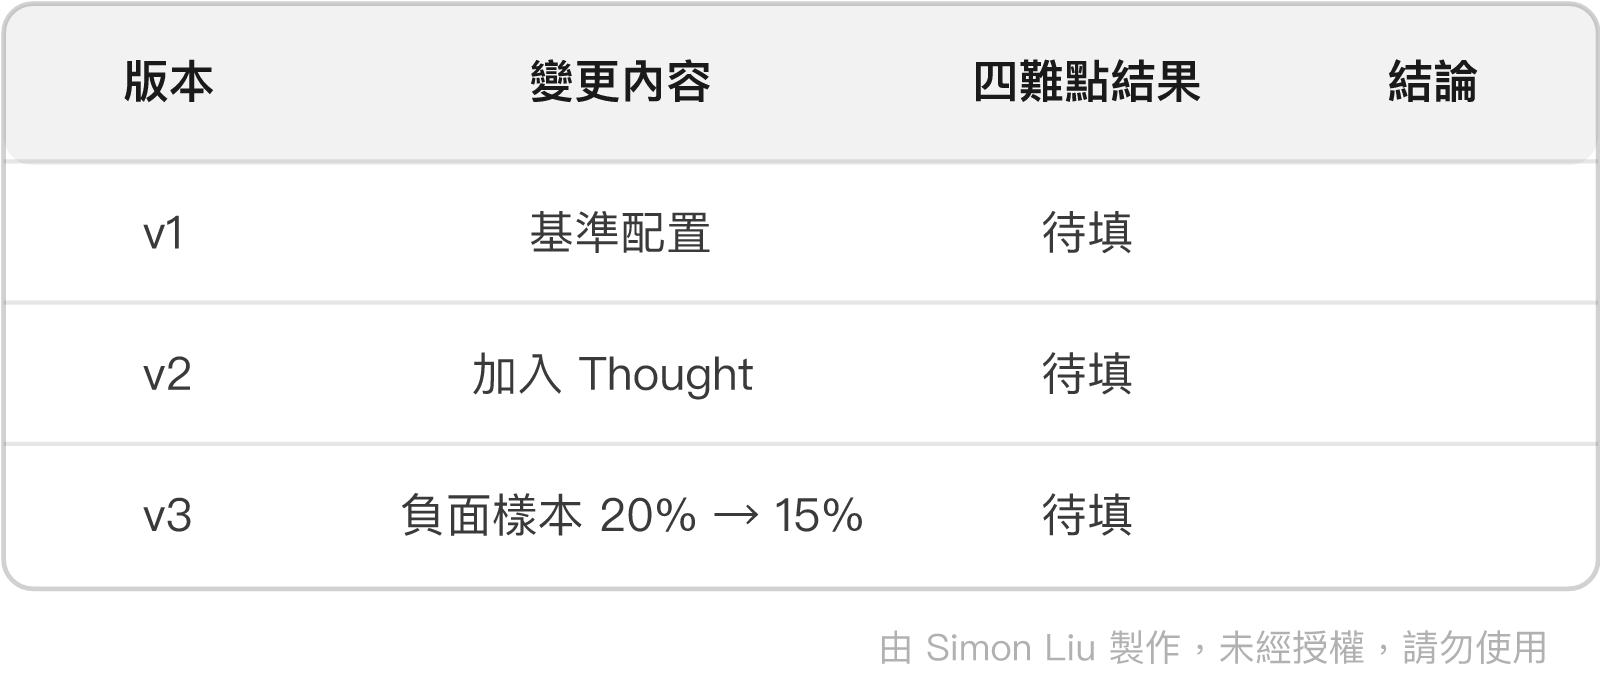
失敗的實驗也要記錄。 「試過 X,沒有效果,原因是 Y」對讀者的價值不亞於成功的配置 —— 它能讓後續的人省下重複踩坑的時間,而這正是技術分享最實際的意義。
若使用 Colab,colab log -s trainer -o experiments/run_v1.md 可以自動匯出整個 session 的執行記錄,比事後憑記憶重建可靠得多。
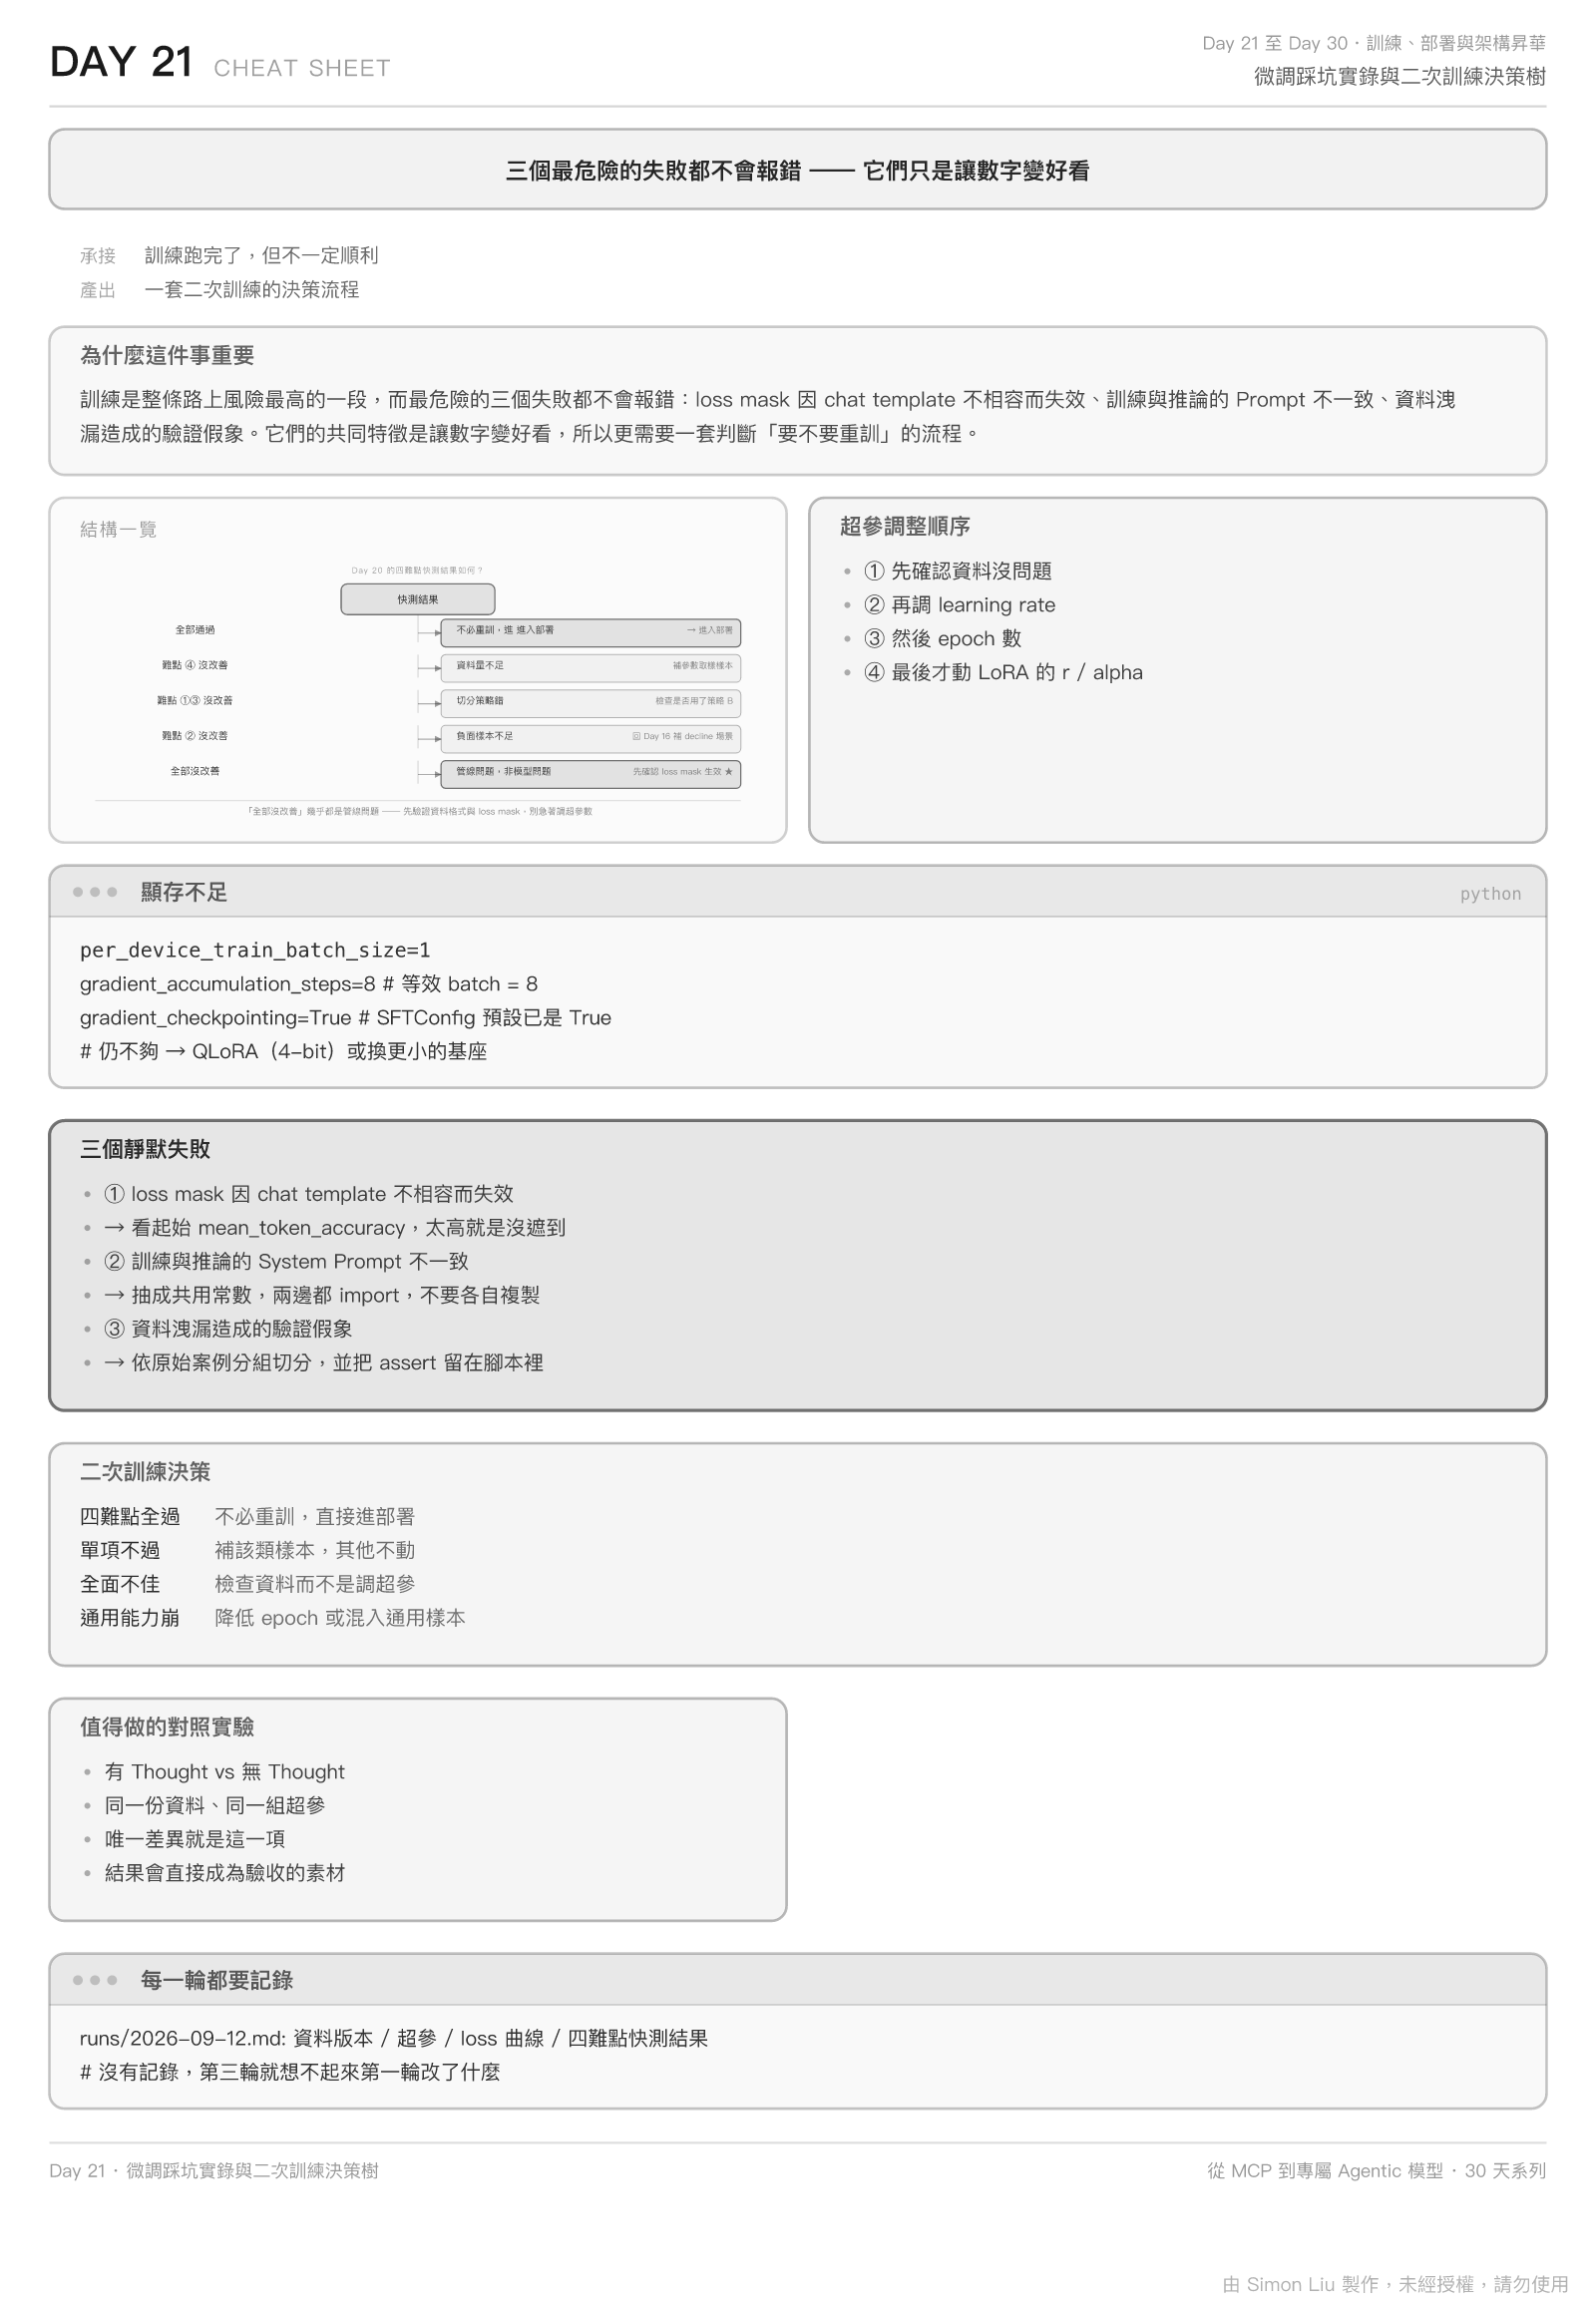
微調過程中的失敗,大多不是模型能力的問題,而是工程管線的問題。而理解這一點,能省下大量往錯誤方向排查的時間。
總結來說,今天有三個重點值得帶走:
mean_token_accuracy 起始值)、訓練與推論的 System Prompt 不一致(抽成共用常數)、以及資料洩漏造成的驗證假象(依原始案例分組切分)。這三項的共同特徵是完全不會報錯。明天把訓練好的模型變成一個能被呼叫的服務 —— 合併權重、量化,並用 vLLM 部署成 OpenAI 相容端點。而那個端點,正是雙評測要連接的對象。
assistant_only_loss 的 chat template 需求、logged metrics、bf16 與 gradient_checkpointing 預設行為colab log 匯出 session 記錄查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術