
從 Day 1 開始鋪陳的所有工作,都是為了今天這一步:在完全相同的條件下,量出微調前後的真實差距。
這件事的難處不在技術,而在控制變數。同一組測試案例、同一套比對語意、同一個 MCP Server 初始狀態、同樣的溫度設定、同樣的 repeat_runs —— 唯一允許不同的,只有模型本身。任何一項沒有對齊,得到的差異就無法歸因。
而今天要用的是兩把尺,各自回答一個問題:
一個只看前者的驗收是危險的。因為在領域資料上過度訓練,很容易得到一個在 Leave Copilot 上接近滿分、卻連使用者口語指令都聽不懂的模型。
以下的內容,將會說明執行流程、報表的結構設計、判讀方式,以及三件必須誠實呈現的事。
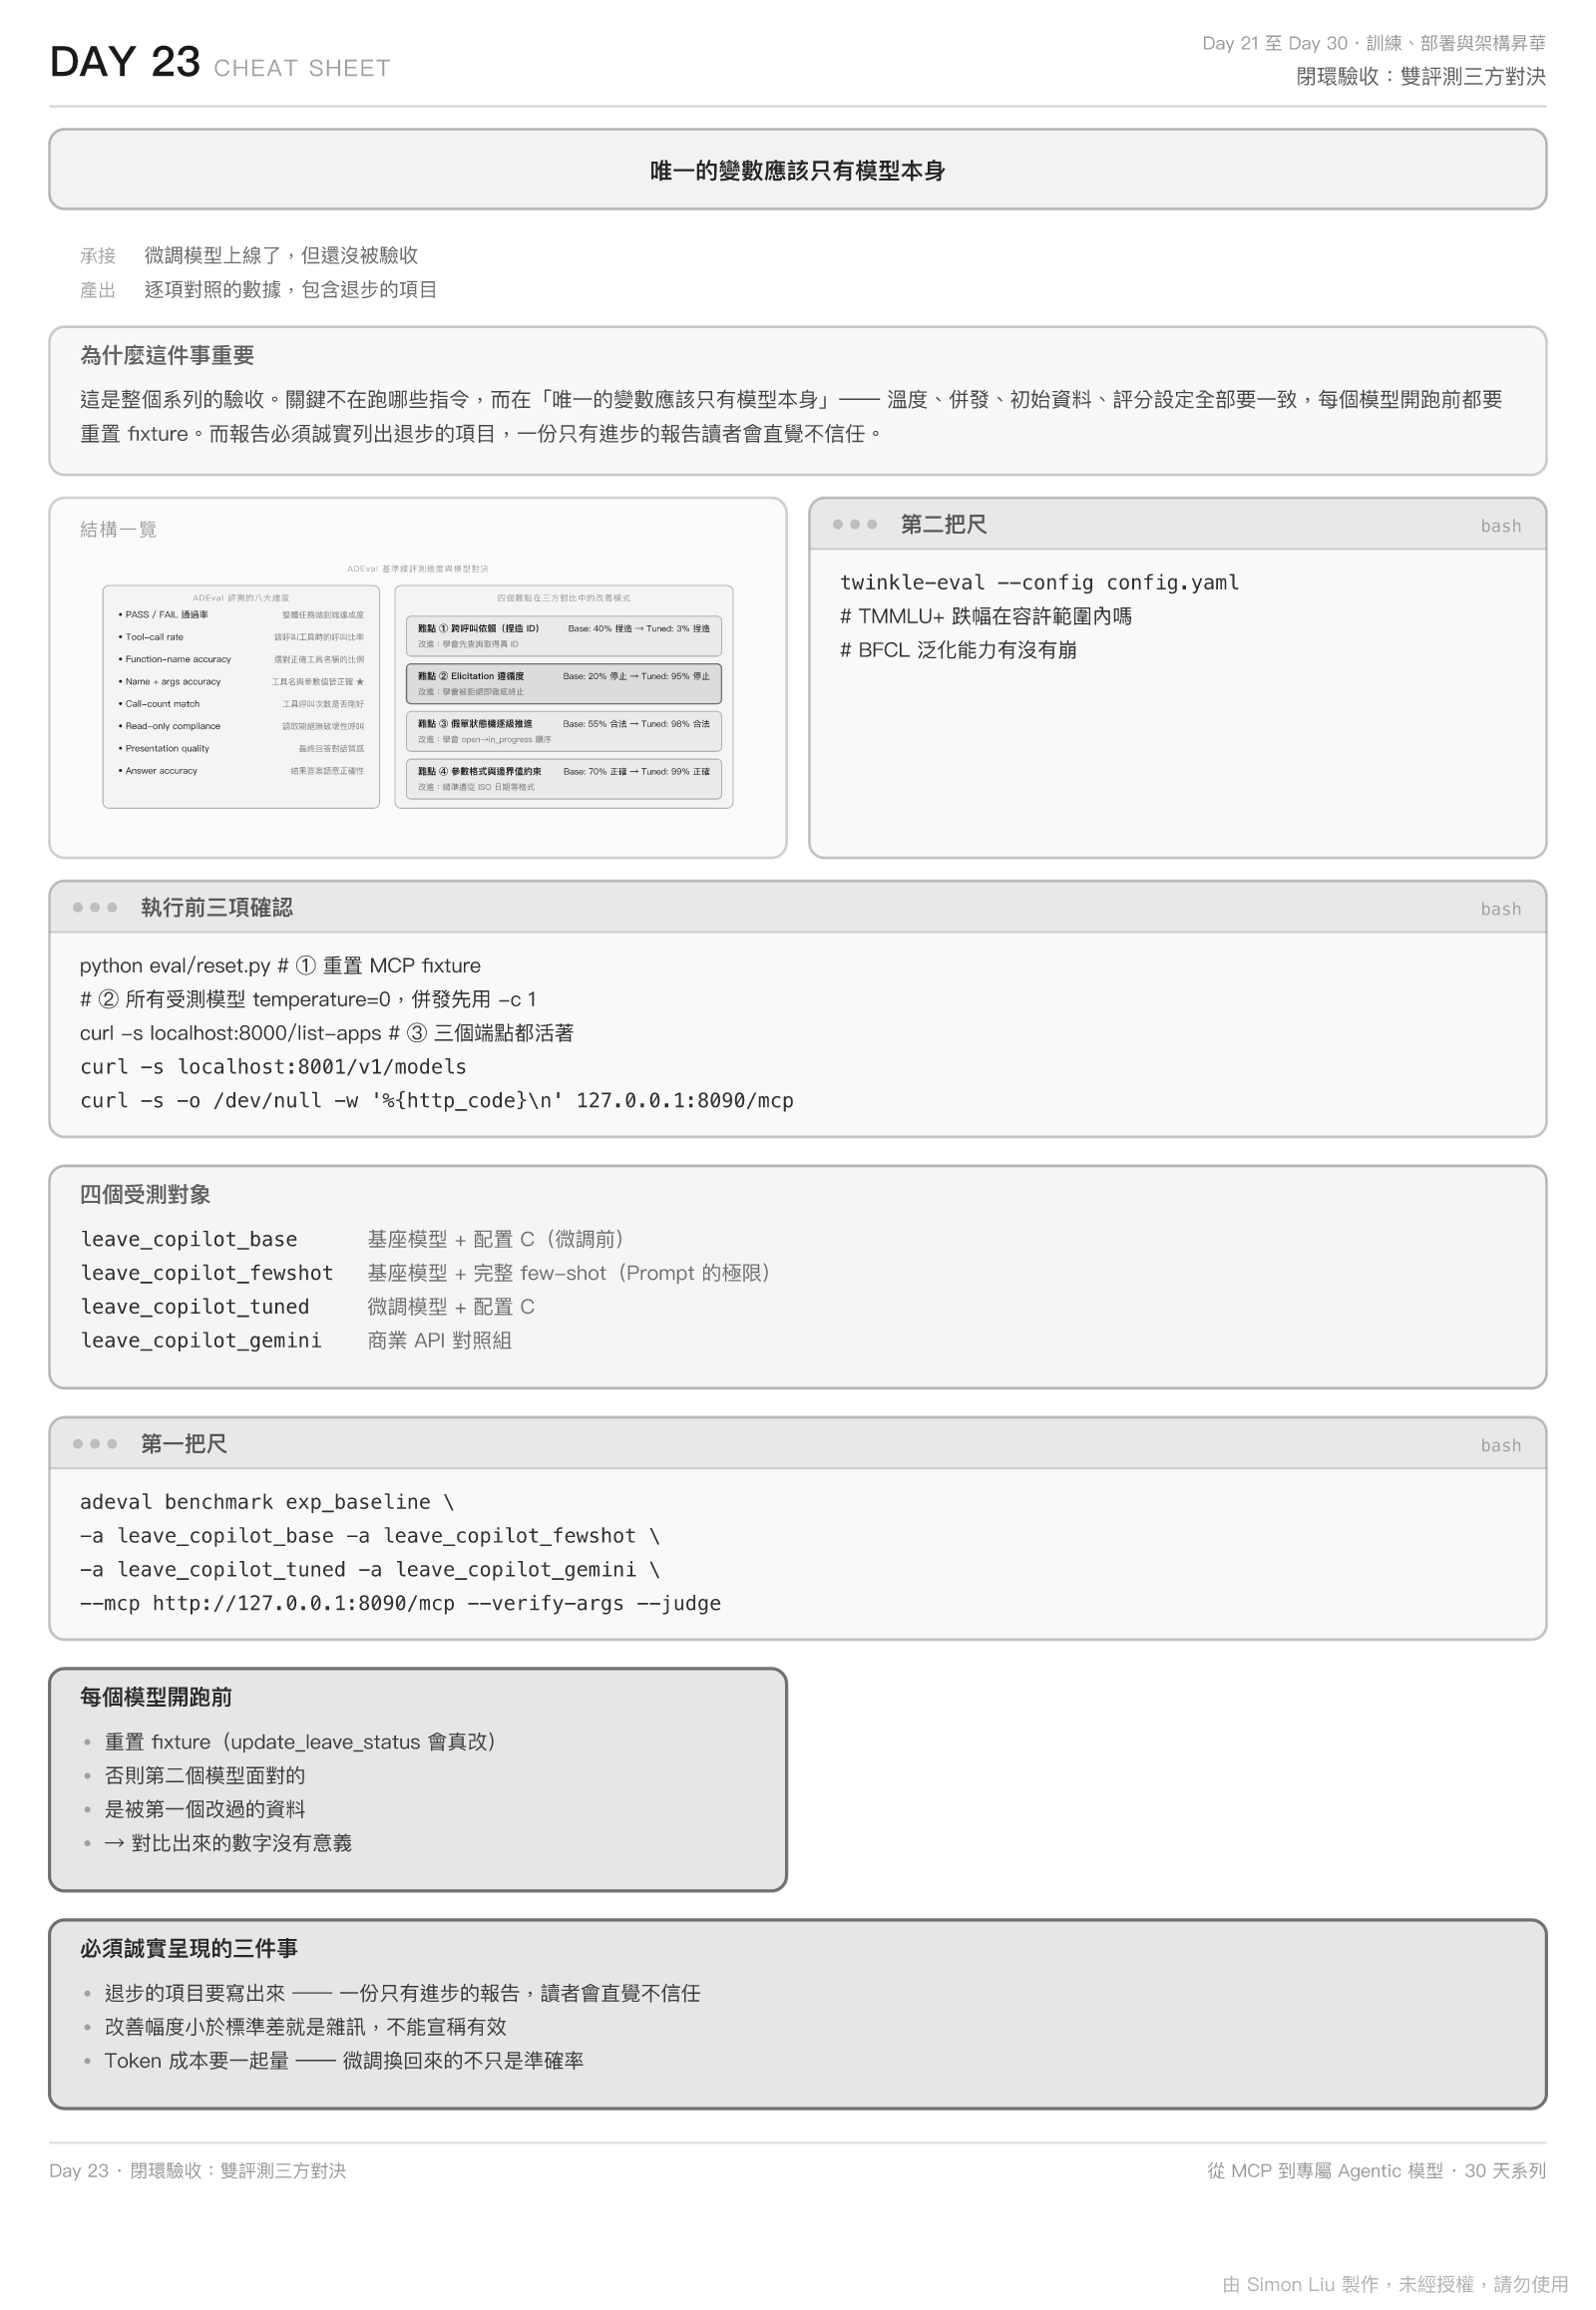
在跑任何指令之前,先確認三件事。這三項任何一項出錯,整組數據都會失去意義。
一、重置 MCP Server 狀態。 update_leave_status 會真實改變假單狀態,上一個模型跑完之後,資料已經不是初始狀態了。每個受測模型開跑前都必須重置 fixture:
python eval/reset.py # 呼叫 _reset_fixtures,還原初始假單
二、統一溫度與併發。 所有受測模型一律 temperature=0。高溫度帶來的隨機性會蓋過微調的效果,讓對比失去意義。ADEval 的併發先設 -c 1,本地推論服務的併發特性與商業 API 不同。
三、確認端點都活著。
curl -s http://localhost:8000/list-apps        # Google ADK:四個 agent
curl -s http://localhost:8001/v1/models        # vLLM:微調模型
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:8090/mcp   # MCP Server
ADEval 的 benchmark 指令可以一次跑完所有受測模型,每個模型的結果會存成獨立實驗:
adeval benchmark exp_baseline \
  --app leave_copilot_base \
  --app leave_copilot_fewshot \
  --app leave_copilot_tuned \
  --app leave_copilot_gemini \
  --mcp http://127.0.0.1:8090/mcp \
  --verify-args \
  --judge
--verify-args 必須開啟,否則難點 ③④ 量不到;--mcp 必須帶上,否則唯讀合規性會是空值。
下面的總覽表第一列要的是順序語意,而
benchmark本身跑的是集合語意。 跑完之後再用 Day 13 自己補上的那個旗標重算一次即可 —— 它讀已存下來的回答,不會重新呼叫模型:adeval rescore <EXP_ID> --ordered
跑完之後匯出多維度指標:
adeval stats <EXP_ID> --mcp http://127.0.0.1:8090/mcp --json > tuned_stats.json
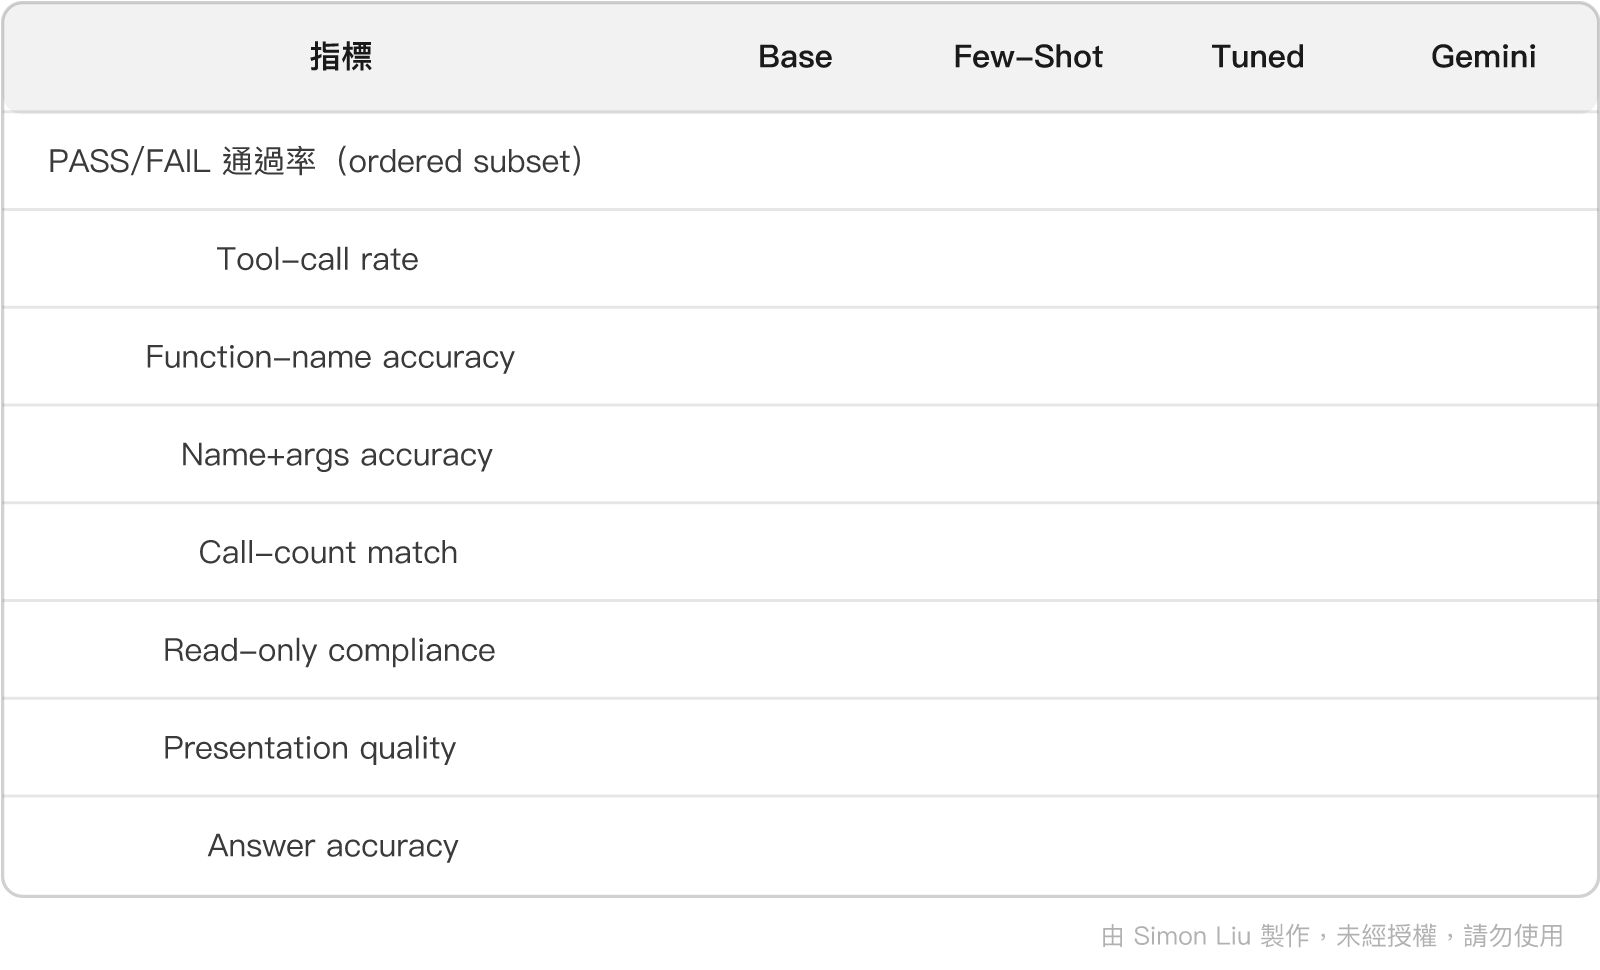
這張表比總分有價值得多。「總分提升 12%」缺乏說服力,但「捏造 ID 的比率從 X% 降到 Y%」能對應到一個具體、讀者能想像的失敗場景。
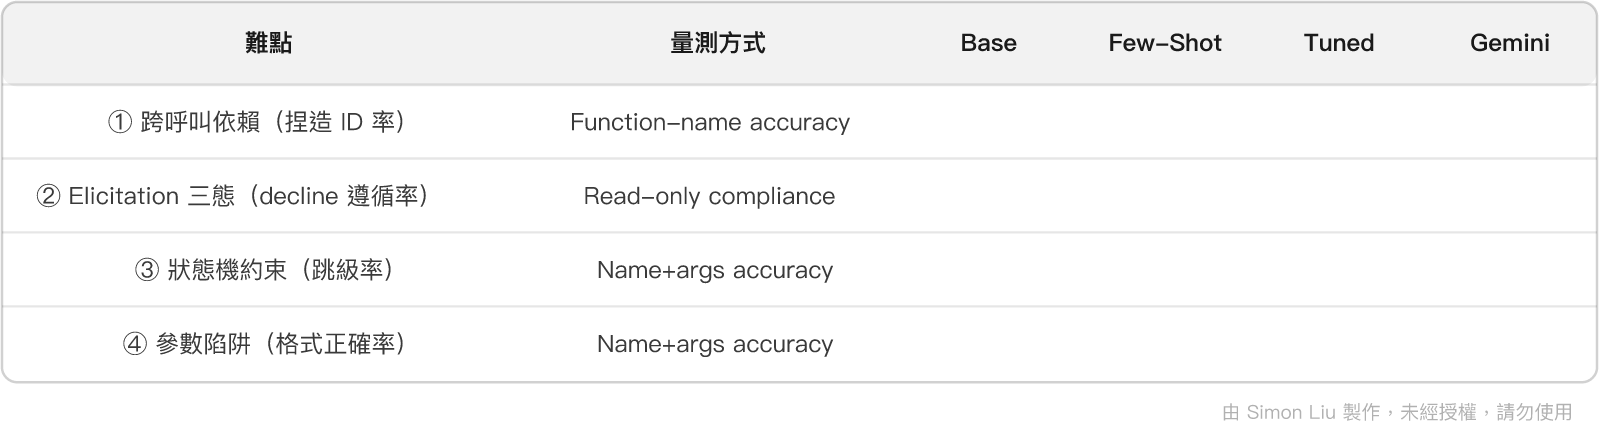
這些欄位請務必等實驗跑完再填。 在自己的環境上跑出來的數字,才是這個系列真正的價值所在 —— 編造的數據不僅沒有意義,讀者也看得出來。
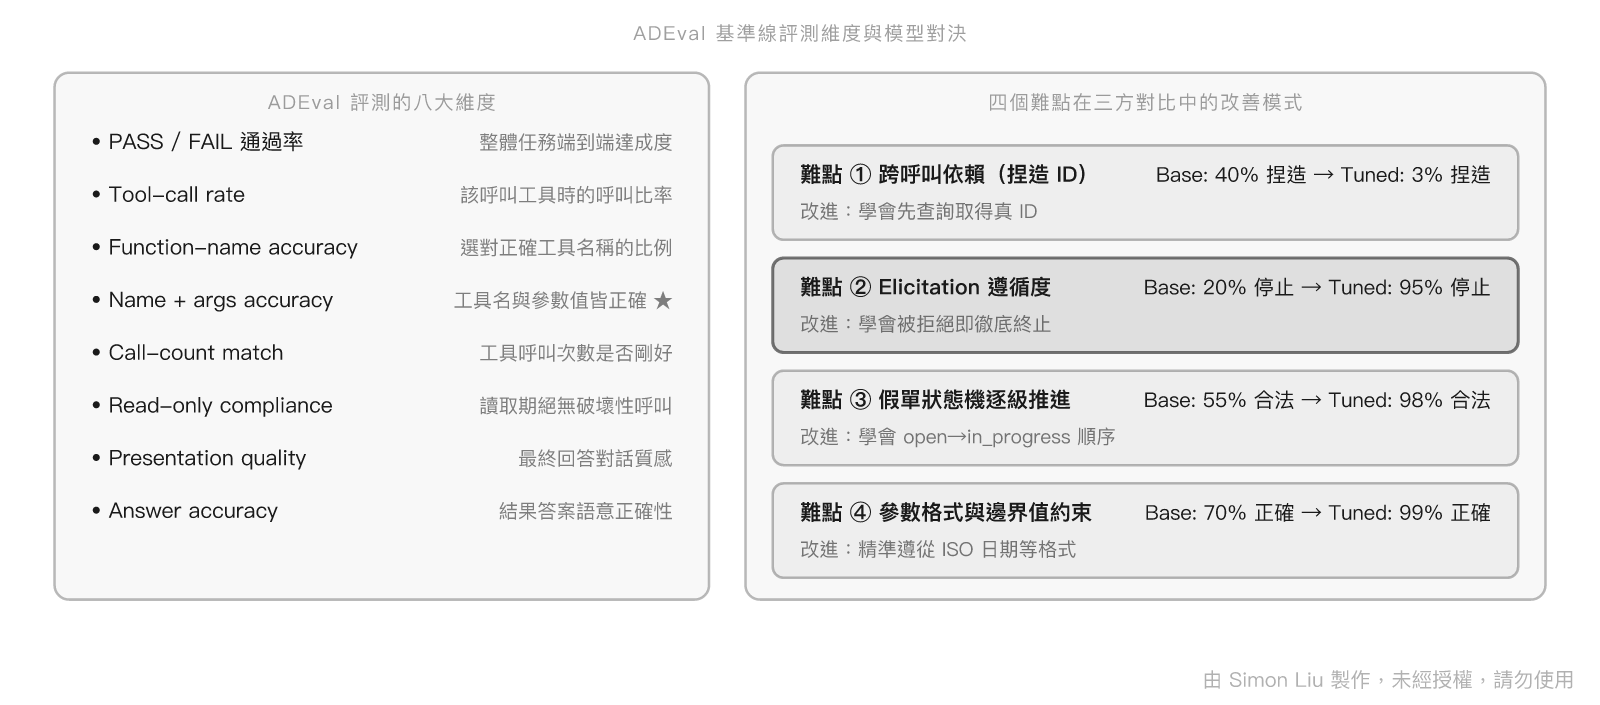
以下是基於 Day 16 分析的推論,不是實測結果。當時的結論是:越接近「格式」的問題 Prompt 越有效,越接近「行為傾向」的問題 Prompt 越無力。微調應該呈現互補的模式:
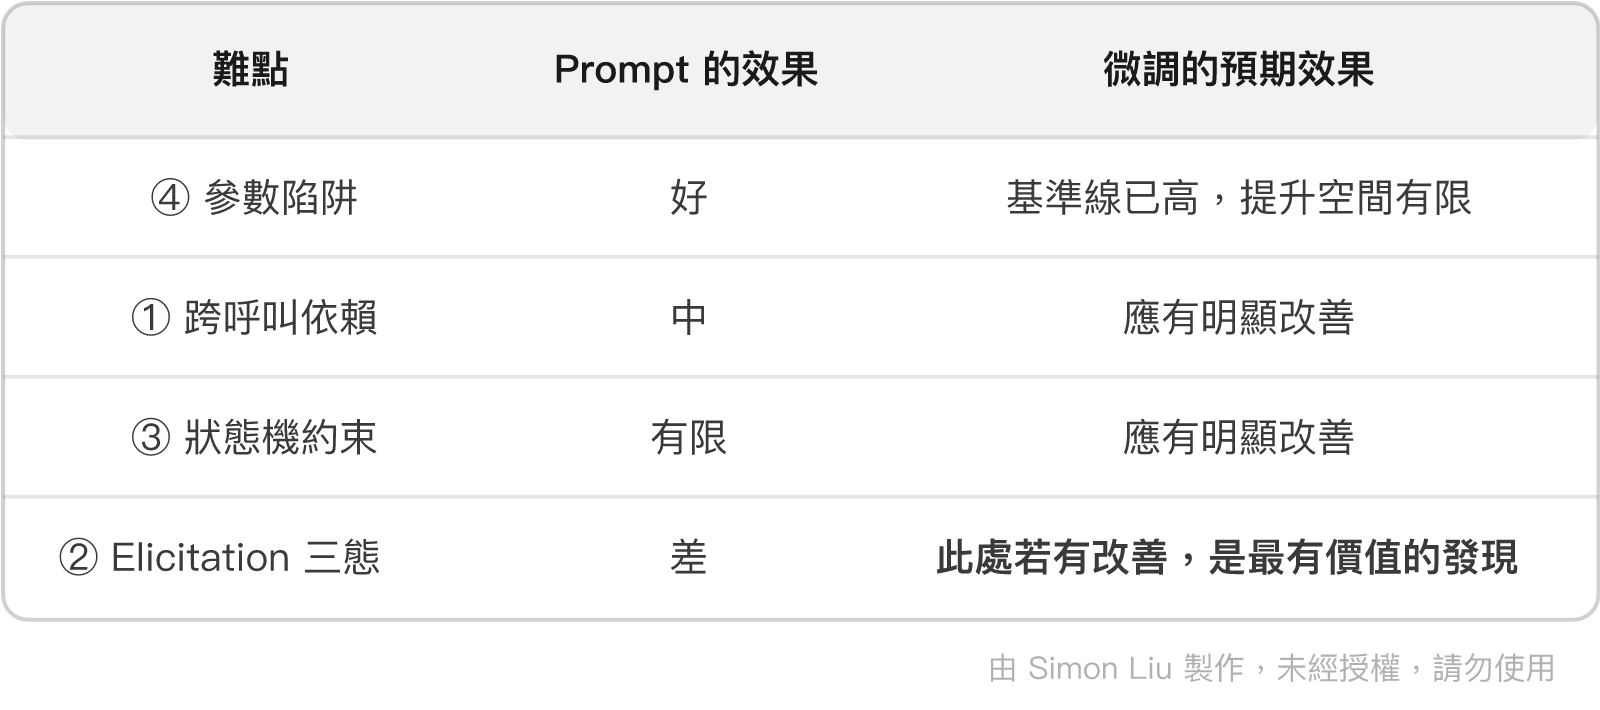
難點 ② 是關鍵觀察點。它要求模型違反「積極達成使用者目標」這個由海量資料訓練出來的傾向,而那正是 Prompt 結構上做不到、只有動權重才可能改變的東西。
如果難點 ② 沒有改善,應回頭檢查 Day 16 的負面樣本 —— 比例、多樣性,或是 decline 場景的覆蓋是否不足。
ADEval 跑完之後,還有一個問題沒有回答:模型變得更會用工具,但它是不是也變笨了?
Twinkle Eval 透過 OpenAI 相容 API 直接連上 Day 22 部署的 vLLM 端點。基座模型與微調模型各跑一次,設定完全相同:
# 微調模型
twinkle-eval --config config_tuned.yaml --export json csv

# 基座模型(改 base_url 與 model.name 後重跑)
twinkle-eval --config config_base.yaml --export json csv
兩份設定除了模型端點之外必須完全一致,特別是 repeat_runs: 3 與 shuffle_options: true。
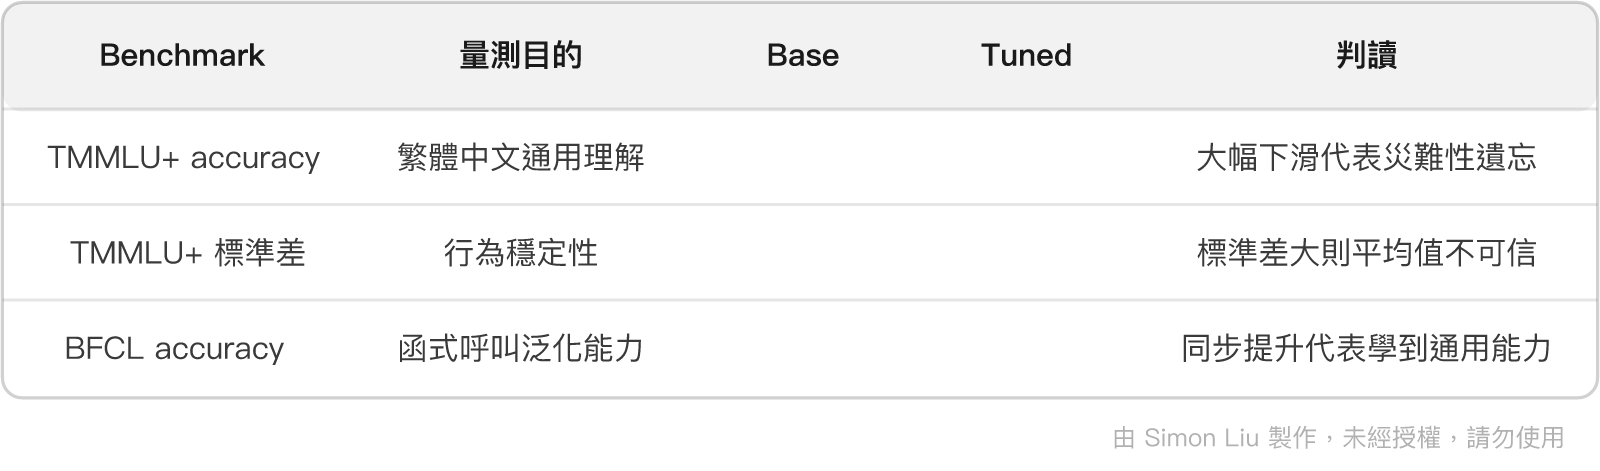
BFCL 那一列特別值得注意。 它能區分兩種截然不同的結果:
這個區分對於評估方法論的價值,比 ADEval 的分數更根本。
如果三次執行的標準差是 5%,那麼 3% 的「改善」就落在雜訊範圍內。撰寫報告時務必附上變異範圍 —— 這是把「感覺有變好」轉為「確實有變好」的分界線。
微調的效益之一是節省 Token。Day 19 選擇了精簡的 System Prompt 配置,現在可以量出實際差異。
計算每次請求的固定開銷(數值待實測填入):
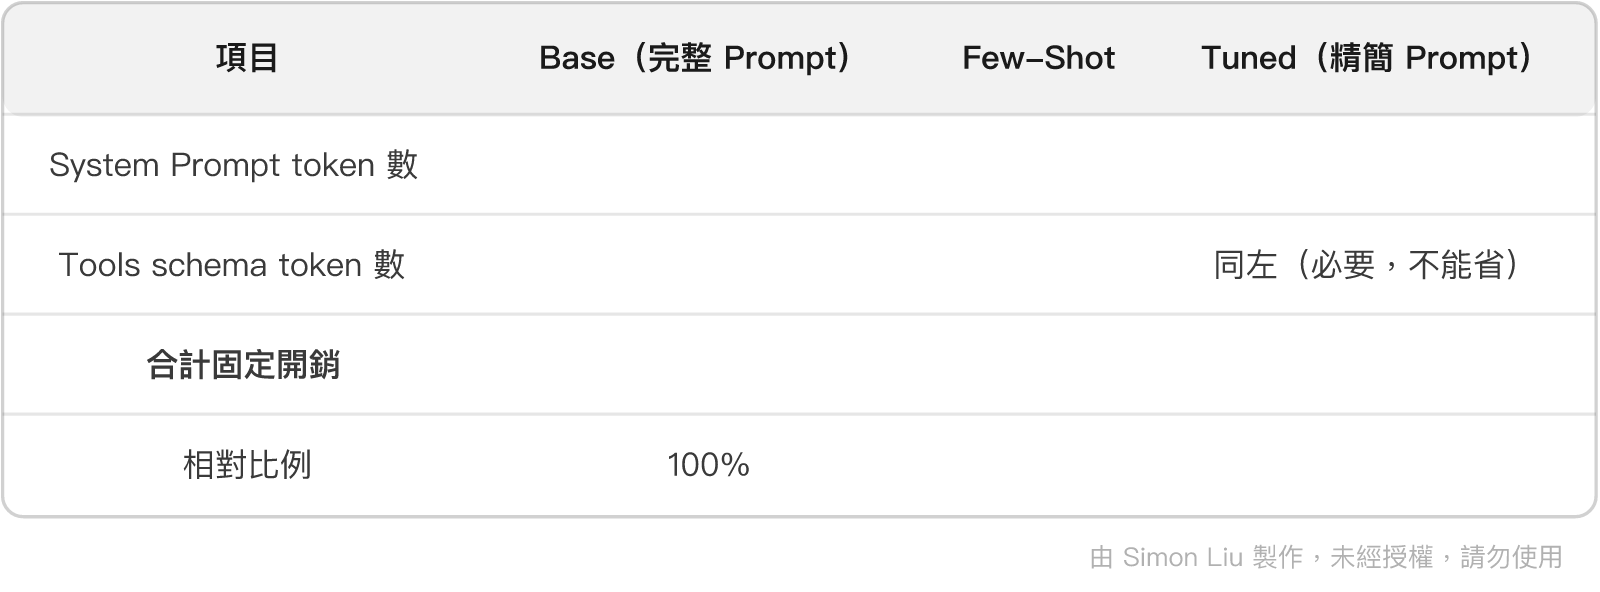
tools 欄位省不掉 —— 模型需要知道有哪些工具可用。能省的是規則說明與 few-shot 範例,而 Few-Shot 那一欄的膨脹幅度,正是 Day 19 提過的「永久成本」。
微調幾乎一定會在某些地方變差。最可能的是:
把退步的項目列出來,不要只報喜。 一份只有進步的報告,讀者會直覺不信任;而且退步的項目往往直接指出了下一步該做什麼。
微調後的小模型可能在特定任務上超越商業旗艦模型,因為它是專門為這組工具訓練的。但在通用推理上,差距通常依然存在 —— 複雜的多步驟任務、需要常識推理的場景、模稜兩可的請求。
誠實呈現這個差距,比宣稱「小模型全面勝出」有價值得多。真正的結論應該是:在規則明確、範圍固定的任務上,專用小模型是划算的選擇。
每個模型至少跑三次。如果三次結果的差異大於想宣稱的改善幅度,那個改善就不成立。
如果數據支持,這個系列所證明的並不是「微調很有效」,而是一套可重複驗證的方法論。
總結來說,今天的驗收有三個層面的價值:
而整個閉環的關鍵,在於最後這一步 —— 回到同一把尺驗收。沒有它,「微調有效」只是一種感覺。
明天問一個不同層面的問題:把框架拿掉之後,這件事在真實使用中划得來嗎?
benchmark 多模型比較、七項指標定義查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術