
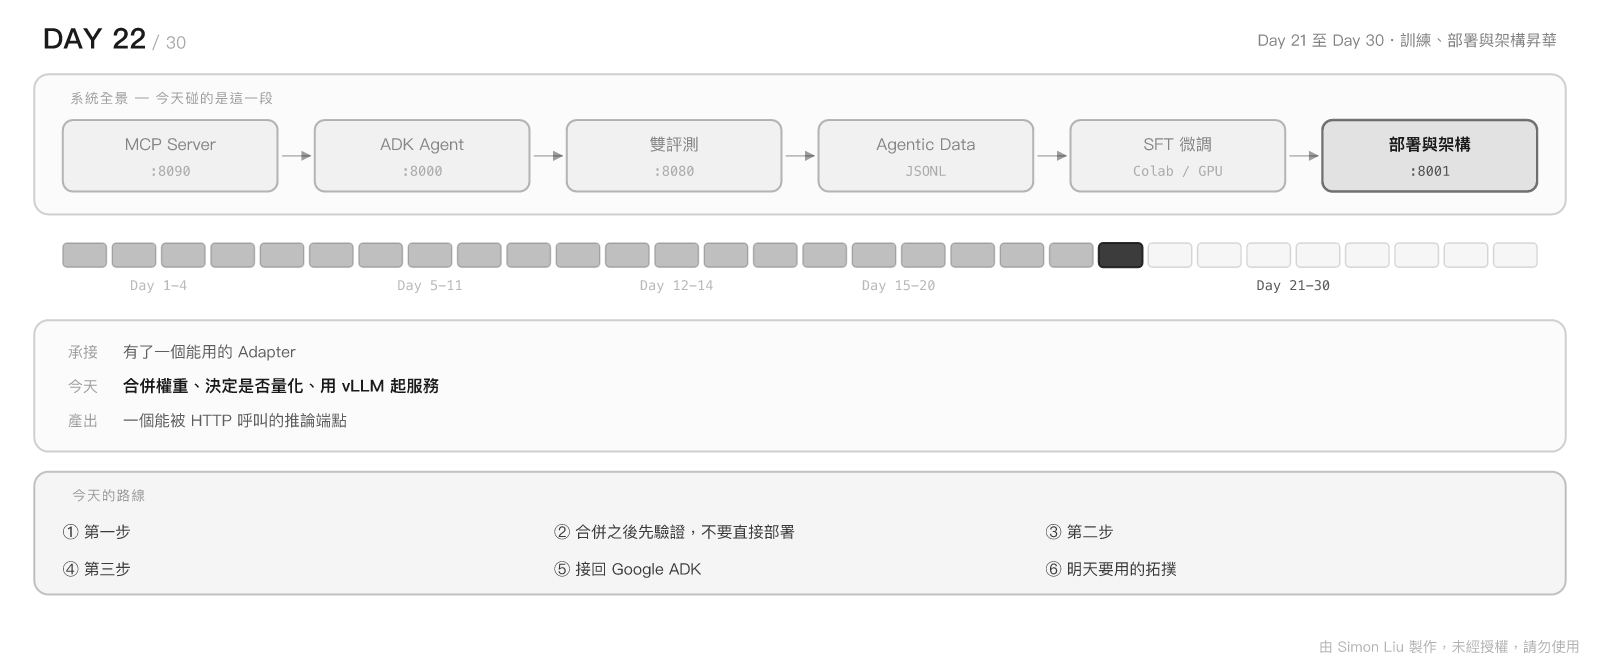
昨天處理完踩坑與二次訓練,手上有了一個 loss 收斂、快測結果合理的 LoRA Adapter。
但那個 Adapter 現在還只是一個幾十 MB 的資料夾。明天的三方對決需要的不是一個資料夾,而是一個能被 ADEval 透過 HTTP 呼叫、而且會正確回傳 tool call 的服務端點。
從前者到後者,中間有三個步驟:
這三步各自都有一個容易踩空的地方,而且它們的失敗方式都不是「跑不起來」,而是「跑起來了但工具呼叫壞掉」。
以下的內容,會逐步走完這三個步驟,並在最後把服務接回 Google ADK,架好明天對決要用的拓撲。
LoRA 的原理是在原本的權重旁邊加上一組低秩矩陣。推論時,PEFT 會在每一層額外做一次小矩陣運算 —— 這在訓練時無所謂,但在服務端有兩個實際問題:
合併之後,模型就是一個普通的 AutoModelForCausalLM,什麼工具都能接。
import torch
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

BASE = "google/gemma-4-E4B"
ADAPTER = "out/leave-copilot-lora"
MERGED = "models/leave-copilot-merged"

base = AutoModelForCausalLM.from_pretrained(
    BASE,
    dtype=torch.bfloat16,      # 與訓練時一致
    device_map="cpu",          # 合併不需要 GPU,用 CPU 反而不會爆顯存
)

model = PeftModel.from_pretrained(base, ADAPTER)
model = model.merge_and_unload()          # 關鍵的一行

model.save_pretrained(MERGED, safe_serialization=True)

# tokenizer 一定要一起存
tok = AutoTokenizer.from_pretrained(BASE)
tok.save_pretrained(MERGED)
第一,dtype 必須與訓練時一致。
如果訓練時用 bfloat16,合併時卻用了 float16,數值會有微小的偏移。這種偏移不會讓模型壞掉 —— 它會讓模型變得有點不一樣,而您很難察覺。用同一個 dtype 是最省事的做法。
第二,tokenizer 一定要一起存。
merge_and_unload() 只處理模型權重,不碰 tokenizer。忘了存的話,vLLM 載入時會找不到 chat template,工具呼叫的格式會整個錯掉 —— 而且錯誤訊息通常指向別的地方,相當難查。
順帶一提:如果訓練時擴充過 tokenizer(例如加了特殊 token),那就必須存訓練時用的那一份,而不是從基座重新載入。這個系列沒有擴充,所以直接從
BASE載入是安全的。
vLLM 支援直接掛載 LoRA Adapter:
vllm serve google/gemma-4-E4B \
  --enable-lora \
  --lora-modules leave-copilot=out/leave-copilot-lora \
  --port 8001
這在需要同時服務多個 Adapter 時很有用 —— 一個基座、多組 LoRA,共用同一份顯存。
但本系列選擇合併,理由是明天的對決需要一個與基座模型完全獨立的受測對象。掛 Adapter 的模式下,基座與微調模型共用同一個行程,萬一設定有誤,很難確定測到的到底是哪一個。
合併完成後、起服務之前,先花兩分鐘用 transformers 直接跑一次。這一步能攔下大部分「服務起來了但輸出是亂的」的情況:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

tok = AutoTokenizer.from_pretrained(MERGED)
model = AutoModelForCausalLM.from_pretrained(
    MERGED, dtype=torch.bfloat16, device_map="auto"
)

messages = [
    {"role": "system", "content": SYSTEM_PROMPT_C},   # Day 19 選定的配置 C
    {"role": "user", "content": "把我那張家庭旅遊的特休送出審核"},
]

text = tok.apply_chat_template(
    messages,
    tools=TOOLS_SCHEMA,          # Day 15 從 MCP 匯出的那份
    add_generation_prompt=True,
    tokenize=False,
)
print(text)                      # 先看渲染結果對不對

inputs = tok(text, return_tensors="pt").to(model.device)
out = model.generate(**inputs, max_new_tokens=256, do_sample=False)
print(tok.decode(out[0][inputs["input_ids"].shape[1]:]))
要看的是兩件事:
apply_chat_template 的渲染結果,工具區塊有沒有正常出現。search_leaves。如果這裡就不對,那問題出在合併或訓練,跟部署無關 —— 先在這裡修好,不要帶著問題往下走。
量化是用精度換取顯存與吞吐。但在 Agentic 場景下,這個交換比一般對話場景更需要謹慎。
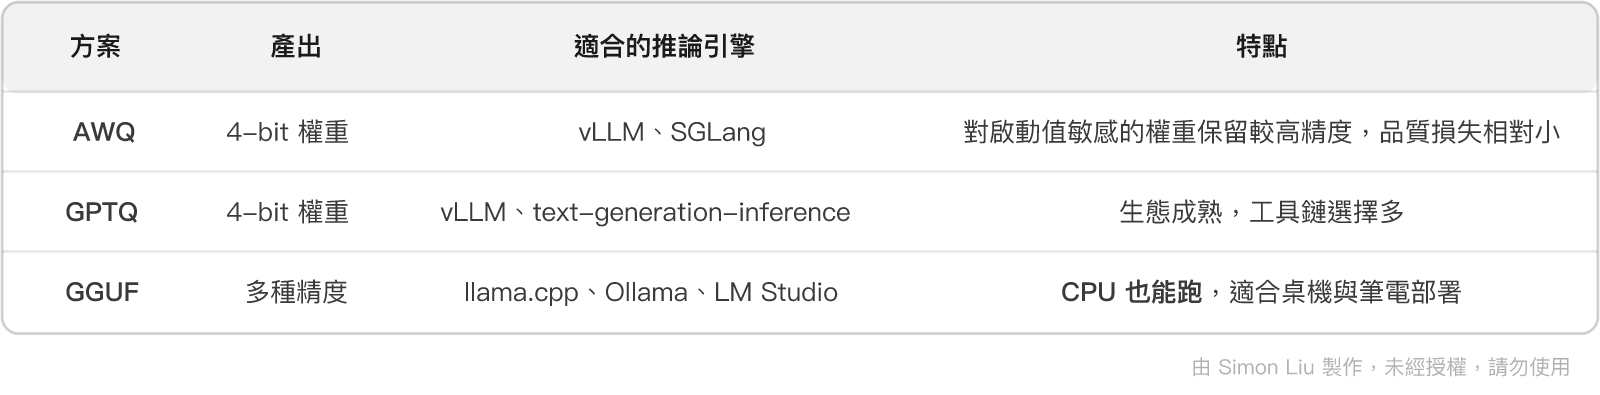
以 AWQ 為例:
from awq import AutoAWQForCausalLM
from transformers import AutoTokenizer

model = AutoAWQForCausalLM.from_pretrained(MERGED)
tok = AutoTokenizer.from_pretrained(MERGED)

model.quantize(tok, quant_config={
    "zero_point": True,
    "q_group_size": 128,
    "w_bit": 4,
    "version": "GEMM",
})

model.save_quantized("models/leave-copilot-awq")
tok.save_pretrained("models/leave-copilot-awq")
走 GGUF 的話則是 llama.cpp 的兩步流程:
python llama.cpp/convert_hf_to_gguf.py models/leave-copilot-merged \
  --outfile models/leave-copilot-f16.gguf --outtype f16

./llama.cpp/build/bin/llama-quantize \
  models/leave-copilot-f16.gguf models/leave-copilot-q4_k_m.gguf Q4_K_M
工具呼叫對量化的敏感度,比一般對話高。
原因不難理解。一般對話的評判標準是「語意通順、內容合理」,即使模型換了一個近義詞,讀起來也沒問題。但工具呼叫的評判標準是精確匹配:
Z → 失敗search_leaves 卻叫了 get_leave → 失敗這些正是我們花了 20 天訓練模型學會的細節,而量化恰好可能磨掉它們。
所以本系列的做法是:量化之後,必須重跑一次 Day 13 的評測。
adeval run <EXP_ID> --verbose
adeval stats <EXP_ID> --mcp http://127.0.0.1:8090/mcp --json > quantized.json
拿它跟未量化版本的數字並排比較。如果四個難點的通過率掉了,那就是量化吃掉了微調的成果 —— 這種情況下,寧可多租一點顯存,也不要量化。
E4B 這種規模的模型在 24GB 卡上用 bfloat16 相當寬裕,所以本系列的預設是不量化。量化這一節留給需要在更小的機器上部署的情境。
vllm serve models/leave-copilot-merged \
  --served-model-name leave-copilot \
  --port 8001 \
  --max-model-len 8192 \
  --enable-auto-tool-choice \
  --tool-call-parser gemma4
逐項說明為什麼是這些參數:
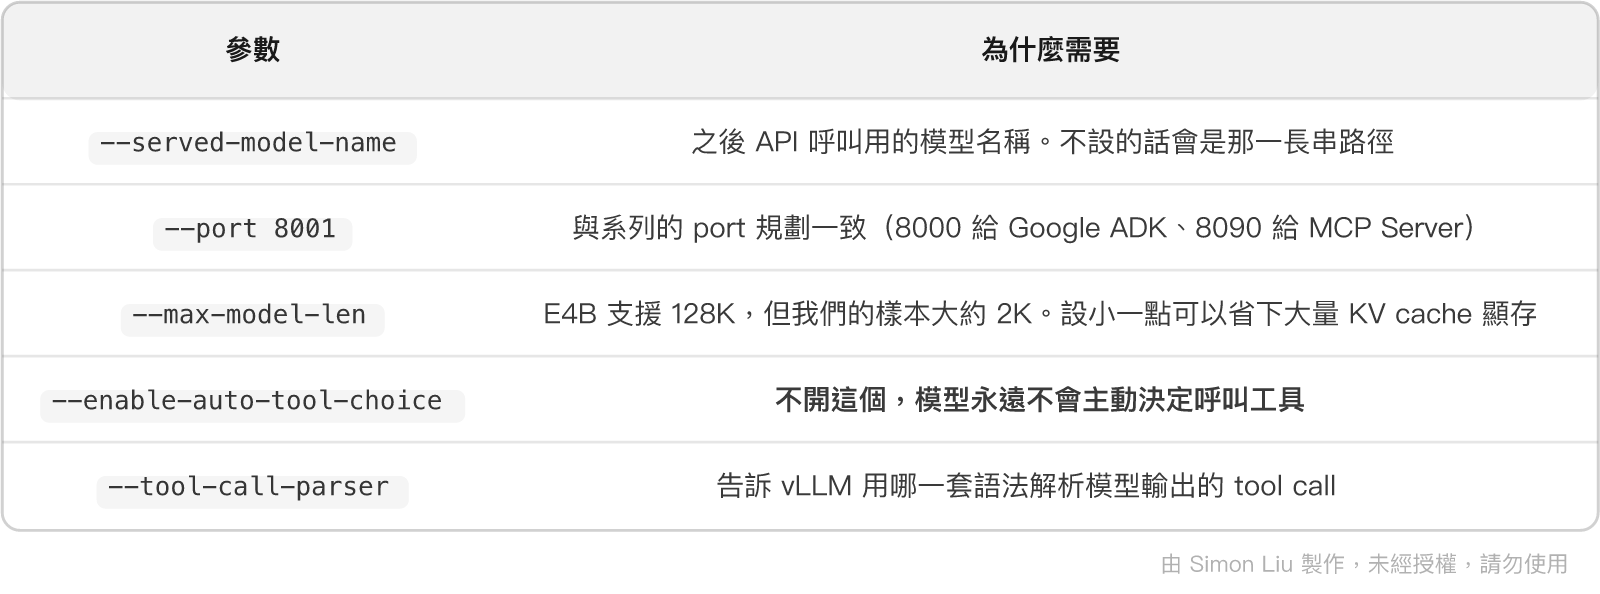
--enable-auto-tool-choice 與 --tool-call-parser 是本節的核心。 少了它們,服務會正常啟動、也會正常回答問題 —— 但工具呼叫會以純文字的形式出現在 content 裡,而不是結構化的 tool_calls 欄位。
結果就是:ADEval 解析不到任何工具呼叫,明天的分數會全部是零。而且錯誤訊息不會告訴您原因。
parser 的名稱必須與模型家族對得上。vLLM 0.27.1 內建的 parser 相當多,常用的幾個是:
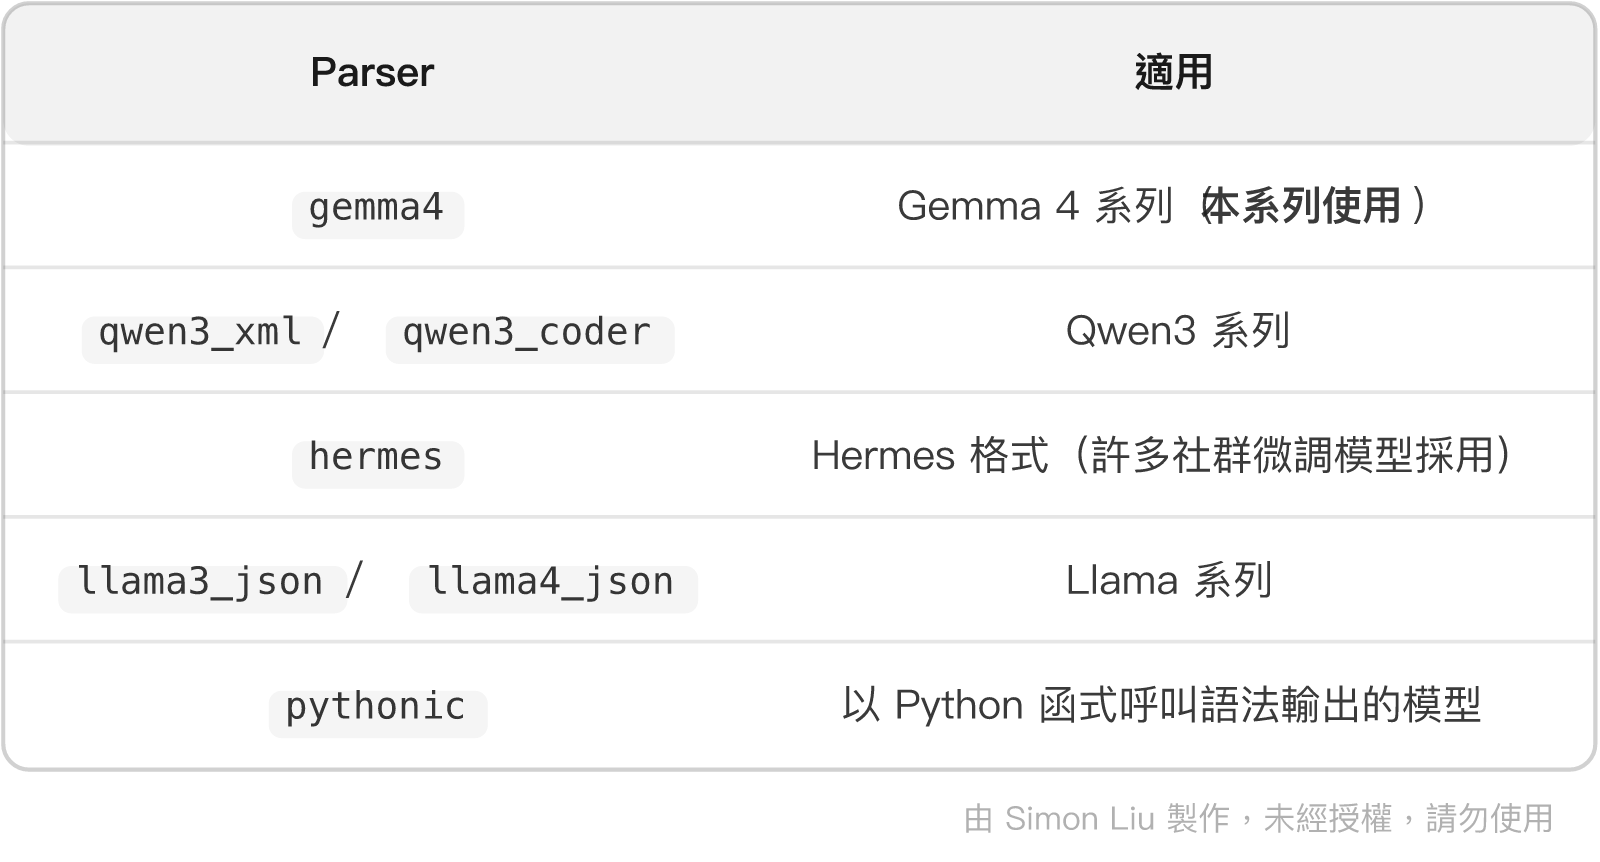
選錯 parser 的症狀很好認:
tool_calls永遠是空的,而content裡塞著一段看起來像 tool call 的文字。遇到這個症狀,先檢查 parser。
起服務之後,一定要用一個帶 tools 的請求驗證,而不只是 curl /v1/models:
curl -s http://localhost:8001/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "leave-copilot",
    "temperature": 0,
    "messages": [
      {"role": "user", "content": "把我那張家庭旅遊的特休送出審核"}
    ],
    "tools": [{
      "type": "function",
      "function": {
        "name": "search_leaves",
        "description": "搜尋假單",
        "parameters": {
          "type": "object",
          "properties": {"keyword": {"type": "string"}}
        }
      }
    }]
  }' | python3 -m json.tool
要確認回傳的 JSON 裡有 tool_calls 欄位,而且 function.name 是 search_leaves。
看到這個,就代表這一整條路是通的。看不到,就回頭檢查上面那兩個參數。
服務起來之後,還要讓 Google ADK 能用它。這靠 LiteLlm:
from google.adk.agents import Agent
from google.adk.models import LiteLlm
from google.adk.tools.mcp_tool import McpToolset, StreamableHTTPConnectionParams

tuned_model = LiteLlm(
    model="openai/leave-copilot",              # openai/ 前綴 + served-model-name
    api_base="http://localhost:8001/v1",
    api_key="EMPTY",                          # vLLM 預設不驗證,但欄位不能空
)

root_agent = Agent(
    name="leave_copilot_tuned",
    model=tuned_model,
    instruction=SYSTEM_PROMPT_C,              # 必須與訓練時完全一致
    tools=[McpToolset(
        connection_params=StreamableHTTPConnectionParams(
            url="http://127.0.0.1:8090/mcp",
        ),
    )],
)
第一,openai/ 前綴。 LiteLLM 靠前綴決定用哪一種協定。vLLM 提供的是 OpenAI 相容 API,所以前綴是 openai/,後面接 --served-model-name 設定的名稱。
第二,instruction 必須與訓練時一致。 Day 19 特地強調過這件事,這裡是它兌現的地方 —— 用 import 引用同一個常數,不要複製貼上。
第三,如果改用 Ollama,前綴必須是 ollama_chat/。
LiteLlm(model="ollama_chat/leave-copilot")     # ✓
LiteLlm(model="ollama/leave-copilot")          # ✗
Google ADK 文件對此有明確警告:用 ollama/ 前綴會導致無限工具呼叫迴圈與忽略上下文。這個坑很值錢,因為症狀看起來像是模型壞了,而實際上只是前綴寫錯。
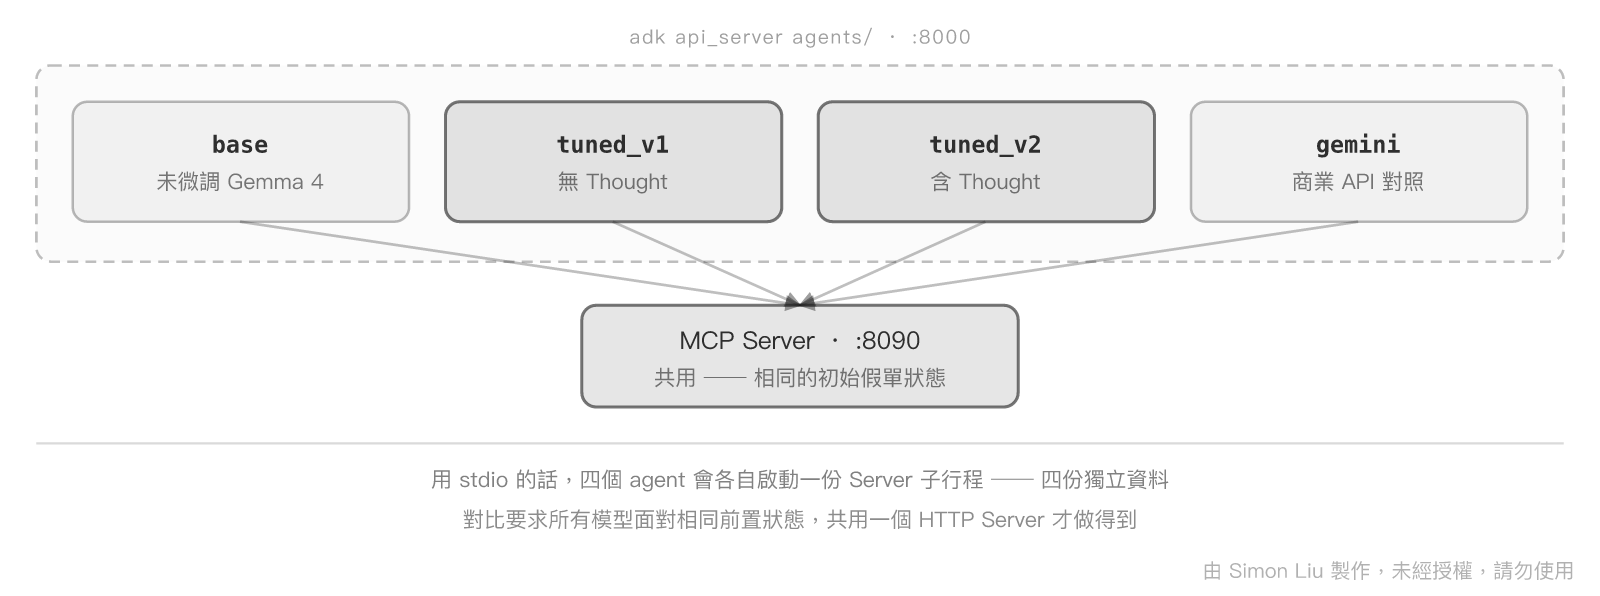
明天的對決要在完全相同的條件下比較多個模型,所以拓撲必須先架好:
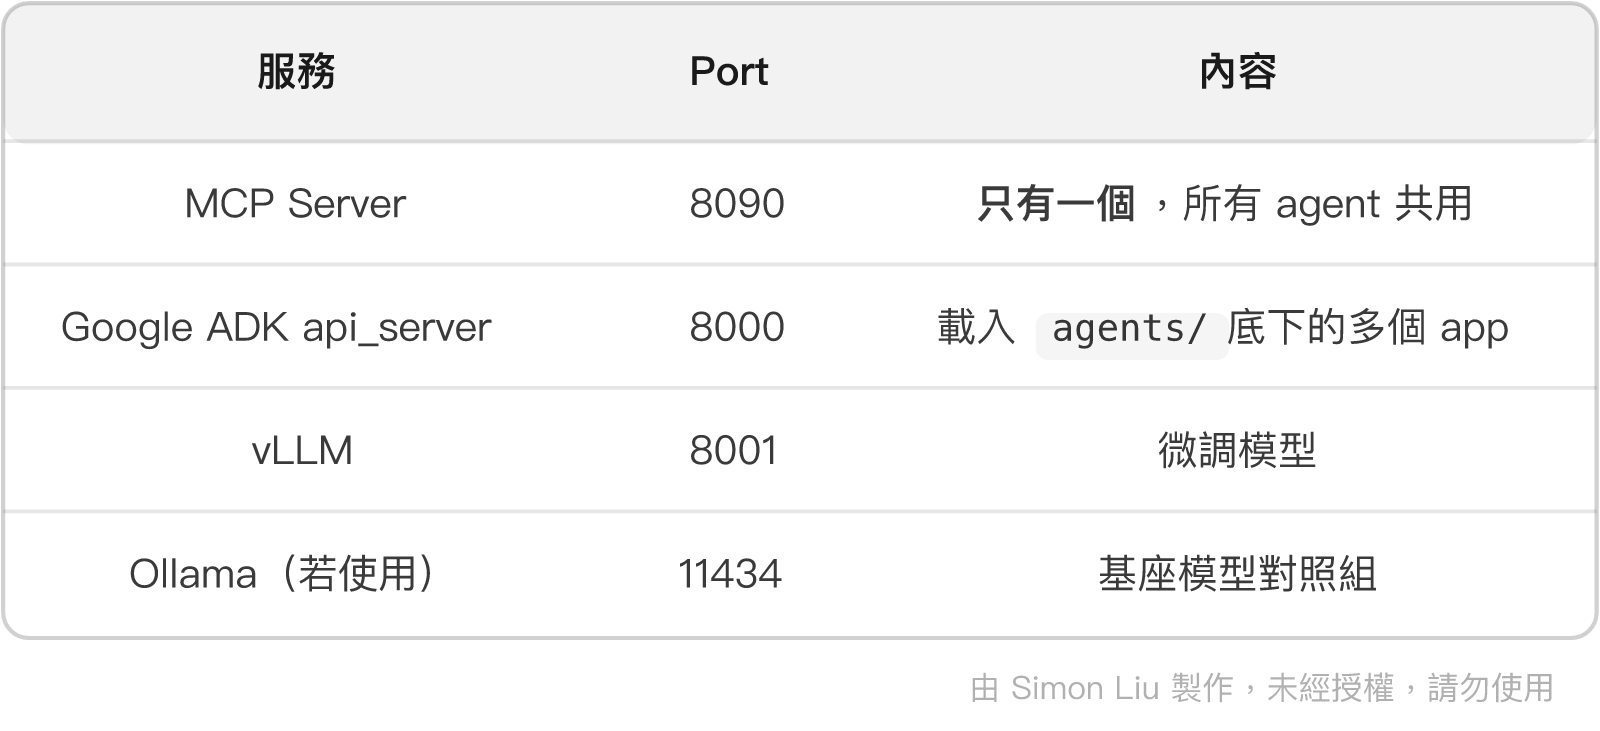
而 agents/ 底下的四個 app 就是四個受測對象:
agents/
├── leave_copilot_base/       # 基座模型 + 配置 C(微調前)
├── leave_copilot_fewshot/    # 基座模型 + 完整 few-shot(Prompt 的極限)
├── leave_copilot_tuned/      # 微調模型 + 配置 C
└── leave_copilot_gemini/     # 商業 API 對照組
注意 MCP Server 只有一個。 這是刻意的 —— 四個 agent 面對的是完全相同的工具定義與資料狀態,唯一的變數只有模型本身。
但共用一個 Server 也帶來一個必須處理的問題:
update_leave_status會真的改變資料。 第一個模型跑完之後,假單狀態已經不是初始值了。所以每個模型開跑前都必須呼叫 Day 3 做的reset()。明天會再強調一次。
啟動順序:
python -m leave_mcp.server &                                    # 8090
vllm serve models/leave-copilot-merged --served-model-name leave-copilot --port 8001 \
  --enable-auto-tool-choice --tool-call-parser gemma4 &       # 8001
adk api_server agents/ --port 8000 &                          # 8000

curl -s http://localhost:8000/list-apps          # 應該列出四個 app
curl -s http://localhost:8001/v1/models          # 應該看到 leave-copilot
部署這一段的技術難度不高,但它有一個特徵值得警覺:這裡的失敗多數是靜默的。 服務起來了、也會回答問題,但 tool_calls 是空的 —— 而那正是整個系列要驗收的東西。
總結來說,今天有三個重點值得帶走:
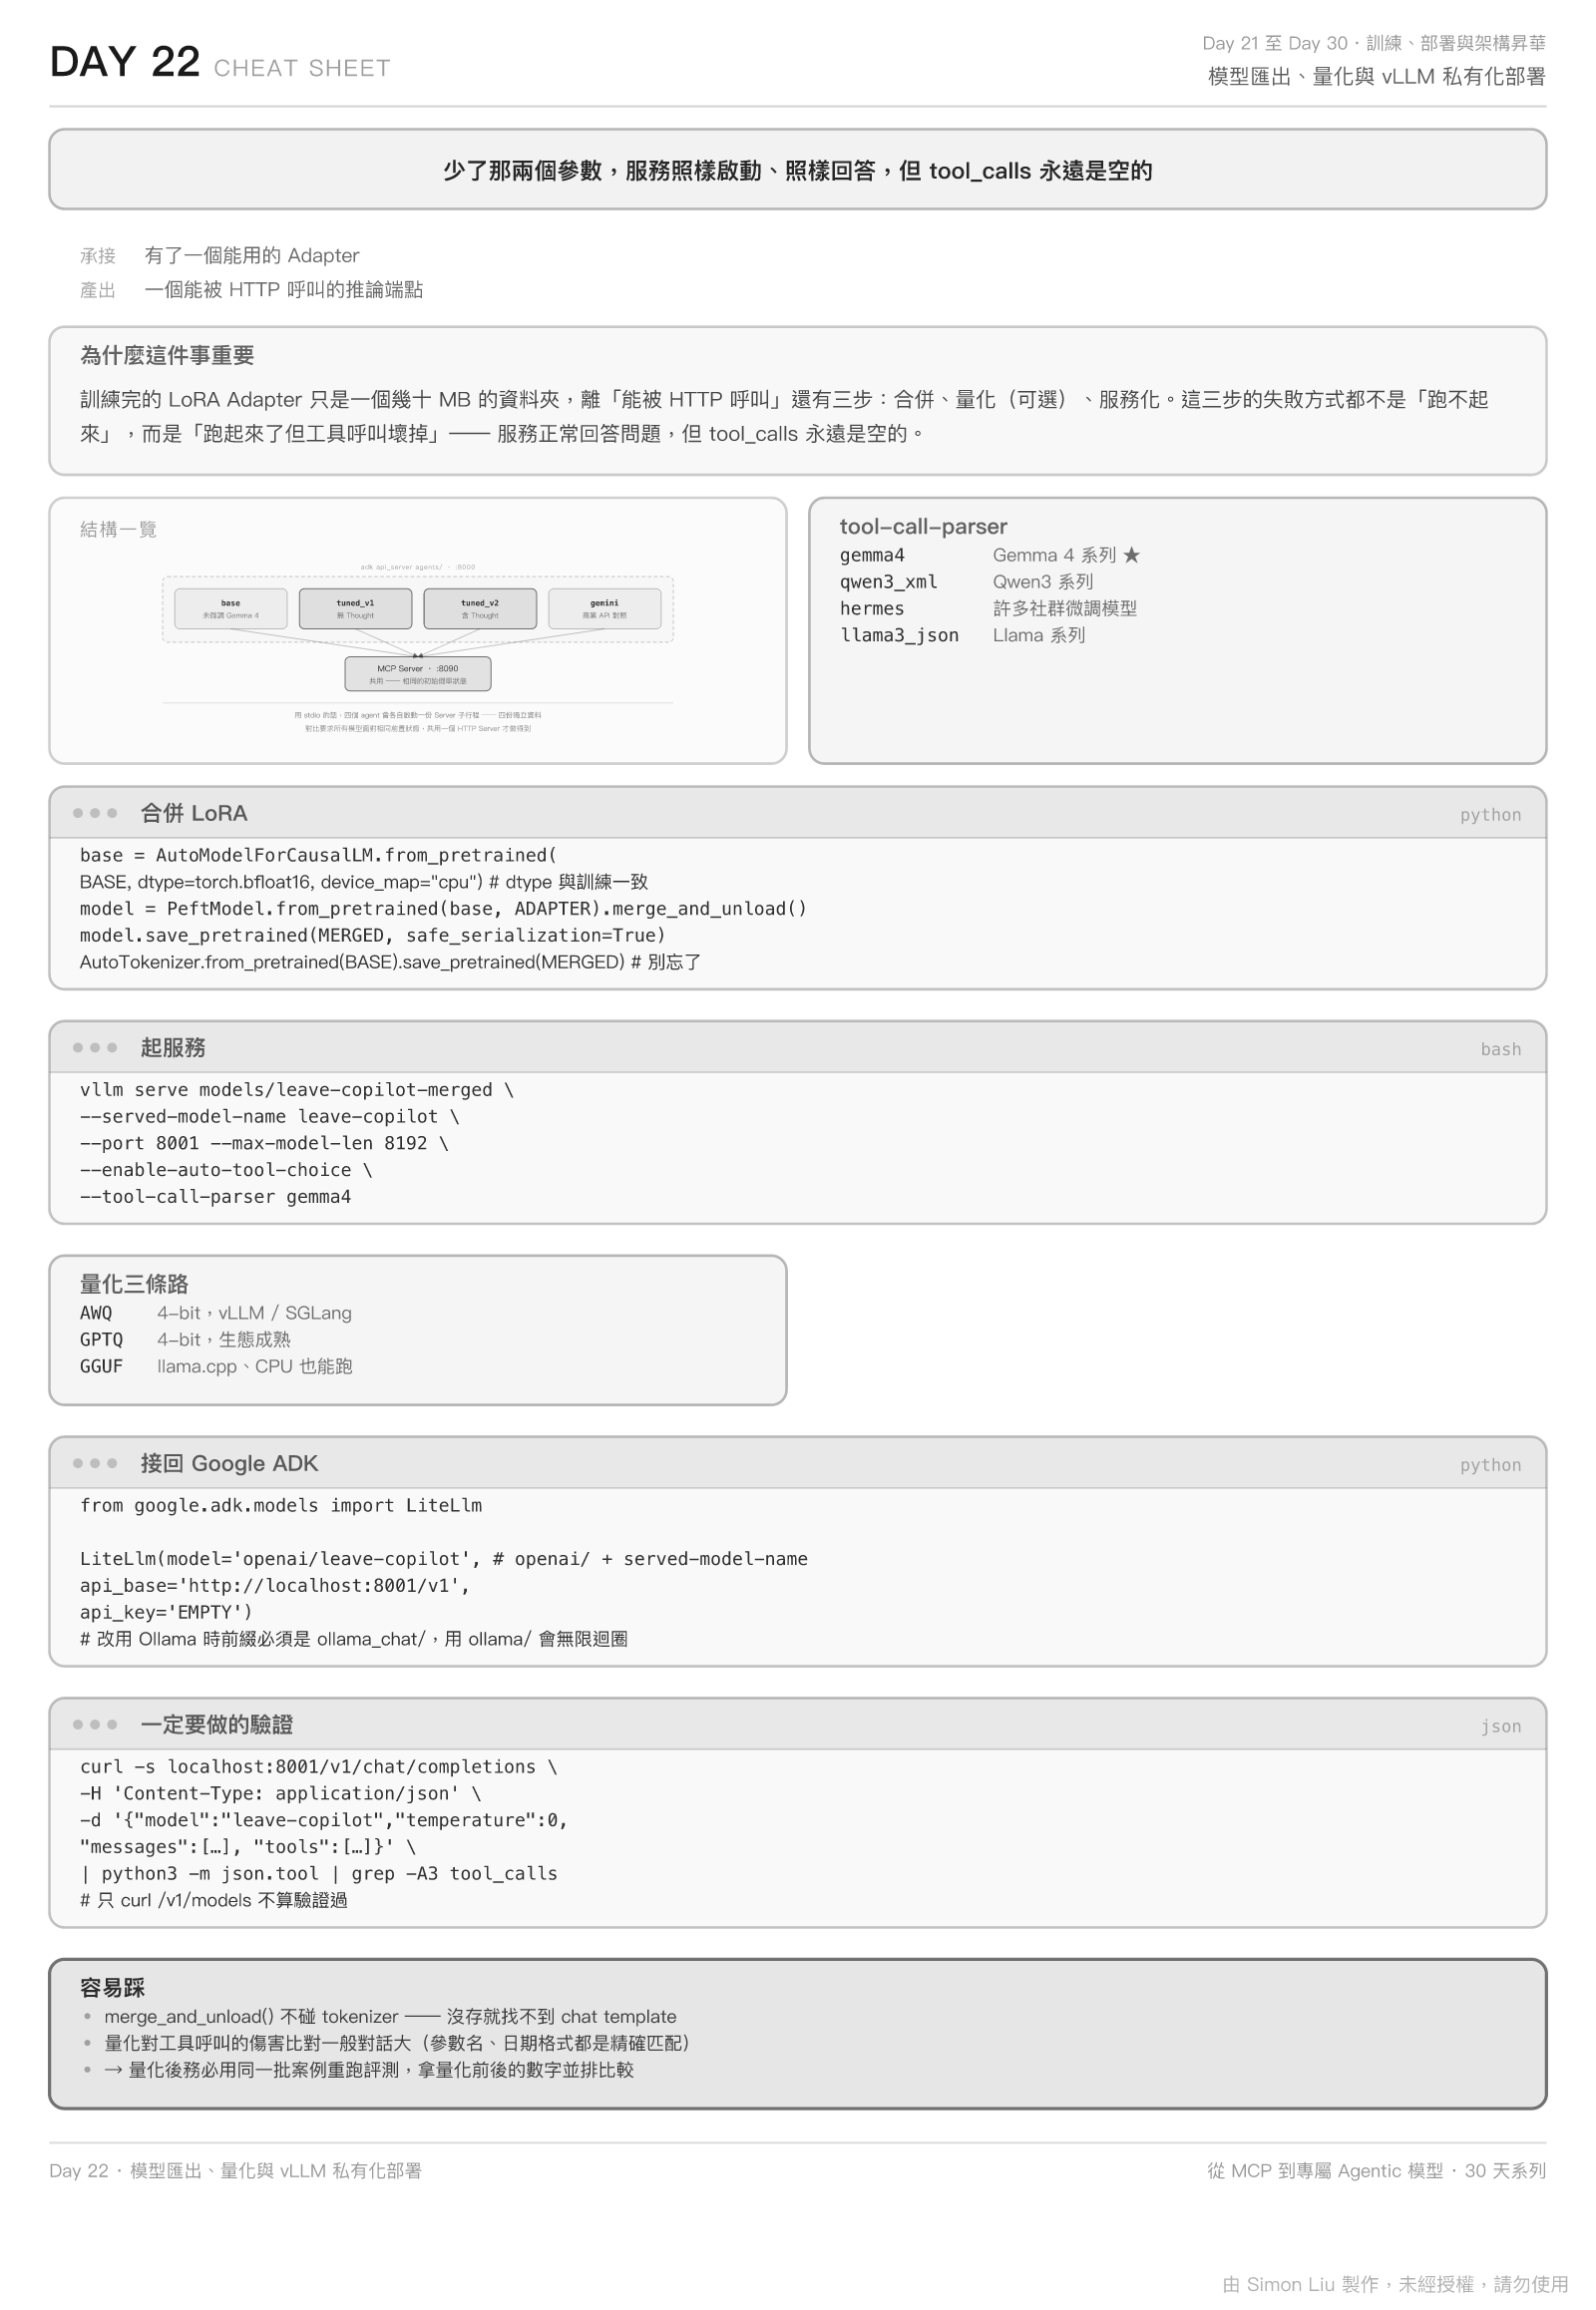
merge_and_unload() 只處理權重,不碰 tokenizer。少了它,vLLM 找不到 chat template,工具呼叫的格式會整個錯掉,而錯誤訊息通常指向別的地方。--enable-auto-tool-choice 與 --tool-call-parser 少一個都不行: 少了它們,服務照樣啟動、照樣回答,但工具呼叫會變成純文字塞在 content 裡,ADEval 一個都解析不到。parser 名稱要與模型家族對得上,本系列的 Gemma 4 對應 gemma4。明天是整個系列的高潮:雙評測三方對決。用 Day 13 凍結的那把尺量專用能力、用 Day 14 的通用能力基準線守住底線,在完全相同的條件下驗收這二十多天的成果 —— 包含那些退步的項目。
merge_and_unload() 用法與注意事項(peft 0.20.0)vllm serve 參數--enable-auto-tool-choice、--tool-call-parser
vllm/tool_parsers/__init__.py(v0.27.1)——內建 parser 名稱清單,含 gemma4、qwen3_xml、hermes
convert_hf_to_gguf.py 與 llama-quantize
ollama_chat/ 前綴的必要性與 ollama/ 的已知問題google/adk/models/lite_llm.py(google-adk 2.7.1)——LiteLlm(model, **kwargs) 將額外參數傳給 litellm查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術