
在昨天[Day 6]的文章中,我們千交代萬交代:
合併資料後一定要用 assert len(df_before) == len(df_after) 來檢查筆數,避免資料發生無限制的增加。
但,今天當我們準備計算「每一筆訂單到底花了多少錢」時,
如果直接把「訂單表」跟「明細表 (order_items)」拿來 Merge,昨天的防呆機制會立刻亮起紅燈!
今天就來拆解資料庫中最經典的一對多(1:N)關係,並示範如何利用 Pandas 的 groupby 聚合技術,
把膨脹的資料安全壓回正確的層級。
我們先從字典中取出 olist_order_items_dataset(訂單明細表),並看看它的內部結構:
# 從字典取出明細表
items = olist_db['olist_order_items_dataset']

# 檢視前五筆明細
items.head()
實作區:
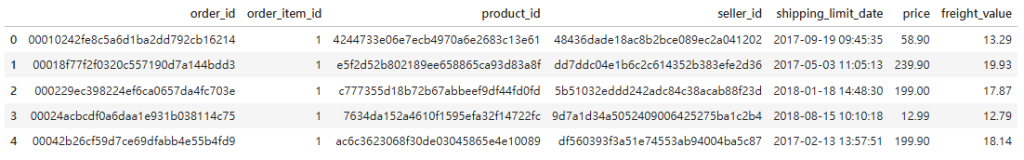
仔細觀察 order_item_id 這個欄位,你會發現:如果一位客人在同一張訂單內買了 3 件商品,這張表就會出現 3 行紀錄,編號分別是 1、2、3。
這代表訂單主表與明細表是標準的「一對多(1:N)」關係。
如果一個新手不假思索,直接用 Day 6 的方式把這兩張表串接起來,會發生什麼事?
# ❌ 危險示範:未聚合前直接 Merge
raw_merged = pd.merge(orders, items, on='order_id', how='left')

print(f"原本訂單數量: {len(orders):,} 筆")
print(f"合併後資料數量: {len(raw_merged):,} 筆")
實作區
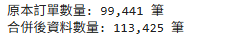
執行後你會驚訝地發現:原本只有約 99,441 筆的訂單,合併後瞬間膨脹到了 113,425 筆!
這並不是程式壞掉,而是資料被細分化了:
如果這時候你直接拿這張表去計算客戶總數或平均運送天數,所有的統計數據都會因為「買了多件商品的訂單被重複計算」而嚴重失真!
既然我們要算的是「這張訂單總共花了多少錢」,正確的工程思維是:先在明細表裡依訂單加總,再進行合併!
我們使用 groupby() 搭配 agg(),一次把「商品總金額 (price)」與「總運費 (freight_value)」算出來:
# 1. 依 order_id 分組,加總金額與運費
order_revenue = items.groupby('order_id').agg({
    'price': 'sum',          # 商品總金額
    'freight_value': 'sum',  # 總運費
    'order_item_id': 'count' # 購買商品總件數
}).reset_index()

# 2. 重新命名欄位,讓語意更清晰
order_revenue.rename(columns={
    'price': 'total_item_price',
    'freight_value': 'total_freight_value',
    'order_item_id': 'total_items_count'
}, inplace=True)

# 3. 檢查聚合後的資料樣貌
order_revenue.head(3)
實作區 :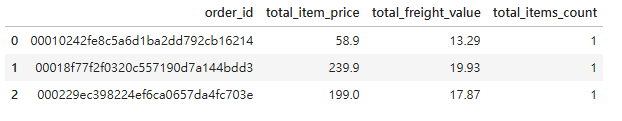
現在,order_revenue 已經被我們壓縮回「一列代表一張訂單」的粒度了。這時候再把它與 orders_customers(Day 6 建立的訂單客戶表)進行 Left Join,一切就完美合規了:
# 將乾淨的營收數據合併進訂單大表
final_orders = pd.merge(orders_customers, order_revenue, on='order_id', how='left')

# 再次啟動防呆驗證!
assert len(orders_customers) == len(final_orders), "警告:合併後筆數依然異常!"
print(f"🎉 驗證通過!最終大表維持在 {len(final_orders):,} 筆,數據完全正確!")
實作區:
今天跨越了資料分析中非常容易踩雷的關卡:
識破一對多陷阱: 搞懂為什麼直接 Merge 會導致資料筆數非預期暴增。
掌握先聚合再合併: 先用 groupby().agg() 將資料壓縮回正確的軌道上,再與主表進行無縫對接。
現在,我們的final_orders已經是一張同時擁有「時間」、「狀態」、「買家城市」與「訂單總金額」的主表了!
明天,將帶著這張打磨完成的大表,正式跨入商業洞察與指標計算的世界。


 iThome鐵人賽
 看影片追技術