
昨天我們成功打通了訂單主表、客戶表與明細表,整合出一張具備完整維度的寬表 final_orders。
當手上有一張包含營收的寬表時,許多人的第一反應是直接下 df['total_item_price'].sum() 來計算公司賺了多少錢。然而,在真實的商業世界裡,這種算法產出的往往是「灌水的假營收」。
在經營電商時,未付款、中途取消、缺貨未履約的訂單,都不能認列為公司實際入帳的成交總額(Gross Merchandise Volume, GMV)。今天我們將從宏觀視角切入,先擠出數據中的「水分」,再精準計算出 Olist 每個月的真實營收走勢。
我們先來盤點 order_status 欄位中到底藏了哪些狀態:
# 1. 檢視訂單狀態分布佔比
status_counts = final_orders['order_status'].value_counts()
status_ratio = final_orders['order_status'].value_counts(normalize=True) * 100

pd.DataFrame({'訂單數': status_counts, '佔比(%)': status_ratio.round(2)})
實作區 :
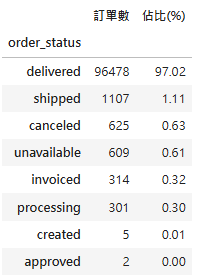
從統計可以看出,有的訂單處於非最終交付狀態。如果我們不加以過濾:
canceled(取消單)會虛增營業額。
unavailable(缺貨未履約)會干擾真實市場需求的營收換算。
為了確保財務與營運分析的嚴謹度,我們定義只有 order_status == 'delivered' 的交易才屬於有效認列營收:
# 篩選已送達顧客的有效成交訂單
valid_orders = final_orders[final_orders['order_status'] == 'delivered'].copy()

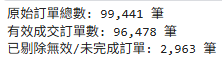
print(f"原始訂單總數: {len(final_orders):,} 筆")
print(f"有效成交訂單數: {len(valid_orders):,} 筆")
print(f"已剔除無效/未完成訂單: {len(final_orders) - len(valid_orders):,} 筆")
實作區 :
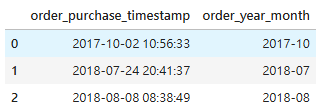
在 Day 5 的資料清洗中,我們已經將 order_purchase_timestamp 轉換為標準的 datetime64 格式。
現在,我們不需要複雜的字串切割,直接利用 Pandas 的 .dt 存取器搭配 to_period('M'),即可快速將精確到秒的時間戳記聚合為便於趨勢比較的「月份區間」:
# 新增 'order_year_month' 欄位(格式為 YYYY-MM)
valid_orders['order_year_month'] = valid_orders['order_purchase_timestamp'].dt.to_period('M')

# 檢視處理後的對照樣本
valid_orders[['order_purchase_timestamp', 'order_year_month']].head(3)
實作區 :
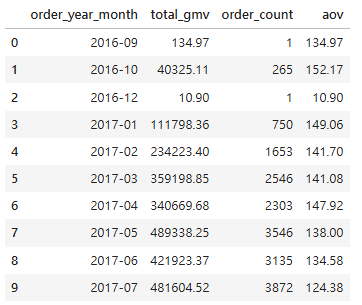
維度切分完成後,我們同時計算電商最關注的兩個關鍵指標:
GMV (Gross Merchandise Volume): 當月商品總成交金額。
Order Volume: 當月成功履約的訂單總數。
# 依月份聚合計算總 GMV 與總訂單數
monthly_metrics = valid_orders.groupby('order_year_month').agg(
    total_gmv=('total_item_price', 'sum'),
    order_count=('order_id', 'count')
).reset_index()

# 計算各月平均客單價 (AOV: Average Order Value)
monthly_metrics['aov'] = (monthly_metrics['total_gmv'] / monthly_metrics['order_count']).round(2)

# 轉換 Period 為字串以利輸出與後續作圖
monthly_metrics['order_year_month'] = monthly_metrics['order_year_month'].astype(str)

monthly_metrics.head(10)
實作區 :
當數據拉到最後幾個月(monthly_metrics.tail())時,會發現一個關鍵的數據異常:
2018 年 1 月至 8 月,月 GMV 穩定維持在約 85 萬至 97 萬雷亞爾(BRL)的高檔。
但到了 2018 年 9 月,GMV 卻瞬間雪崩只剩微量紀錄。
# 觀察最後幾個月的月營收表現
monthly_metrics.tail(8)
實作區 :
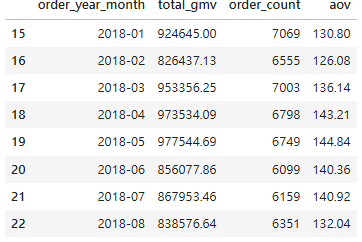
這並不是平台營運發生崩盤,而是典型的資料庫取樣截止效應(Data Truncation):
該公開資料集的採集截止日為 2018 年 9 月初,因此 9 月份只有極少數尚未完成結算的資料。
實作結論:
在進行長期趨勢評估或預測模型訓練時,必須主動將 2018 年 9 月(含)以後的不完整月份剔除,
否則會得出「公司即將倒閉」的荒謬結論。
這正是數據健康檢查與業務常識結合的價值所在。
今天我們完成了從寬表到商業指標的轉化:
1.拒絕營收灌水: 透過 order_status 嚴格把關,剔除未履約訂單。
2.時序特徵提煉: 善用 .dt.to_period('M') 完成標準月份區間建立。
3.發現數據截斷: 透過數據尾端檢驗,識別出資料收集邊界帶來的斷崖假象。
我們已經在宏觀維度確認了平台的成長曲線。既然整體 GMV 呈現向上擴張的格局,那麼究竟是哪些「行政區」在貢獻主力消費?明天,我們將下鑽至地理維度,分析巴西各州的客單價 (AOV) 與訂單集中度!


 iThome鐵人賽
 看影片追技術