

相信學習一項新技術之前,最基本底子要先打好。就像派大星想組樂隊,卻不知道美乃滋跟芥末醬不是一種樂器,那這樣接下來學習的路會走得很艱辛。
Day 2 要來補一些基礎的 LLM 知識,切入點是大家每天都在做的一件事:在 ChatGPT 打完一段話,按下 Enter 之後,背後到底發生了什麼?
內容整理自 KodeKloud 的 Mumshad Mannambeth 講的一堂入門課《AI Infrastructure: LLM-D, vLLM and GPUs》。這堂課我們不聊機器學習,從頭到尾都在講 AI Infra,從按下 Enter 那一刻,一路追到 Kubernetes 上的推論架構。
「ChatGPT」這個名字拆開來是兩件事。
Chat 是應用程式,就是那個網站。
GPT 是模型,是背後真正讀你問題、想出答案的東西。
模型不只 GPT 一個,Anthropic 的 Claude、Google 的 Gemini、Meta 的 Llama,還有一大堆。名字不一樣,但底下的結構是同一套想法:一個在思考的模型,外面包一層應用程式。
想像一台很小的機器,你丟一個數字進去,出來另一個數字。丟 3 出來 6,丟 10 出來 20。它永遠把你給的東西乘以二。
這台機器就是一個模型,他接受一個輸入,做一點數學運算,然後給你一個輸出。而它全部的行為就靠裡面藏的那一個數字,也就是「 ×2 」。
        ┌──────────┐
   3 ──▶│          │──▶   6
  10 ──▶│   × 2    │──▶  20
   7 ──▶│          │──▶  14
        └──────────┘
仔細看的話,這張圖其實有兩個東西:
| 成分 | 是什麼 | 會不會變 |
|---|---|---|
| 公式(formula) | 輸入 → 乘法 → 輸出,計算的形狀 | 固定的 |
| 權重(weight) | 那個「 2 」 | 學來的 |
把權重從 2 改成 3,同一個公式就從「 ×2 」變成「 ×3 」,結構一樣,數字不同,行為完全不同。 那麼一個權重、一個乘法當然幹不了什麼事,所以來看個實際一點的例子:猜房價。
一間房子有幾個可以量的東西,比如說坪數、幾房、屋齡,每個屬性往上往下都會造成房價變動,數學原理跟剛剛一樣,只是權重變多了:300、50000、1000、25000,每個權重代表那一項屬性的重要程度。
那這些數字哪來的呢?不是瞎編的,你拿成千上萬比真實的房屋資料如坪數、房數、屋齡,以及它實際成交的價格,餵給這個公式,讓它自己算出最合適權重。 這種「通過樣本推算權重」的過程,就是訓練。
所以,模型 = 一個公式 + 一組從樣本中學來的權重。
上述房價的例子只需要幾個權重,但要理解一個句子,需要的遠遠不只這樣,因為語言比「房子越大越貴」複雜太多。所以公式就一直長大,有更多輸入、更多乘法、更多權重,而且堆成一層一層,上一層的輸出變成下一層的輸入。一直成長下去,再用一種很特定的排列方式接起來,就會得到現代所有語言模型背後的結構,就叫做 Transformer。
Transformer 就是那個公式。 它用程式碼寫成一次,而且 GPT、Claude、Llama 大致上用的是同一套,讓它們各自不同的是公式裡的權重。
這個公式,也就是 Transformer,只有一頁程式碼,而所有的知識都在權重裡。真實的模型不是只有四個或四百個權重,而是數十億個,這幾十億個數字就是訓練的產物。它們會作為一個檔案待在硬碟上,所以它僅僅是一個很大的且塞滿數字的檔案,等著被倒進公式裡。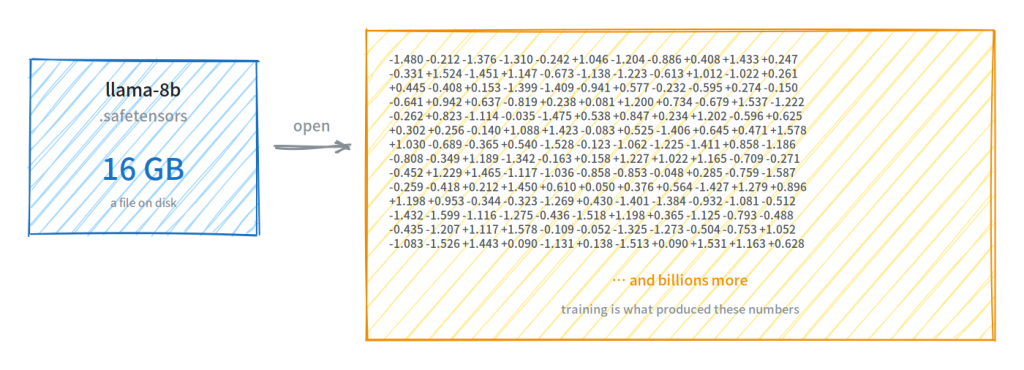
模型體積大小各不相同:
| 模型 | 檔案大小 |
|---|---|
| Llama 3.2 1B | 2 GB |
| Llama 3.1 8B | 16 GB |
| Llama 3.3 70B | 140 GB |
| DeepSeek V3 671B | 700 GB |
要使用它,就是把檔案從硬碟載入記憶體,把你的問題當輸入丟進去,讓公式把那堆數字跑過一遍,然後出來你在螢幕上看到的答案。載入檔案、餵它文字、拿回文字, 這就是最基本的運行模型。
任何一台計算機都包含 CPU 以及 RAM,當你在計算機打 6 × 7,這兩個數字會先載入記憶體裡,CPU 讀出來、做乘法、再把 42 寫回記憶體。每一次計算都是這樣一趟來回。 這同時也是 Von Neumann 架構下計算機的工作方式:要執行的指令與資料,都必定先載入記憶體。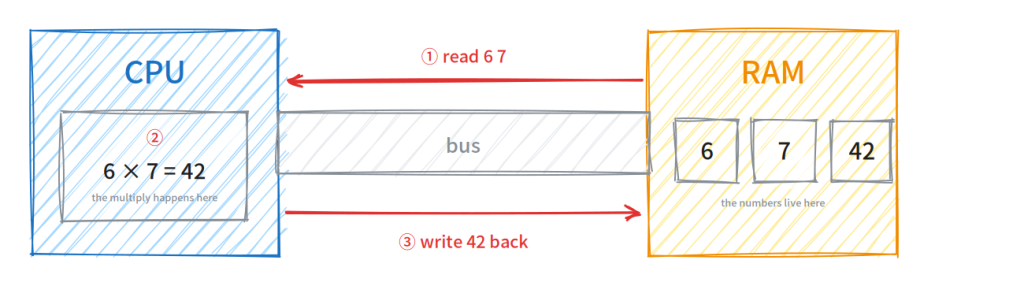
CPU 有少數幾個非常強的核心,把複雜的工作一件接一件做完,而且極快,你在電腦上做的大多事情幾乎都是靠它,比如跑瀏覽器、跑應用程式、跑作業系統。
那麼模型在底層是在做什麼?本質上來說,運行模型可以總結為幾十億次很小的乘法運算。 而且這些乘法運算彼此不相互依賴,它們可以同時平行發生。
CPU 是幾個強核心一件一件做,所以當數十億個互不相干的小乘法交給它做,它會按照順序處理,然後你就會等到天荒地老。這就是第一個問題:工作是大規模平行的,而 CPU 是為循序設計的。
所以我們需要另一種處理器,也就是 GPU。
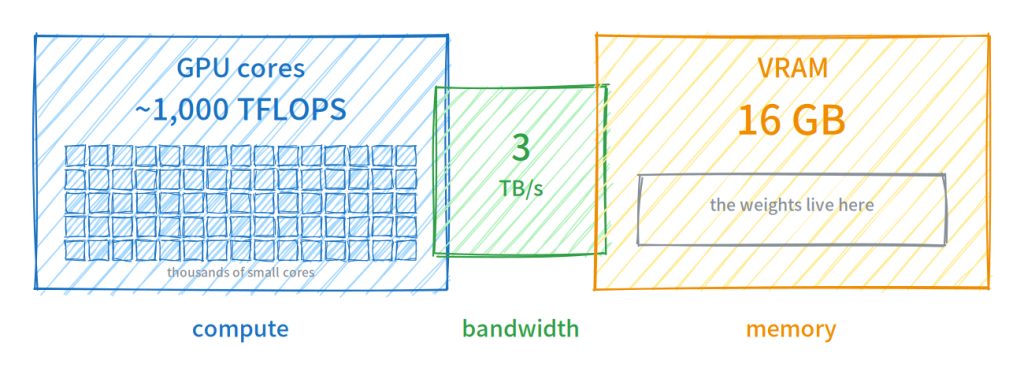
GPU 的設計方式正好相反,不是幾個強的大核心,而是幾千個簡單的小核心,同時做數學運算。 以 NVIDIA T4 來說,大約有 2,500 個這樣的小核心。CPU 每秒大約處理 10 兆次運算,而 GPU 每秒可以接近 1000 兆次運算,整整多了 100 倍。
GPU 解決了數學運算的問題,但它製造了一個新問題。CPU 需要記憶體餵它資料,GPU 也一樣,而且它要的是模型的權重,也就是那幾十億個數字,這些數字如果放在原本的 RAM 上就會有問題了,因為 RAM 在 GPU 之外,通過一條傳輸速度約 64 GB/s 的狹窄通道連接,這大概比核心吃得下的速度慢了 50 倍。
對一顆一次做幾件事的 CPU 來說沒差,但對幾千個同時討資料的 GPU 核心來說,那個遠方的記憶體根本送不夠快,核心就會閒在那裡,等數字慢慢過來。
所以 GPU 有自己的記憶體,直接做在卡上,就貼在核心旁邊,這個東西叫 VRAM。VRAM 有著更寬的通道,其傳輸速度以 TB/s 而不是 GB/s 計算,而且現在模型的權重就放在核心旁邊。
但這個解法有代價,就是容量太小。舉例來說 T4 就只有 16 GB。回頭看前面的模型尺寸表,像是 Llama 3.3 70B 就需要 140 GB 才放得下,所以 VRAM 的空間非常珍貴。
綜上所述,有三個數字決定了 AI 工作負載的規模:
| 數字 | 是什麼 |
|---|---|
| 算力(compute) | 這張卡能做多少運算 |
| 容量(capacity) | 記憶體裡裝得下多少 |
| 頻寬(bandwidth) | 它讀自己的記憶體有多快 |
| Compute | Bandwidth | Memory | |
|---|---|---|---|
| TFLOPS | TB/s | GB | |
| Desktop | 1–3(CPU) | 0.09 | 32(RAM) |
| Rack server | 5–20(CPU) | 0.5 | 512(RAM) |
| A100 | 312(GPU) | 2.0 | 80(VRAM) |
| H100 | 990(GPU) | 3.35 | 80(VRAM) |
| H200 | 990(GPU) | 4.8 | 141(VRAM) |
| B200 | 2250(GPU) | 8.0 | 192(VRAM) |
單獨一個 GPU 本身什麼也不會做,得有東西去驅動它,驅動他的軟體就叫 PyTorch,它負責把模型載到 GPU 上,然後叫那幾千個核心動起來,只需要幾行 code:
import torch
from transformers import pipeline

gen = pipeline("text-generation",
    model="meta-llama/Llama-3.2-1B",
    torch_dtype=torch.bfloat16,
    device="cuda")
out = gen("Capital of France?")
print(out[0]["generated_text"])
# -> '... Paris.'
但這只是一個 script,它跑一次、服務一個人,然後就結束了。真實的網路上,同一時間有成千上萬個使用者同時訪問,所以需要一個一直開著、監聽請求、而且有效率地跑模型的東西,那個東西就叫 model server,其中一個最廣為人知的就是 vLLM,它直接構建在 PyTorch 上面,通過標準 Web API 將模型封裝成一個服務。
起一個 model server 就一行指令,vLLM 會把模型權重從硬碟讀出來,載入 GPU VRAM,之後 model server 起來並保持運行狀態等待請求。
vllm serve Llama-3.1-8B-Instruct
至於怎麼跟它交互?就跟你呼叫任何 Web 服務一樣,而且 vLLM 使用與 OpenAI API 完全相同的格式,任何已經會跟 OpenAI 講話的工具或腳本,都可以與你的 model server 交互。
語言模型不像我們一樣讀寫完整的單字,它把文字切成小塊,那些小塊叫 token。有時候是一個完整的字,有時候只是一個字的一部分。像 serving LLMs is not like serving web apps 這句是 8 個字,但大約是 9 個 token:serving LL Ms is not like serving web apps,所有東西都用 token 衡量的,包括模型讀得了多少、你付多少錢、跑多快、生成多快。
模型本質上就是一台預測機。給它目前為止的所有文字,它預測下一個 token,然後把那個 token 接到原本的文字後面,再預測下一個,再接回去,一遍又一遍,直到生成完整的答案。
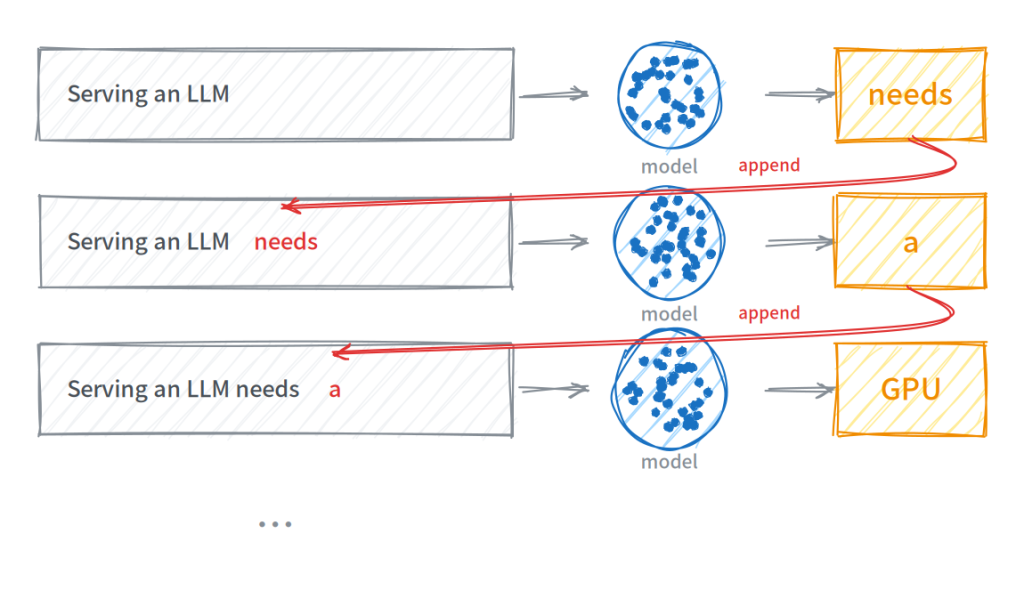
所以一個 100 token 的回答不是一次大計算,是那個迴圈跑了 100 圈,一圈一個 token。 這就是 ChatGPT 的答案會一個字一個字打出來的原因。
由此會蹦出兩個問題:
一、這種請求很久。 一般的 Web 請求幾毫秒就結束了,但幾百個 token 代表這個迴圈要跑幾百圈。
二、沒有任何兩個請求是一樣的。 問「法國首都是哪」是幾個 token 進、一兩個 token 出。但「幫我摘要這份 100 頁的合約」就是好幾萬個 token了。這兩個請求通過同一個 API 打到同一台 server,但其中一個工作量是另一個的一千倍。
把一大段文字貼進 ChatGPT,按下 Enter,會先有一兩秒什麼都沒發生的停頓,然後答案才開始一個字一個字流出來。這一開始的停頓就是 prefill,一個字一個字輸出則是 decode。
模型在寫出任何一個字之前,它會一次讀完你的整個 prompt,每個 token 一起穿過整個模型。整個模型從 VRAM 被讀出來一次,幾千個核心同時開火,一趟就把整個 prompt 嚼完。這一趟結束的時候,會產出你答案的第一個 token。
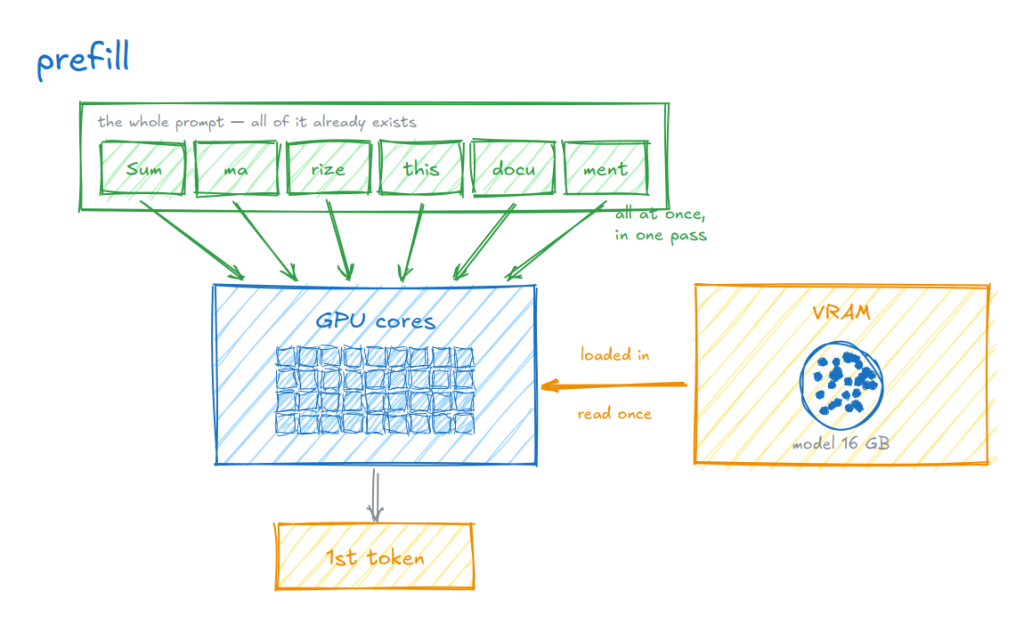
所以 prefill 的時間取決於一件事:你給了它多少東西要讀。 而 prefill 等待的時間我們稱為 TTFT(Time To First Token),即第一個 token 出現所需的時間。
decode 就是前面講的一個一個 token 的迴圈。每個 token 都要完整穿過模型一次。 這個階段的瓶頸完全不一樣,為了產出每一個新 token,GPU 必須把整個模型從記憶體讀出來。
寫一個 200 token 的答案,代表把整個模型從記憶體讀出來 200 次。每一次讀,只換到一個 token。
在 decode 階段,核心幾乎沒在做事。這個階段的速度受限於 GPU 讀自己記憶體的速度。
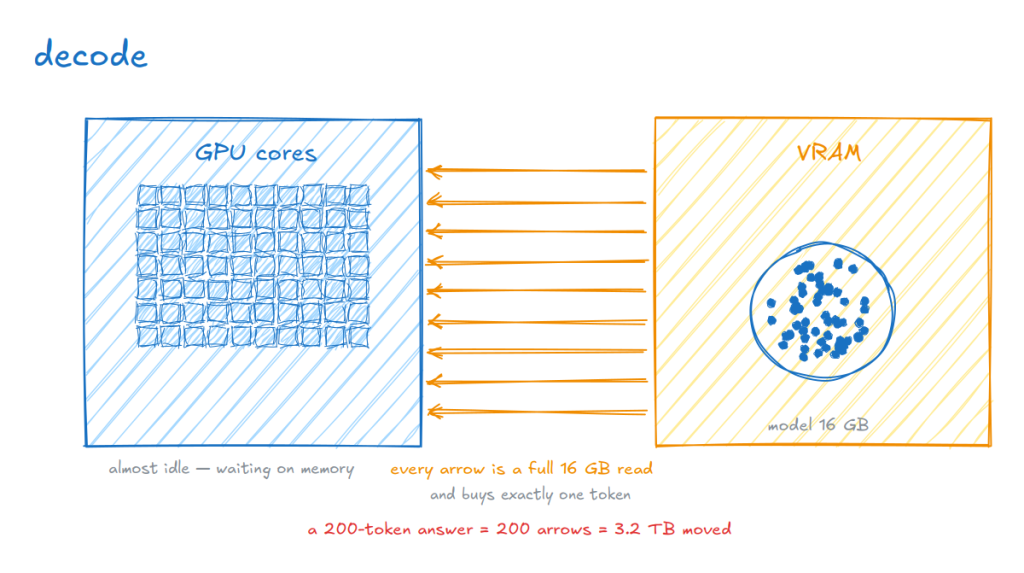
為什麼是讀取速度限制整體速度呢?因為核心很小,裝不下整個模型,所以權重住在 VRAM 裡。每產生一個 token,整個模型就從 VRAM 流到核心,被使用後再讓位給下一個 token。而這個流動是有速度上限的,高階 GPU 讀自己的記憶體大約 3 TB/s,面對一個 16 GB 的模型,代表 3 TB/s ÷ 16 GB ≈ 每秒讀完整個模型 200 次
一次讀取換一個 token,所以 每秒 200 個 token,這是上限。
Benchmark 通常會把這個數字翻過來寫成「兩個 token 之間的間隔」,大約 5 毫秒。這個間隔叫 TPOT(Time Per Output Token)。
| prefill | decode | |
|---|---|---|
| 在做什麼 | 處理原始 prompt | 一個一個寫出答案 |
| 使用者看到 | 最初的停頓 | 串流 |
| 吃什麼 | 算力 | 記憶體頻寬 |
| 性質 | 一次性的計算 | 對記憶體長時間的讀寫 |
| 指標 | TTFT | TPOT |
而現在這兩件事跑在同一張 GPU 上,輪流佔用它。
照剛剛的講法,每產生一個新 token,都要先 prefill 把前面所有東西處理一遍,再 decode 生出新字。那每一個字前面都會有一次停頓,聊天根本慢到不能用。但實際不是這樣,ChatGPT 的字是一個接一個很快出來的,中間不會卡。
prefill 會消耗大量 GPU 算力。但模型不會做完就丟掉,它把結果直接存在 GPU 記憶體裡,那份存下來工作的名字,叫 KV cache。
所以 prefill 只在最開始跑一次、把結果存進 KV cache。之後模型一個一個寫答案的時候,不會為每個新 token 重跑 prefill,它伸手到 cache 裡,把已經算好的東西重用,只在上面加一個新 token。
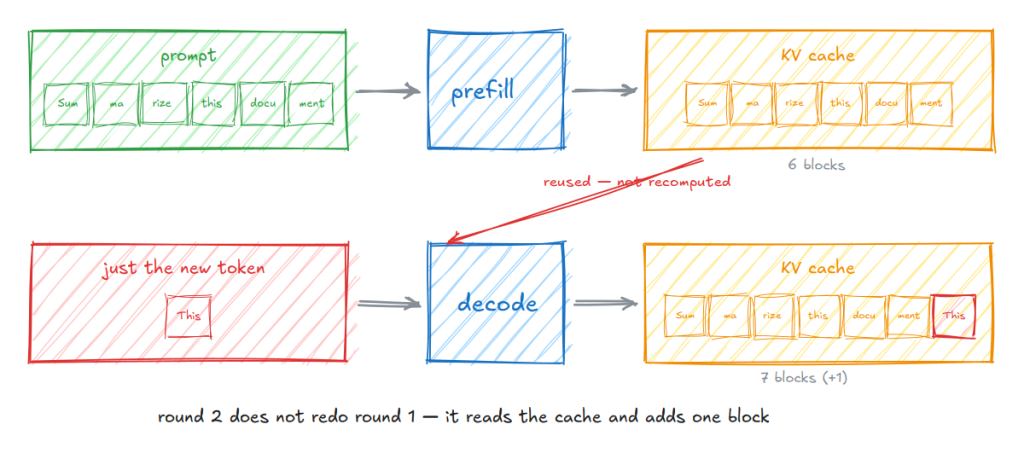
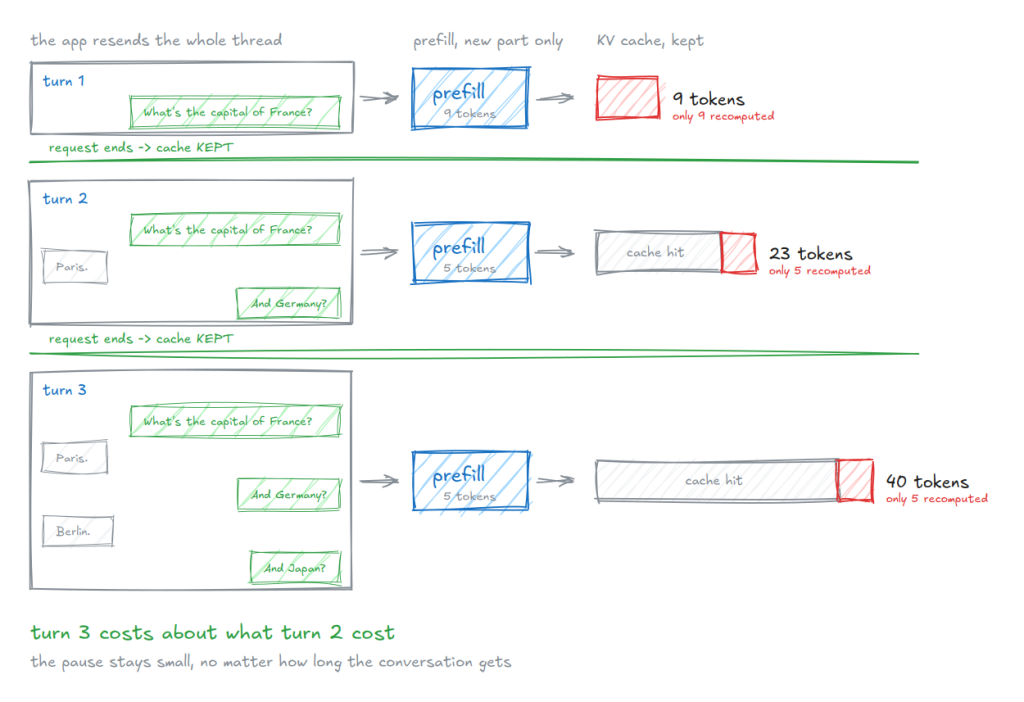
上面講的整套只涵蓋一則訊息:一個問題進去,一個答案出來。一但回覆結束,請求就完成了,cache 就會被清掉。
那你在同一個對話裡送出第二則訊息會怎樣?答案是模型在訊息之間什麼都不記得。 所以你的聊天 app 每一次都把整個對話串重送一遍,你的第一個問題、模型的第一個回答、加上你的新訊息,全部打包成一個請求。每一輪都把之前的工作從零重建,然後再丟掉。
所以你聊越久,等越久。一段對話的成本,會隨著每一則訊息一直增長,因為必須對每則訊息都執行 prefill。
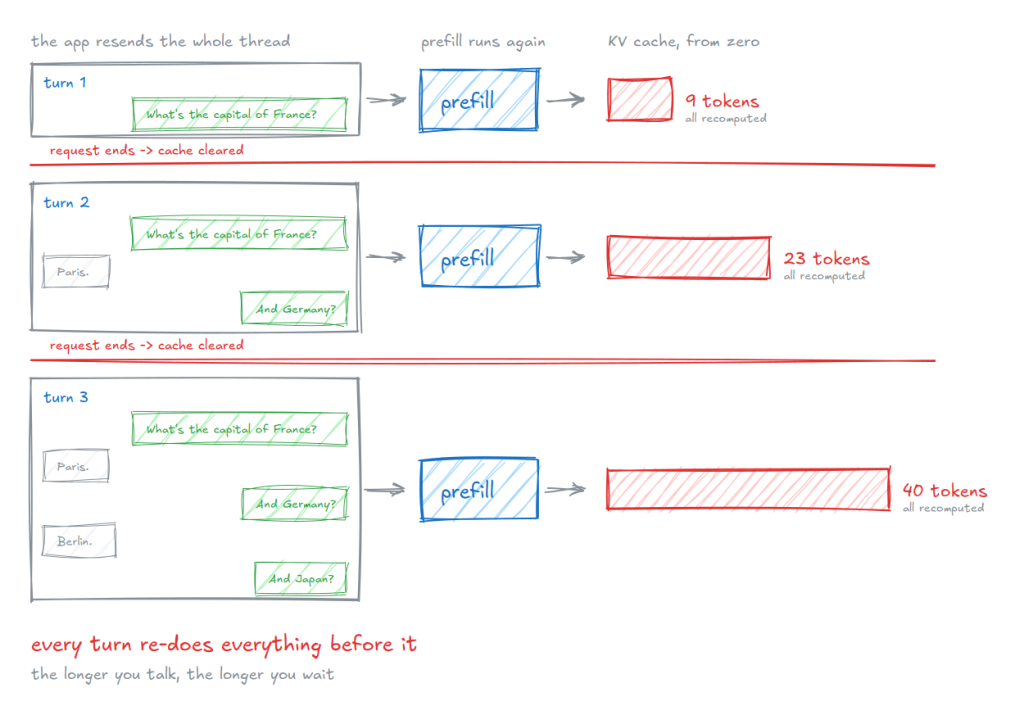
於是我們選擇在請求結束的時候不把 cache 丟掉,每一塊用產生它的那段文字來標記。
第二輪來的時候,模型看一眼你的對話串,發現除了你最新那則訊息之外,其他全部都已經算過了。只有最新那一段需要真的去 prefill。你發現第 10 輪的成本,大概跟第 2 輪差不多。不管對話多長,停頓都維持很小。
這個做法就叫 prefix caching。
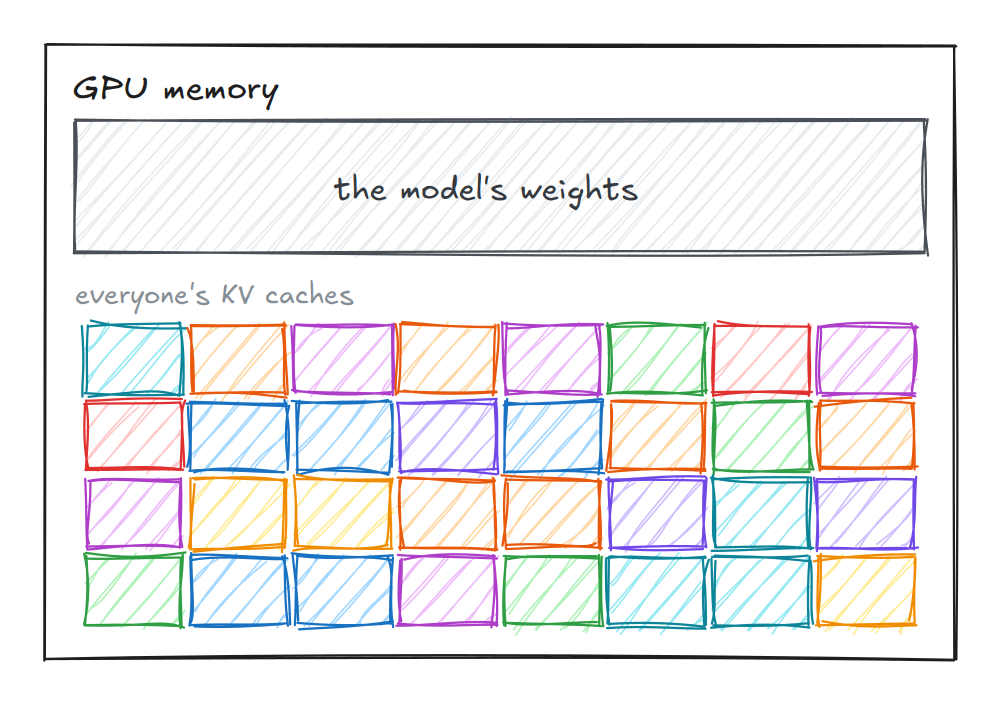
現實中單張 GPU 是會服務多個使用者的,前面講過每產生一個 token,GPU 都要把整個模型從記憶體讀出來,而這個讀取操作才是真正的成本。所以既然 GPU 為了幫一個人生一個 token 就把整個模型讀一遍,那乾脆趁同一次讀取,同時幫很多人生下一個 token。同一次讀取,可以換到「一個人的一個 token」,也可以換到「50 個人的 50 個 token」。
這就是 batching:把很多人的請求打包成一組,一起穿過 GPU。
答案是記憶體,而這就是 batching 的天花板。
batch 裡的每一個使用者,都有自己的那份 KV cache,而在他被服務的整段時間裡,他的 KV cache 都待在 GPU 記憶體裡。那塊記憶體本來就很小,而且大部分已經被整個模型佔走了,剩下的空間才是所有人 KV cache 的空間。
所以記憶體很快就用完了,但核心裡還有大把算力閒著,這也是現實世界裡大量金錢被浪費掉的地方,也能看出是記憶體決定了一張 GPU 能服務多少人。
記憶體不只決定一張 GPU 能塞多少人,它還決定模型放不放得進去。 通常太大的模型沒有辦法放在一張 GPU,所以會拿好幾張 GPU,把模型切成很多片,每一片放一張 GPU。前面提到的 vLLM 自己就能把模型切開跨 GPU。只要給它一個巨型模型,告訴它有幾張卡即可。
選哪一種,取決於這些 GPU 實體上放在哪裡。
| 位置 | 連線 | 用哪種切法 |
|---|---|---|
| 同一台機器內 | NVLink,超高速專用連結 | within a layer |
| 跨機器 | 普通網路,慢很多 | by layer |
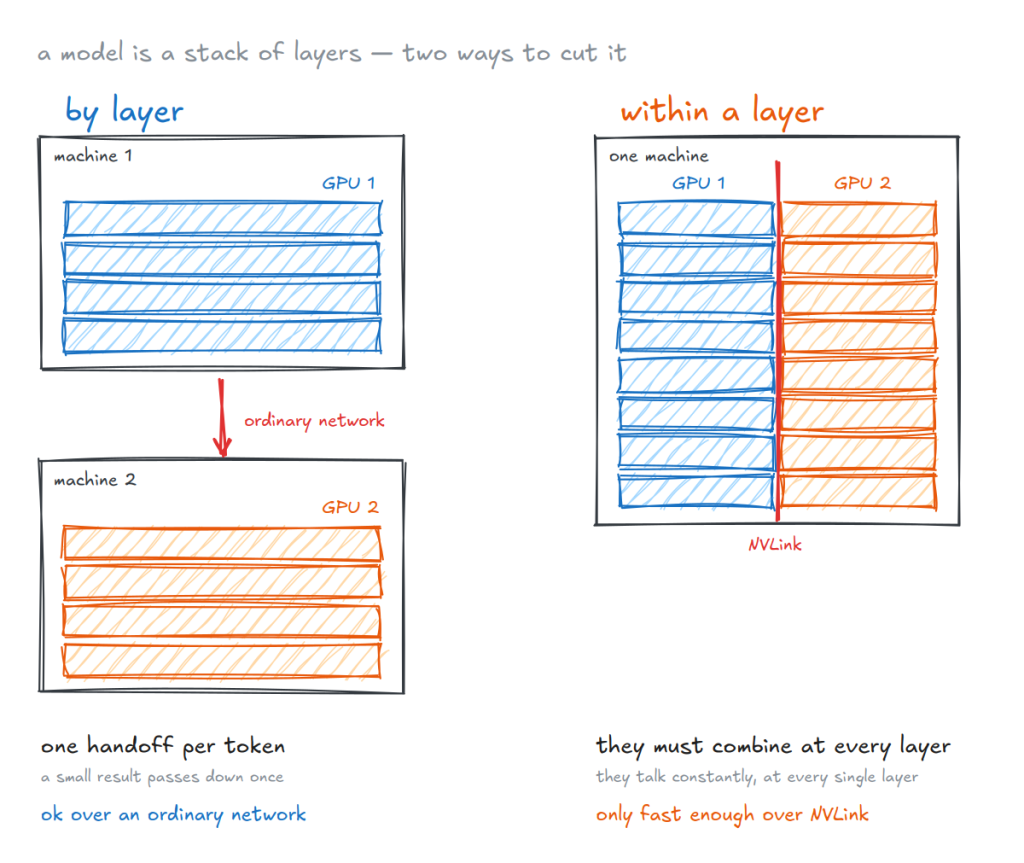
這個技術叫 sharding。它解決了「放不下」的問題,規則很簡單:頻繁的通訊留在機器內部,輕量的通訊保留在機器之間。一個對單張 GPU 太大的模型,現在可以用一台機器、或好幾台機器的 GPU,當成一台邏輯上的 server 來跑。
真實的服務不會只跑在一台 server 上,而是有一整個 fleet,每一台 server 都有自己的 GPU,帶著自己那一份模型副本。那我的請求怎麼到其中一台?我們下意識會在 fleet 前面擋一個 load balancer,把進來的請求平均分散到每一台 server。
但對語言模型來說,這是錯的,有兩個原因。
假設送出第一則訊息,落到 server 2。它讀了對話,把工作存在 KV cache。過一會兒送出第二則訊息,透過 load balancer 這則訊息送到 server 5。而 server 5 什麼都沒存,只能把整段對話從頭再讀一次,代表 prefill 又重來了一遍。
load balancer 假設每個請求大致同樣大小,所以平均散開請求,但我們已經知道,沒有任何兩個語言模型請求是同樣大小的。一個可能只是打聲招呼,下一個是要摘要 50 頁文字。但對 load balancer 來說,這兩個請求長得一模一樣。所以它可能把那個 50 頁的請求,送給一台已經忙著串流答案給 30 個人的 server,導致那 30 個人全部變慢。
所以服務語言模型,需要一種比我們以前用過的任何東西都聰明得多的路由方式。
- 模型本來就勉強塞得進記憶體
- 每一個 token 都逼 server 把整個模型從頭重讀一次
- server 為你算好的東西,卡在那一台上
- 記憶體還決定了一台 server 同時能扛多少人
- 而如果路由再做錯,你就是在浪費你最貴的硬體 - GPU 算力週期
這道牆擋住了整個業界。 所以 Red Hat、Google、IBM 跟 NVIDIA 決定一起、在開源的方式下解決它。
他們做出來的東西叫 llm-d。
llm-d 的核心是一個坐在整個 server fleet 前面的聰明路由器。
請求進來的時候,它不會隨便丟給下一台剛好有空的 server。它會停下來想:這個請求應該去哪裡? 然後送給最有能力處理它的那一台。
它看三件事:
正如 Day1 提到的,66% 託管生成式 AI 的組織,用 Kubernetes 管理它們一部分或全部的推論工作負載。llm-d 主要也運行在 Kubernetes 上。我們先以一個宏觀的角度看叢集的整個架構大致長怎樣:
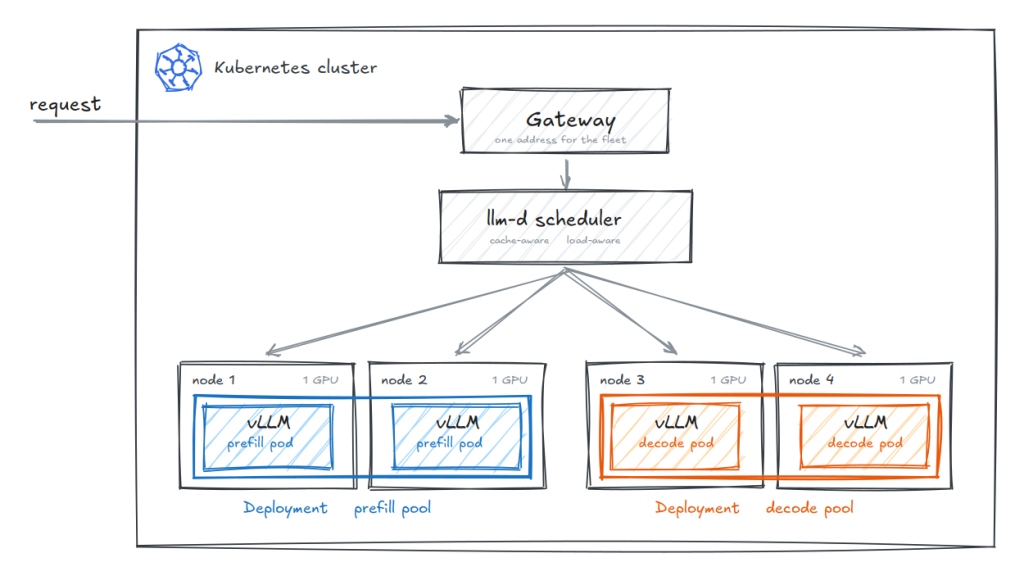
在 Kubernetes 上,vLLM 以一個 Pod 的單位運行,一組相同的 Pod 稱為 Deployment,而 Deployment 也代表我們的 prefill pool 與 decode pool。但 Deployment 對於這整個場景有它的痛點,於是 Kubernetes 構建了一個新的 API 對象 - LeaderWorkerSet,會在後面的三十天連同 llm-d 的細節一同學習。
Day 2,aka 夢開始的地方,今天統整了 LLM 背後的原理,包括模型怎麼運作的,以及一句話進到 LLM 背後發生了什麼,相信以後 prompt 下出去,看到的不只是它回給我的 answer,而是 LLM 的整個全貌。那明天會講普世價值觀下 Kubernetes 是怎麼要 GPU 的,也就是 Device Plugin。
AI Infrastructure: LLM-D, vLLM and GPUs


 iThome鐵人賽
 看影片追技術