

DRA 讓「我要一張卡」變成叢集裡的一個物件,也讓多個 Pod 共用同一張卡變得可能。但那個共用是整張卡一起共用:幾個 Pod 參照同一份 ResourceClaim,各自拿到整張 GPU 的存取權,誰要用多少、會不會把別人的記憶體吃光,Kubernetes 完全管不著。
NVIDIA 自己的 time-slicing 也是同樣的處境。device plugin 把一張卡發布成 N 份 replica,落在同一張卡上的工作靠 GPU 的時間分片輪流執行,plugin 本身不提供任何隔離。
那有隔離的呢?MIG。但 MIG 要 Ampere 以後的特定型號、規格是固定的幾種 profile、重新切還要卡閒置。你想要「這個 Pod 給我 4GB 加三成算力」這種粒度,MIG 給不了。
今天的主角 HAMi(Heterogeneous AI Computing Virtualization Middleware)就是補這一塊的。它用軟體的方式做 GPU 虛擬化,讓你能以 記憶體 MB 數 + 算力百分比 為單位切卡,而且不挑型號。更重要的是,HAMi 現在有了自己的 DRA driver,這讓它能接上 DRA 那一整套 API。
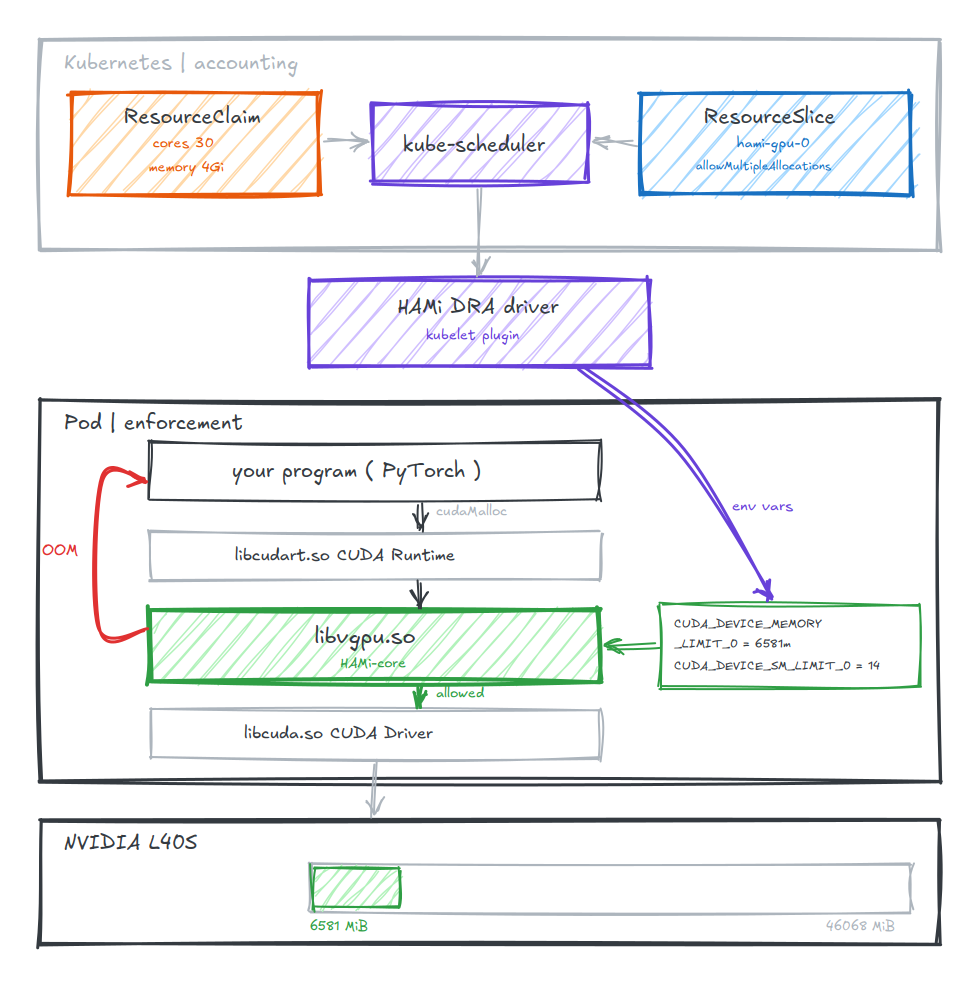
HAMi 的核心是 HAMi-core,實體是一個 libvgpu.so,被 preload 進容器裡。它攔截的位置很精確:在 CUDA Runtime(libcudart.so)和 CUDA Driver(libcuda.so)之間劫持 API 呼叫。
記憶體走的是硬擋。程式要記憶體的時候,請求會先經過 HAMi-core,它記著這個容器的額度,只要目前用量加上這次請求超過 CUDA_DEVICE_MEMORY_LIMIT_<index>,就直接回傳 CUDA_ERROR_OUT_OF_MEMORY,根本不會傳到底下真正的驅動。
同樣地,程式問「這張卡有多少記憶體」,它回答的也是額度,不是實體卡的數字。
算力則完全是另一套機制,掛在 kernel 送出去的那一刻:cuLaunchKernel、cuLaunchKernelEx 這些提交函式,每次提交前都會先呼叫 rate_limiter;計數器用完(小於 0)時,這次呼叫就進入 nanosleep 的 spin-wait。計數器再依照實際採樣到的使用率動態補回去,讓容器的用量逐漸收斂到設定的百分比。
所以 HAMi 的隔離要分兩層講:記憶體是硬限制,算力是軟限制。記憶體超了就是拿不到;算力則是統計上壓在那個比例附近,不是硬體級的保證。
而且這裡的「硬」跟 MIG 的「硬」不是同一種。MIG 是硬體擋你,HAMi 是跟你跑在同一個行程裡的一個 .so 擋你,程式繞過 CUDA API 或拿掉 LD_PRELOAD,限制就不存在了。它防的是無心的鄰居,不是有意的攻擊者。跟 MIG 比它當然弱,但它不挑卡,粒度也隨你開。
HAMi 本來走的是 Device Plugin 路線,靠 nvidia.com/gpumem、nvidia.com/gpucores 這類 extended resource,外加自己的 scheduler extender。今天要玩的是它的另一條路:DRA 模式。
前面跑過的 Consumable Capacity(KEP-5075),是 HAMi 這條 DRA 路線能成立的前提。
它讓各自獨立的 ResourceClaim 從同一個裝置上分走一份容量,所以共用同一張卡的兩個 Pod 不必是同一個人開的,也不必知道彼此的 claim 叫什麼名字。
拼起來就是一句話:Kubernetes 記帳,HAMi-core 執行。 排程器算清楚這張卡還剩多少能配,HAMi-core 在容器裡把每個人壓在自己的額度內。
這次的環境會用 Day1 建立的真卡環境,也就是 AWS 上的兩台機器,各掛一張 NVIDIA L40S:
nvidia-smi --query-gpu=name,driver_version,memory.total --format=csv,noheader
NVIDIA L40S, 580.159.04, 46068 MiB
叢集上已經裝好 NVIDIA GPU Operator,而且是跑在 DRA 模式的。從既有的 ResourceClaim 就看得出來:
kubectl get resourceclaim -A
NAMESPACE      NAME                                              STATE                AGE
gpu-operator   nvidia-dcgm-exporter-dra-86s4d-admin-gpus-p2clw   allocated,reserved   4d2h
gpu-operator   nvidia-dcgm-exporter-dra-s2kc9-admin-gpus-9b5b2   allocated,reserved   4d2h
gpu-operator   nvidia-dra-validator-gxd8g-validation-gpu-bs6b8   allocated,reserved   4d2h
gpu-operator   nvidia-dra-validator-xvtj2-validation-gpu-ddgwm   allocated,reserved   4d2h
這幾個 claim 的名字都是 <pod-name>-<claim-name>-<亂碼> 的形式,一看就知道是 ResourceClaimTemplate 幫每個 Pod 各生一份的結果。DCGM exporter 和 validator 是 DaemonSet,每個節點一份,正好是範本最典型的用法。
NVIDIA 的 driver 發布了這些 ResourceSlice:
kubectl get resourceslice -o custom-columns='DRIVER:.spec.driver,NODE:.spec.nodeName'
DRIVER                      NODE
compute-domain.nvidia.com   ip-172-31-26-39
compute-domain.nvidia.com   ip-172-31-30-5
gpu.nvidia.com              ip-172-31-26-39
gpu.nvidia.com              ip-172-31-30-5
以及這些 DeviceClass:
kubectl get deviceclass
NAME                                        AGE
compute-domain-daemon.nvidia.com            4d2h
compute-domain-default-channel.nvidia.com   4d2h
gpu.nvidia.com                              4d2h
mig.nvidia.com                              4d2h
vfio.gpu.nvidia.com                         4d2h
這份清單其實就是 NVIDIA 各種 GPU 共用機制的 Kubernetes 版本目錄:gpu.nvidia.com 是整張卡,mig.nvidia.com 是 MIG instance,vfio.gpu.nvidia.com 是直通給 VM 的路徑。管理員在 DeviceClass 這一層就先把「有哪幾種拿卡的方式」畫好了範圍。
最後確認 feature gate 有開:
kubectl get --raw /metrics | grep DRAConsumableCapacity
kubernetes_feature_enabled{name="DRAConsumableCapacity",stage="BETA"} 1
1 表示啟用中,stage="BETA" 表示這個版本的叢集已經預設打開它了。如果你的叢集顯示 0 或查不到,下面的實驗都不會動,要先在 apiserver、scheduler、controller-manager、kubelet 四個地方一起打開。
git clone https://github.com/Project-HAMi/k8s-dra-driver.git
cd k8s-dra-driver
kubectl apply -f demo/yaml/rbac.yaml
namespace/hami-dra-driver created
serviceaccount/hami-dra-driver-service-account created
role.rbac.authorization.k8s.io/hami-dra-driver-role created
rolebinding.rbac.authorization.k8s.io/hami-dra-driver-role-binding created
clusterrole.rbac.authorization.k8s.io/hami-dra-driver-clusterrole created
clusterrolebinding.rbac.authorization.k8s.io/hami-dra-driver-clusterrole-binding-hami-dra-driver created
kubectl apply -f demo/yaml/ds.yaml
daemonset.apps/hami-dra-driver-kubelet-plugin created
kubectl get pods -n hami-dra-driver -o wide
NAME                                   READY   STATUS    RESTARTS   AGE   IP           NODE              NOMINATED NODE   READINESS GATES
hami-dra-driver-kubelet-plugin-fjmbm   1/1     Running   0          12s   10.42.0.28   ip-172-31-26-39   <none>           <none>
hami-dra-driver-kubelet-plugin-vhntn   1/1     Running   0          12s   10.42.1.14   ip-172-31-30-5    <none>           <none>
兩個節點各一份 kubelet plugin,DaemonSet 的標準長相。
裝進來的是一支獨立的 DRA driver,不是 HAMi 本體。這條路不需要 HAMi 自己的 scheduler,也不需要它的 device plugin,排程完全交給 kube-scheduler,HAMi 只負責容器裡的強制。
負責強制的 libvgpu.so 包在這支 driver 的 image 裡,DaemonSet 起來時用 postStart 跑 vgpu-init.sh,把它倒到主機的 /usr/local/vgpu。後面容器裡看到的那顆 .so,就是從這個目錄掛進去的。
driver 裝好之後再看一次 ResourceSlice,多了兩筆:
kubectl get resourceslice -o custom-columns='NAME:.metadata.name,DRIVER:.spec.driver,DEVICES:.spec.devices[*].name'
NAME                                                    DRIVER                          DEVICES
00000-compute-domain.nvidia.com-ip-172-31-26-39-wjqxb   compute-domain.nvidia.com       channel-0,daemon-0
00000-compute-domain.nvidia.com-ip-172-31-30-5-wspdh    compute-domain.nvidia.com       channel-0,daemon-0
00000-gpu.nvidia.com-ip-172-31-26-39-2m8sz              gpu.nvidia.com                  gpu-0
00000-gpu.nvidia.com-ip-172-31-30-5-r8rfl               gpu.nvidia.com                  gpu-0
ip-172-31-26-39-hami-core-gpu.project-hami.io-k78cv     hami-core-gpu.project-hami.io   hami-gpu-0
ip-172-31-30-5-hami-core-gpu.project-hami.io-h2vrh      hami-core-gpu.project-hami.io   hami-gpu-0
每個節點上,gpu.nvidia.com 說有一張 gpu-0,hami-core-gpu.project-hami.io 說有一張 hami-gpu-0。但節點上明明只有一張實體卡。
把兩邊攤開來比對一下:
kubectl get resourceslice -o json | python3 -c "
import sys, json
for s in json.load(sys.stdin)['items']:
    sp = s['spec']
    if sp['nodeName'] != 'ip-172-31-26-39': continue
    if 'compute-domain' in sp['driver']: continue
    d = sp['devices'][0]
    print('===', sp['driver'])
    print('  name :', d['name'])
    print('  uuid :', d['attributes'].get('uuid', {}).get('string'))
    print('  multi:', d.get('allowMultipleAllocations'))
    print('  cap  :', {k: (v['value'], 'requestPolicy' in v) for k, v in d['capacity'].items()})"
=== gpu.nvidia.com
  name : gpu-0
  uuid : GPU-91d41994-8efd-d6b4-c945-5912422ff4a8
  multi: None
  cap  : {'memory': ('46068Mi', False)}
=== hami-core-gpu.project-hami.io
  name : hami-gpu-0
  uuid : GPU-91d41994-8efd-d6b4-c945-5912422ff4a8
  multi: True
  cap  : {'cores': ('100', True), 'memory': ('46068Mi', True)}
UUID 一模一樣。這確實是同一張實體 L40S,被兩支 driver 各自登記了一次,但登記的方式完全不同:
gpu.nvidia.com |
hami-core-gpu.project-hami.io |
|
|---|---|---|
allowMultipleAllocations |
沒設(等同 false) | true |
| capacity 項目 | 只有 memory |
cores 和 memory |
| 有沒有 requestPolicy | 沒有 | 兩項都有 |
NVIDIA 那筆的意思是「這張卡就是一整張,要就整張拿走」。memory: 46068Mi 只是個描述性的屬性,沒有 requestPolicy,你沒辦法對它說「我只要其中 4GB」。
HAMi 那筆則是「這張卡可以被多份 claim 同時分配,總共有 100 份算力和 46068Mi 記憶體可以切,而且你可以指定要多少」。cores: 100 的 100 是百分比,requestPolicy 則規範了單次請求的合法範圍。
這就是 consumable capacity 在 API 上長的樣子。同一顆 GPU,一個 driver 把它當成不可分割的一個單位,另一個把它當成一池可以分批領用的額度。
(Kubernetes 並不知道 gpu-0 和 hami-gpu-0 是同一張卡。它們是兩支 driver 底下的兩個獨立裝置,排程器分別記帳。也就是說,如果有人用 gpu.nvidia.com 整張要走,同時又有人透過 HAMi 切走 8GB,排程器兩邊都會放行,實際上卻是在搶同一張卡。所以正式環境最好不要讓兩支 driver 同時對外提供同一張 GPU。)
接著套用 demo 的 setup:
kubectl apply -f demo/yaml/setup.yaml
deviceclass.resource.k8s.io/hami-core-gpu.project-hami.io created
namespace/test-dra created
resourceclaim.resource.k8s.io/single-gpu-0 created
resourceclaim.resource.k8s.io/double-gpu-0 created
resourceclaimtemplate.resource.k8s.io/single-gpu-tpl created
一口氣建了 DRA 四種物件裡的三種。先確認 DeviceClass 進去了:
kubectl get deviceclass | grep hami
hami-core-gpu.project-hami.io 29s
single-gpu-0 這份 claim 長這樣:
apiVersion: resource.k8s.io/v1
kind: ResourceClaim
metadata:
  namespace: test-dra
  name: single-gpu-0
spec:
  devices:
    requests:
    - name: gpu
      exactly:
        deviceClassName: hami-core-gpu.project-hami.io
        allocationMode: ExactCount
        count: 1
        capacity:
          requests:
            cores: 30
            memory: "4Gi"
跟一般的 DRA claim 比,多出來的就是 capacity.requests 這一段。原本只能說「給我一個 hami-core-gpu.project-hami.io」,現在可以說「給我一個,而且我要它 30% 的算力和 4GB 記憶體」。
至於 double-gpu-0,官方 README 展示的是在同一份 claim 裡開兩個規格不同的 request:
spec:
  devices:
    requests:
    - name: double-gpu-0-0
      exactly:
        ...
        capacity:
          requests:
            cores: 30
            memory: "4Gi"
    - name: double-gpu-0-1
      exactly:
        ...
        capacity:
          requests:
            cores: 60
            memory: "8Gi"
這是 extended resource 完全表達不了的東西。nvidia.com/gpu: 2 只能說兩張一樣的,說不了「一張小的加一張大的」。
現在看看這兩份 claim 的狀態:
kubectl -n test-dra get resourceclaim
NAME           STATE     AGE
double-gpu-0   pending   39s
single-gpu-0   pending   39s
都是 pending。claim 建立不等於裝置被分配,要等到有 Pod 參照它、排程器挑好節點,才會真的配下去。
pod-0.yaml 的內容:
---
apiVersion: v1
kind: Pod
metadata:
  namespace: test-dra
  name: pod-0
spec:
  containers:
  - name: ctr0
    image: ubuntu:24.04
    command: ["bash", "-c"]
    args: ["export; trap 'exit 0' TERM; sleep 9999 & wait"]
    resources:
      requests:
        cpu: 1
      limits:
        cpu: 1
      claims:
      - name: single-gpu
  resourceClaims:
  - name: single-gpu
    resourceClaimName: single-gpu-0
這裡有三個名字在互相牽線,值得看清楚:Pod 層級的 resourceClaims 取了一個本地代號 single-gpu,指向真正存在的 claim single-gpu-0;容器再用 resources.claims 引用那個本地代號。這一層間接的好處是,同一個 Pod 裡哪些容器要吃這份 claim、哪些不要,可以分開寫。
注意它用的是 resourceClaimName 而不是 resourceClaimTemplateName,也就是直接參照前面那份已經存在的 single-gpu-0。容器本身只是 export 完就睡,我們要看的是它的環境變數。
kubectl apply -f demo/yaml/pod-0.yaml
kubectl -n test-dra get pod pod-0
NAME    READY   STATUS    RESTARTS   AGE
pod-0   1/1     Running   0          9s
跑起來了。進去看容器拿到什麼:
kubectl -n test-dra logs pod-0 | grep -iE "cuda|vgpu"
declare -x CUDA_DEVICE_MEMORY_LIMIT_0="4096m"
declare -x CUDA_DEVICE_MEMORY_SHARED_CACHE="/usr/local/vgpu/claims/ea223ab8-0ac0-4e80-9e81-a9cdceb0ab2f/3226aba4-f6ec-4303-bcc6-7d9bb1eb88f7.cache"
declare -x CUDA_DEVICE_SM_LIMIT_0="30"
declare -x NVIDIA_CTK_LIBCUDA_DIR="/usr/lib/x86_64-linux-gnu"
一行一行看:
CUDA_DEVICE_MEMORY_LIMIT_0="4096m":claim 裡寫的 memory: "4Gi" 變成了 HAMi-core 認得的記憶體上限。結尾的 _0 是裝置索引,多張卡時會有 _1、_2。CUDA_DEVICE_SM_LIMIT_0="30":對應 cores: 30,算力上限三成。CUDA_DEVICE_MEMORY_SHARED_CACHE:HAMi-core 記帳用的共享檔案。路徑裡的第一段 UUID 正是 ResourceClaim 的 UID,第二段則對應到這次分配的那一「份」。Consumable capacity 講的 ShareID,在檔案系統上就是長這個樣子。換句話說,Kubernetes 那邊的 capacity.requests 就是透過這幾個環境變數,一路傳到容器裡的 HAMi-core 手上的。
環境變數有了,但那只是宣告。HAMi 到底有沒有真的擋住?我另外寫了一份 claim 和一個 Pod,把整條證據鏈一次走完:
claim 寫 6581Mi
  → 環境變數 CUDA_DEVICE_MEMORY_LIMIT_0
  → nvidia-smi 回報的總量
  → PyTorch 看到的總量
  → 真的配到失敗的位置
額度刻意挑 6581Mi 這種不是整數 GB 的數字。容器裡如果回報一模一樣的值,就不可能是湊巧。
---
apiVersion: resource.k8s.io/v1
kind: ResourceClaim
metadata:
  namespace: test-dra
  name: mem-wall
spec:
  devices:
    requests:
    - name: gpu
      exactly:
        deviceClassName: hami-core-gpu.project-hami.io
        allocationMode: ExactCount
        count: 1
        capacity:
          requests:
            cores: "14"
            memory: 6581Mi
---
apiVersion: v1
kind: Pod
metadata:
  namespace: test-dra
  name: memwall
spec:
  restartPolicy: Never
  containers:
  - name: ctr
    image: pytorch/pytorch:2.5.1-cuda12.4-cudnn9-runtime
    command: ["python", "-u", "-c"]
    args:
    - |
      import subprocess
      def sh(cmd):
          r = subprocess.run(["bash", "-c", cmd], capture_output=True, text=True)
          return (r.stdout + r.stderr).rstrip() or "(沒有輸出)"
      def section(title):
          print()
          print("=" * 56)
          print(title)
          print("=" * 56)

      # ---------- 1. claim 的數字有沒有變成環境變數 ----------
      section("1. 容器裡的環境變數")
      print(sh("env | grep -iE 'cuda|vgpu|nvidia' | sort"))

      section("2. libvgpu.so 在不在")
      print(sh("ls -l /usr/local/vgpu/"))

      # ---------- 2. nvidia-smi 回報多少 ----------
      section("3. nvidia-smi 看到的總量")
      print(sh("nvidia-smi --query-gpu=name,memory.total --format=csv"))

      # ---------- 3. PyTorch 看到多少 ----------
      section("4. PyTorch 看到的總量")
      import torch
      free, total = torch.cuda.mem_get_info()
      props = torch.cuda.get_device_properties(0)
      print(f"device      : {props.name}")
      print(f"total(prop) : {props.total_memory // 1024**2} MiB")
      print(f"total(info) : {total // 1024**2} MiB")
      print(f"free(info)  : {free // 1024**2} MiB")

      # ---------- 4. 一直要,看擋在哪 ----------
      section("5. 每次配 256 MiB,配到失敗為止")
      blocks, got = [], 0
      try:
          for _ in range(400):
              blocks.append(torch.empty(256 * 1024 * 1024 // 2,
                                        dtype=torch.float16, device="cuda"))
              got += 256
              print(f"  allocated {got} MiB", flush=True)
      except Exception as e:
          print()
          print(f"STOPPED AT  : {got} MiB")
          print(f"REASON      : {type(e).__name__}: {str(e)[:200]}")
      else:
          print()
          print(f"NO WALL     : allocated {got} MiB without failing")
    resources:
      claims:
      - name: gpu
  resourceClaims:
  - name: gpu
    resourceClaimName: mem-wall
cores 這裡寫成字串 "14",memory 則直接寫 6581Mi,兩種寫法都能被接受。最後那個 else 分支是刻意留的:如果 400 次都沒撞牆,就印出 NO WALL,代表限制根本沒生效。
kubectl apply -f ../hami.yaml
resourceclaim.resource.k8s.io/mem-wall created
pod/memwall created
kubectl -n test-dra get pod memwall -w
NAME      READY   STATUS      RESTARTS   AGE
memwall   0/1     Completed   0          40s
跑完了,來看結果。
CUDA_DEVICE_MEMORY_LIMIT_0=6581m
CUDA_DEVICE_MEMORY_SHARED_CACHE=/usr/local/vgpu/claims/a1d34f26-47d2-4753-9352-2f8cef8b724b/a2189009-7908-43ff-9120-4ab892aecbb5.cache
CUDA_DEVICE_SM_LIMIT_0=14
LD_LIBRARY_PATH=/usr/local/nvidia/lib:/usr/local/nvidia/lib64
NVIDIA_CTK_LIBCUDA_DIR=/usr/lib/x86_64-linux-gnu
NVIDIA_DRIVER_CAPABILITIES=compute,utility
NVIDIA_VISIBLE_DEVICES=void
PATH=/usr/local/nvidia/bin:/usr/local/cuda/bin:/opt/conda/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin
額度如預期是 6581m / 14,第一棒交接成功。但這裡還有一個值得注意的地方:NVIDIA_VISIBLE_DEVICES=void。
void 對 NVIDIA Container Runtime 來說是「什麼都別做」的意思。卡不是靠這個老牌的環境變數注入進來的——DRA 走的是 CDI,由 kubelet plugin 決定要掛哪些裝置節點和函式庫進容器。
順帶一提,這份清單裡也沒有 LD_PRELOAD。
total 676
drwxr-xr-x 3 root root   4096 Sep 18 09:08 claims
-rwxr-xr-x 1 root root 685576 Sep 18 07:39 libvgpu.so
在。這顆 685KB 的 .so 就是整套隔離的執行者,旁邊的 claims 目錄則放著剛剛那個 shared cache。
name, memory.total [MiB]
NVIDIA L40S, 6581 MiB
[HAMI-core Msg(49:126767197919040:multiprocess_memory_limit.c:703)]: Cleanup on exit for PID 49
[HAMI-core Msg(49:126767197919040:multiprocess_memory_limit.c:739)]: Exit cleanup complete for PID 49
這一行是整篇文章的重點。
實體卡是 46068 MiB,但容器裡的 nvidia-smi 回報 6581 MiB,跟 claim 裡寫的數字一字不差。卡的型號還是 L40S,記憶體卻縮水成我們申請的額度。HAMi-core 攔截了查詢,把答案改掉了。
拿 time-slicing 來對照就很明顯:那邊容器裡的 nvidia-smi 看到的是完整的一張卡和完整的記憶體,兩個行程互相不知道對方存在,也不知道自己該客氣一點。這裡則是連「這張卡有多大」這個認知都被改寫了。
下面那兩行 HAMI-core Msg 是 HAMi-core 自己的 log——nvidia-smi 是原廠工具,它不會印這個。看到它就代表連原廠工具都被攔了。
[HAMI-core Msg(1:139690221042560:libvgpu.c:870)]: Initializing.....
[HAMI-core Msg(1:139690221042560:libvgpu.c:909)]: Initialized
device      : NVIDIA L40S
total(prop) : 6581 MiB
total(info) : 6581 MiB
free(info)  : 6155 MiB
nvidia-smi 被騙了不稀奇,框架會不會被騙才是重點。PyTorch 從 device property 和 cudaMemGetInfo 兩條路問到的答案都是 6581 MiB。
這件事的實際意義比看起來大:很多框架會依照「這張卡有多大」來決定 batch size、記憶體池的預留量、要不要開 gradient checkpointing。在沒有隔離的共用環境下,框架以為自己有整張卡,於是放手去吃,然後大家一起 OOM。在 HAMi 底下,框架從一開始就是照著 6581 MiB 在規劃的。
free(info) 是 6155 MiB,比 total 少了約 426 MiB,那是 CUDA context 本身的開銷。這個開銷也算在你的額度裡。
  allocated 256 MiB
  allocated 512 MiB
  ...
  allocated 5888 MiB
  allocated 6144 MiB
[HAMI-core ERROR (pid:1 thread=139690221042560 allocator.c:52)]: Device 0 OOM 7157579776 / 6900678656
[HAMI-core ERROR (pid:1 thread=139690221042560 allocator.c:52)]: Device 0 OOM 7157579776 / 6900678656

STOPPED AT  : 6144 MiB
REASON      : OutOfMemoryError: CUDA out of memory. Tried to allocate 256.00 MiB. GPU 0 has a total capacity of 6.43 GiB of which 11.00 MiB is free. Including non-PyTorch memory, this process has 6.42 GiB memory in use.
沒有出現 NO WALL,牆確實存在,停在 6144 MiB。把那兩個數字換算一下就非常清楚了:
6900678656 bytes = 6581 MiB(剛好整除),正是我們申請的額度7157579776 bytes = 6826 MiB,是這次如果放行之後的總量HAMi-core 算出來會超額,於是直接擋下,錯誤往上冒成 PyTorch 的 OutOfMemoryError。
STOPPED AT 6144 加上 CUDA context 的 426 MiB 大約就是 6570,離 6581 只差一點點,剩下的 11 MiB 不夠再配一塊 256 MiB。額度卡得相當準。
而且要留意這個 OOM 的性質:實體卡還有 39GB 是空的。程式拿不到記憶體,不是因為卡滿了,是因為它的額度用完了。這就是硬限制的意思,也是 HAMi 跟 time-slicing 最根本的差別。time-slicing 沒有任何機制阻止一個 Pod 把整張卡的記憶體吃光,HAMi 有。
還有一點值得說:擋的方式是正常的 OOM,不是 crash、不是被 kill。應用可以接得住、可以重試、可以縮 batch size——跟真的記憶體不足長得一模一樣,因為對那個行程來說它就是真的不足。
寫到這裡會有一個很自然的疑問:既然 DRA 已經能表達「我要 4GB 加三成算力」,而且排程器還會幫你記帳——那還需要 HAMi 做什麼?
根據 HAMi 官方文件:Does Kubernetes DRA Replace HAMi?。它的答案是分工,而且分得很乾脆:
DRA 吸收了 GPU 共享中請求與調度的那一半,HAMi 保留了運行時強制執行的那一半。
關鍵在這句:
DRA(連可消費容量在內)是一個承諾追蹤器。它對一個在運行時撕毀承諾的容器毫無辦法。
而它舉的例子,正好就是我們實驗二做的事:
一個貪心的
cudaMalloc()循環會高高興興地把鄰居正指望的那塊記憶體吃掉。
memwall 那支程式就是那個貪心的迴圈。 它每次要 256 MiB,一路要到底。排程器那邊只記得「這份 claim 答應只用 6581Mi」,但排程器不在容器裡,攔不住它——真正把它擋在 6144 MiB 的,是 libvgpu.so。
如果只有 DRA 沒有 HAMi-core,那個迴圈會一路吃到 46068 MiB,然後鄰居跟著倒。記帳跟強制是兩件事,這一節從頭到尾在講的就是這句話。
HAMi 做到的是:不挑卡、粒度自己開,而且限制是真的擋得住的。claim 寫 6581Mi,容器裡 nvidia-smi 就只看得到 6581 MiB,程式硬要超過就是 OOM。
到今天為止都在講「一張卡怎麼分」。明天換一個問題:卡就這麼多,一堆人同時要,誰先進來? 主角是 Kueue。
Project-HAMi/HAMi
Project-HAMi/k8s-dra-driver
Project-HAMi/HAMi-core
HAMi 文件 — GPU Virtualization Principles
HAMi 文件 — Dynamic Resource Allocation
HAMi Blog — Does Kubernetes DRA Replace HAMi?
KEP-5075: DRA Consumable Capacity


 iThome鐵人賽
 看影片追技術