

昨天介紹的 Kueue 決定「這個 Job 現在該不該開始」:Job 建立時被設為暫停,取得額度並被准入後才解除暫停。但 Kueue 不負責 Pod 放到哪個節點,這件事仍然交給 kube-scheduler。
而 kube-scheduler 一次只看一個 Pod。它不知道哪幾個 Pod 是一組的。
對分散式訓練來說,這就是問題的開始:一組 worker 只要少一個,其他的就只能一直等下去。今天要看的,就是那些等不到的 Pod,以及 Volcano 怎麼讓它們不必等。
kube-scheduler 每次排程的對象是一個 Pod。每一次排程嘗試分成排程週期與綁定週期兩個階段,而排程週期是依序執行的。它不知道哪幾個 Pod 屬於同一個工作,也不知道少了其中一個,其他的就沒有意義。
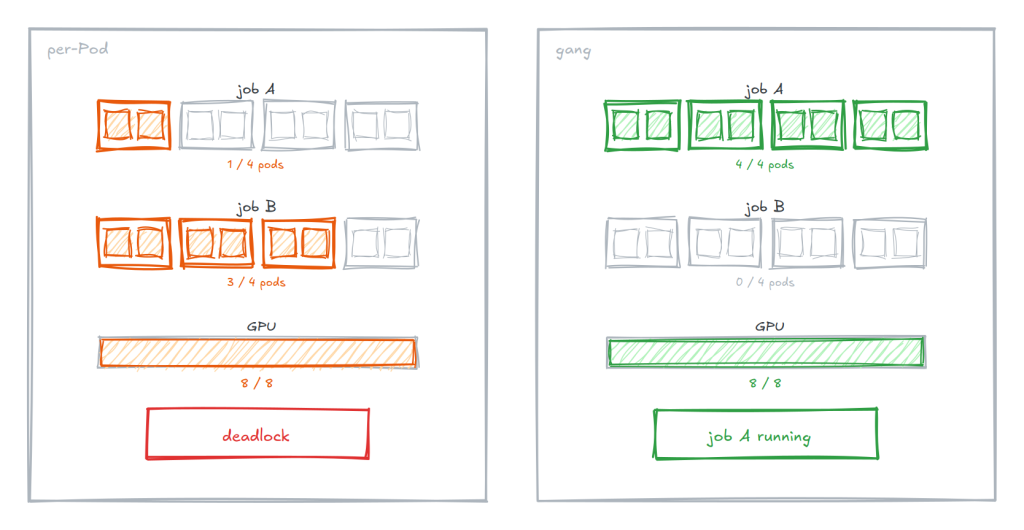
假設叢集有 8 張卡,兩個訓練工作同時送出,每個都需要 8 張。kube-scheduler 一個一個排的結果,可能會是這樣:
訓練 A 的 worker-0   → 拿到卡
訓練 B 的 worker-0   → 拿到卡
訓練 A 的 worker-1   → 拿到卡
訓練 B 的 worker-1   → 拿到卡
...
卡用完了
兩邊都只拿到一部分,而分散式訓練的 worker 需要彼此配合。以 PyTorch 為例,torch.distributed.init_process_group 會阻塞到所有行程都加入為止。所以已經拿到卡的 worker 會停在原地等待同伴,也不會釋放手上的卡。
結果是卡被佔滿,卻沒有任何工作在前進。Volcano 的文件也指出,同一組容器之間高度相關,可能發生資源競爭,而整體排程配置可以有效解決這類死結。
Volcano 是 Kubernetes 原生的批次排程系統,用來擴充與強化標準 kube-scheduler 的能力。它的排程器建立在 kube-batch 的基礎上,目前是 CNCF 的 incubating 專案,支援 Spark、TensorFlow、PyTorch、Flink、Ray 等計算框架。
Volcano 並不修改 kube-scheduler,而是另外部署一個排程器。Kubernetes 以 Pod 的 spec.schedulerName 判斷由哪個排程器負責;Volcano 自己的 Job 型別(VolcanoJob)的 schedulerName 可以是 volcano 或 default-scheduler,預設就是 volcano。
Volcano 提供的排程策略很多,包括 DRF 公平排程、以佇列為基礎的配額與搶占、網路拓撲感知、binpack 等。本篇只看其中最核心的一個:gang scheduling。
Gang scheduling 是批次排程領域的一個概念,字面上的 gang 指的是「一夥人」:把一組必須同時執行的工作視為一個單位,一起排程、一起執行,而不是各自獨立地被安排。
這個概念要解決的,就是開頭那個問題。一個分散式訓練由多個 worker 組成,它們之間互相依賴,少一個就沒有意義。如果排程器一個一個排,就可能出現「每個工作都拿到一部分資源、卻都湊不齊」的情況。Gang scheduling 的做法是把判斷單位從單一 Pod 換成整組 Pod:湊得齊就全部放行,湊不齊就一個都不放。
Volcano 把這個策略實作成排程器的核心演算法之一,目標是滿足排程過程中「全有或全無」的需求,避免 Pod 被任意排程而浪費叢集資源。
它的判斷方式是:觀察一個 Job 底下已排程的 Pod 數量,是否達到最低執行數量。達到了,就對 Job 底下所有 Pod 執行排程;達不到,就不執行。
在資源不足時,這個策略可以避免「部分工作被分配到資源、卻在等待其他任務而浪費資源」的情況。
Volcano 用一個 CRD 來表達「這幾個 Pod 是一組的」,叫做 PodGroup:一組有強烈關聯的 Pod,主要用於批次排程,例如 TensorFlow 的 ps 與 worker。
建立 VolcanoJob 時若沒有指定 PodGroup,Volcano 會自動建立一個對應的 PodGroup。這和 Kueue 為 Job 自動建立 Workload 的做法相似:使用者送出工作,系統產生一個用來排隊的物件。
PodGroup 有五個狀態:
| 狀態 | 意義 |
|---|---|
| Pending | 已被 Volcano 接受,但資源需求尚未滿足 |
| Inqueue | 已通過驗證,等待綁定到節點。這是 Pending 與 Running 之間的過渡狀態,controller 在這個狀態才開始建立 Pod |
| Running | 至少有 minMember 個 Pod 在執行 |
| Unknown | minMember 個 Pod 中,部分在執行、部分無法排程 |
| Completed | PodGroup 的所有 Pod 都已完成 |
第一關:enqueue。 排程器的 enqueue 動作會判斷叢集的閒置資源能否滿足工作的最低需求。滿足了,PodGroup 從 Pending 變成 Inqueue;不滿足,就維持 Pending。只有 PodGroup 進入 Inqueue 之後,controller 才會為它建立 Pod。
第二關:allocate。 allocate 動作負責為 Pod 挑選節點,而且採用 commit 機制:一個 Pod 的排程需求被滿足時,不一定會立刻綁定,還要看它所屬 Job 的 gang 條件是否滿足。只有 gang 條件滿足,Pod 才會被綁定到節點。
所以在 Volcano 裡,「在等」可能有兩種樣子:PodGroup 停在 Pending 時,Pod 還不存在;PodGroup 已進入 Inqueue 但 gang 條件不滿足時,Pod 存在,但沒有被綁定到節點。
| Kueue | Volcano | |
|---|---|---|
| 部署內容 | controller manager + webhook | 排程器 + controller manager + admission |
| 等待時的樣子 | Job 被暫停,Pod 不存在 | PodGroup 為 Pending 時 Pod 不存在;已 Inqueue 但 gang 未滿足時,Pod 存在但未綁定 |
| 排隊的物件 | Workload | PodGroup |
| 本篇關注的能力 | 額度 | 一組 Pod 的原子性 |
Volcano 本身也有佇列與配額管理,但本篇只看 gang scheduling。
沿用昨天 fake-gpu-operator 的叢集,一台 worker 上有 8 張假卡:
kubectl get nodes -o custom-columns=NODE:.metadata.name,GPU:.status.allocatable.'nvidia\.com/gpu'
NODE                    GPU
gpu-lab-control-plane
gpu-lab-worker          8
gpu-lab-worker2
以官方提供的 development manifest 安裝 Volcano(本篇指定 v1.15.2):
kubectl apply -f https://raw.githubusercontent.com/volcano-sh/volcano/v1.15.2/installer/volcano-development.yaml
kubectl -n volcano-system rollout status deploy/volcano-scheduler
kubectl -n volcano-system get pods
NAME                                  READY   STATUS      RESTARTS   AGE
volcano-admission-7b4c5dc49c-5mq9v    1/1     Running     0          18s
volcano-admission-init-z4gd9          0/1     Completed   0          18s
volcano-controllers-cc5cbbd9f-hzfbm   1/1     Running     0          18s
volcano-scheduler-548886dbfd-bqqxw    1/1     Running     0          18s
這三個元件對應 Volcano 架構中的三個部分:
相較於 Kueue 只有一個 controller manager,Volcano 多了一個 volcano-scheduler,也就是前面提到的「另外部署的排程器」。它和 kube-scheduler 同時存在,各自處理 schedulerName 指定給自己的 Pod。
apiVersion: batch.volcano.sh/v1alpha1
kind: Job
metadata:
  name: gang-a
spec:
  minAvailable: 4                 # 至少 4 個 Pod 能被排程才放行
  schedulerName: volcano          # 交給 Volcano 排程
  queue: default
  tasks:
    - replicas: 4
      name: worker
      template:
        spec:
          restartPolicy: Never
          containers:
            - name: w
              image: busybox:1.36
              command: ["sh", "-c", "sleep 120"]
              resources:
                limits: { nvidia.com/gpu: 2 }
(gang-b 內容相同,只有名稱不同。)
4 個 worker,每個需要 2 張卡,一個工作需要 8 張。叢集剛好 8 張,兩個工作同一時間只可能有一個執行。
這份 YAML 的 apiVersion 是 batch.volcano.sh/v1alpha1,是 Volcano 自己的 Job 型別,不是 batch/v1。minAvailable 和 tasks 都是它的欄位。
送出之前,先在一個終端持續觀察 PodGroup:
kubectl get podgroups.scheduling.volcano.sh -w \
  -o custom-columns=NAME:.metadata.name,MIN:.spec.minMember,RUNNING:.status.running,PHASE:.status.phase
再從另一個終端執行 kubectl apply -f gang.yaml。
輸出如下:
NAME      MIN   RUNNING   PHASE
gang-a-…  4
gang-b-…  4
gang-b-…  4               Inqueue
gang-a-…  4               Inqueue
gang-a-…  4               Running
gang-a-…  4     1         Running     ← gang-a 開始執行
gang-a-…  4     2         Running
gang-a-…  4     3         Running
gang-a-…  4     4         Running     ← 全部到齊
gang-a-…  4     3         Running     ← 開始有 Pod 執行完畢
gang-b-…  4               Inqueue
gang-a-…  4     2         Running
gang-a-…  4     1         Running     ← 只剩一個在執行,6 張卡閒置
gang-b-…  4               Inqueue     ← 仍然沒有進場
gang-b-…  4     4         Running     ← 卡全部釋放後才一次進場
PodGroup 名稱帶有後綴,MIN 欄位的 4 則來自 Job 的 minAvailable。
兩件事值得注意。
一、兩個 PodGroup 一開始就都進入了 Inqueue。 依照前面 PodGroup 一節的說明,這代表兩者都通過了 enqueue,controller 因此為兩者都建立了 Pod。enqueue 的判斷會受排程器設定影響,例如 overcommit-factor 預設為 1.2,本篇沒有深入探討。
二、gang-a 只剩一個 Pod 在執行時,有 6 張卡閒置,gang-b 仍然沒有進場。 這對應前面提到的第二關(allocate):gang-b 需要 8 張卡,6 張不夠,gang 條件不滿足,allocate 就不會綁定它的任何一個 Pod。它不會先放兩個 Pod 進去佔位。
昨天的 Kueue 也出現過「卡空著卻不能跑」,原因是額度;今天的原因是整組放不下。
工作結束後,Pod 的時間紀錄仍然保留:
POD               CREATED               STARTED               FINISHED
gang-a-worker-0   2026-09-18T14:14:50Z  2026-09-18T14:14:56Z  2026-09-18T14:16:56Z
gang-a-worker-1   2026-09-18T14:14:50Z  2026-09-18T14:14:57Z  2026-09-18T14:16:57Z
gang-a-worker-2   2026-09-18T14:14:50Z  2026-09-18T14:14:55Z  2026-09-18T14:16:55Z
gang-a-worker-3   2026-09-18T14:14:50Z  2026-09-18T14:14:54Z  2026-09-18T14:16:54Z
gang-b-worker-0   2026-09-18T14:14:50Z  2026-09-18T14:17:00Z  2026-09-18T14:19:00Z
gang-b-worker-1   2026-09-18T14:14:50Z  2026-09-18T14:17:00Z  2026-09-18T14:19:00Z
gang-b-worker-2   2026-09-18T14:14:50Z  2026-09-18T14:17:00Z  2026-09-18T14:19:00Z
gang-b-worker-3   2026-09-18T14:14:50Z  2026-09-18T14:17:00Z  2026-09-18T14:19:00Z
八個 Pod 在同一秒被建立(14:14:50),這和上一節兩個 PodGroup 一開始就進入 Inqueue 的觀察一致。
gang-b 的四個 Pod 在同一秒啟動(14:17:00),時間點在 gang-a 最後一個 Pod 結束(14:16:57)之後。在那之前,gang-b 的 Pod 已經存在了兩分多鐘,卻沒有任何一個先啟動。
gang-a 的四個 Pod 啟動時間相差三秒。要注意 STARTED 是容器的啟動時間,除了排程之外還包含拉取映像檔等步驟,所以這三秒的差距不能直接解讀為排程順序。如果要比較排程發生的時間,應該看 Pod 的 PodScheduled condition。
上面說明了 Volcano 的行為,接著確認不使用它時會發生什麼。
同樣的兩個工作,改用 batch/v1 的 Job,並拿掉 schedulerName 與 minAvailable,其餘條件相同:一樣兩個工作、每個需要 8 張卡。
kubectl apply -f plain.yaml
watch -n2 "kubectl get pods -o wide | grep plain"
plain-a-29glv   0/1   Pending   104s
plain-a-6vjnj   1/1   Running   104s   gpu-lab-worker
plain-a-jwkrr   0/1   Pending   104s
plain-a-qpl49   0/1   Pending   104s
plain-b-j7gt5   1/1   Running   104s   gpu-lab-worker
plain-b-kb945   1/1   Running   104s   gpu-lab-worker
plain-b-llj75   0/1   Pending   104s
plain-b-xlrsx   1/1   Running   104s   gpu-lab-worker
| Running | 尚缺 | |
|---|---|---|
plain-a |
1 / 4 | 3 個 |
plain-b |
3 / 4 | 1 個 |
兩個工作都沒有到齊,而 4 個 Running 的 Pod 各使用 2 張卡,8 張卡全部被佔滿。這就是開頭描述的情況。
POD             CREATED    STARTED    FINISHED
plain-a-6vjnj   14:45:56   14:45:56   14:47:56
plain-b-j7gt5   14:45:56   14:45:56   14:47:56
plain-b-kb945   14:45:56   14:45:56   14:47:56
plain-b-xlrsx   14:45:56   14:45:56   14:47:56

plain-a-29glv   14:45:56   14:47:58   14:49:58
plain-a-jwkrr   14:45:56   14:47:58   14:49:58
plain-a-qpl49   14:45:56   14:47:58   14:49:58
plain-b-llj75   14:45:56   14:47:58   14:49:58
第一批在 14:47:56 結束,第二批在 14:47:58 啟動,總共約四分鐘,和使用 Volcano 時差不多。
差別在於這四分鐘裡的狀態:
| 前兩分鐘 | 後兩分鐘 | |
|---|---|---|
| Volcano | gang-a 4/4 |
gang-b 4/4 |
| 不使用 gang | a 1 個 + b 3 個,兩個都不完整 |
a 3 個 + b 1 個,兩個都不完整 |
使用 Volcano 時,任何時刻都有一個完整的工作在執行;不使用時,8 張卡全程滿載,但沒有任何一個工作是完整的。
因為 busybox sleep 120 不需要等其他 Pod。每個 Pod 睡完就結束,卡被釋放,下一批才能接上。
真實的分散式訓練不是這樣。如開頭所述,PyTorch 的 init_process_group 會阻塞到所有行程都加入為止。換成真正的訓練,plain-b 的三個 worker 會等待第四個,而第四個拿不到卡,因為卡被 plain-a 的那一個 Pod 佔著,而那一個也在等它的三個同伴。雙方都在等對方釋放的資源,這種情況會一直持續,直到初始化逾時失敗為止。
所以這個對照組呈現的只是較溫和的版本。
kube-scheduler 分配的結果不保證每次相同。這次跑出 1/3 的分配,重跑一次可能是 2/2 或 3/1,也可能剛好是 4/0,那樣其中一個工作就能完整執行。
也就是說,沒有 gang scheduling 時,工作能不能完整執行取決於當下的排程結果,而不是由機制保證。
今天介紹了 Volcano 的 gang scheduling。它以 PodGroup 表示一組相關的 Pod,並在兩個地方把關:enqueue 判斷資源是否足以讓 PodGroup 進入 Inqueue,只有進入 Inqueue 才會建立 Pod;allocate 則要等 gang 條件滿足,才把整組 Pod 綁定到節點。實驗中,gang-b 的 Pod 雖然早就存在,卻一直等到 8 張卡全部釋放才同時啟動;而不使用 Volcano 的對照組,8 張卡全程滿載,卻沒有一個工作是完整的。
Kueue 和 Volcano 都讓工作排隊,但判斷依據不同:Kueue 看額度夠不夠,Volcano 看整組放不放得下。接下來會介紹同樣處理這一層、但以 GPU 使用率與公平共享為重點的 KAI Scheduler。
Volcano — GitHub README
Volcano — Introduction
Volcano — Architecture
Volcano — Scheduler Introduction
Volcano — Actions
Volcano — Gang plugin
Volcano — PodGroup
Volcano — VolcanoJob
Volcano — How to configure scheduler
volcano-sh/apis — PodGroup phase 定義
Kubernetes — Scheduling Framework
Kubernetes — Configure Multiple Schedulers


 iThome鐵人賽
 看影片追技術