

今天來點輕鬆的,沒有跑實驗純介紹,理由很簡單,因為有些東西我們跑不起。
Day 5 我們讓 DRA 把一張卡切成好幾塊,還讓兩個 Pod 分著用同一塊。但整個過程裡,排程器只是在一本帳上做加減法,它從來沒有碰過硬體。
那硬體那邊到底發生了什麼事?兩個容器真的拿到「同一張卡」的時候,它們是怎麼相處的?
今天不碰 Kubernetes,只看卡本身。
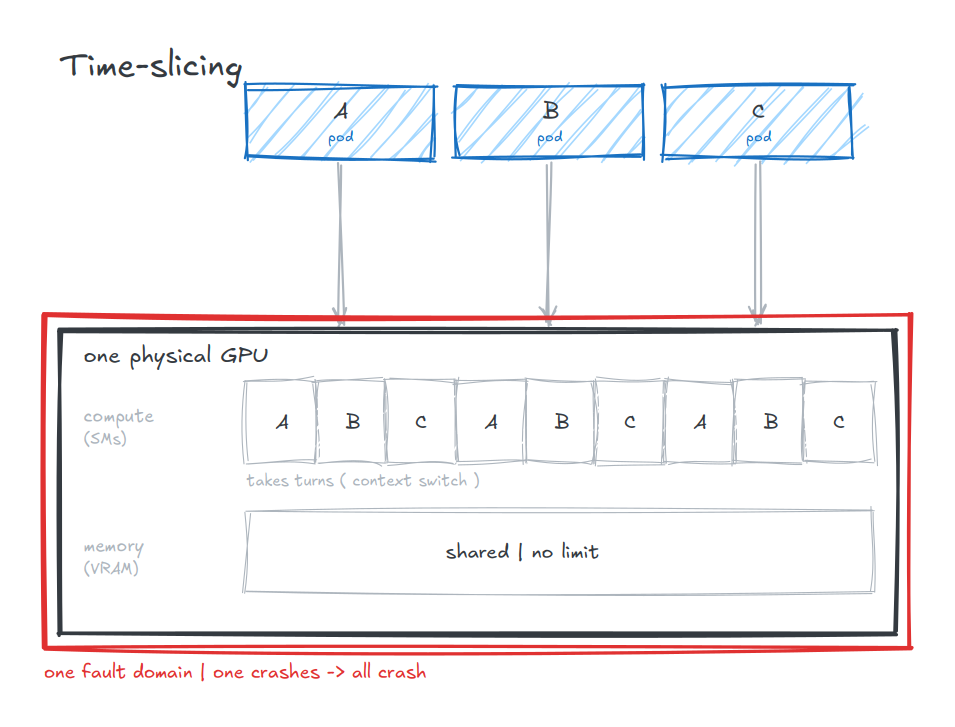
什麼都不裝,兩個 process 同時用一張卡,會發生什麼事?GPU 上有一個時間分片排程器,負責調度來自不同 CUDA context 的工作佇列,而來自不同 CUDA context 的工作,沒辦法同時執行。
兩句合起來就是:不同 process 的 kernel 不會同時跑,GPU 在它們之間輪流。
記憶體那邊則是沒有人在管。共用同一張卡的工作負載,每一個都能直接存取 GPU 記憶體,沒有記憶體隔離,也沒有故障隔離。誰先要誰先拿,沒有上限。
所以預設狀態下有兩個洞:算力是輪流的、記憶體是沒有上限的。後面每一個機制,都是在補其中一個,或兩個一起補。
最簡單的做法:不改硬體,只改數字。
NVIDIA 的 device plugin 可以設定每張卡宣告成 N 個。它的做法直白到有點好笑,以 replicas: 10 為例:替每張 GPU 建立十個 reference,然後誰來要就給誰。
十個「複製品」指向同一張實體卡。底下還是原本那個 context switch。而且那個 context switch 不是它做的,是 GPU 本來就在做的。
這裡有個很容易混淆的地方:「time-slicing」這個詞其實指兩件事。
| 指的是 | 誰在做 |
|---|---|
| GPU 的時間分片排程 | 硬體/驅動,裝了驅動就在跑,關不掉 |
| Kubernetes 的 time-slicing | device plugin 把一張卡宣告成 N 個 |
第二個完全建立在第一個上面。 它在卡上沒有動任何東西,它動的是 device plugin 那個「全拿或全不拿」的整數:從 1 改成 N,讓 N 個 Pod 排得進來。輪流是 GPU 的功勞,它只負責讓大家進得了門。
換句話說,它發出去的是 N 份使用權,不是 N 份效能。輪到你的時候拿到的是整張卡,N 只是超賣的倍數。
所以它什麼都沒有解決,只是讓更多人進得來:
記憶體沒有配額。 別人讀不到你的資料,但誰先要誰先拿。一個 Pod 可以把整張卡的記憶體吃光,其他人直接 OOM。
大家在同一條船上。 一般的程式崩潰不會影響鄰居,但遇到嚴重到需要重置整張卡的錯誤,上面的人一起死。
還有一個很容易誤會的地方:要兩份不會拿到兩倍算力。而且真正的原因比這句話更麻煩:GPU 是把時間平均分給「所有跑在上面的程式」,不是分給 Pod。
一個 Pod 裡可以開很多程式,而且沒有上限。這代表:
Kubernetes 那邊數的是 Pod,GPU 這邊數的是程式,兩邊的單位從頭到尾就對不起來。你設的那個 N,對底下實際發生的事沒有任何約束力。
最後一件事:輪流本身是有成本的。 每次切換都要保存和復原一堆狀態,擠的人越多,切換越頻繁,整體跑完的速度反而會變慢。
這就是 time-slicing 的定位:明知道沒有隔離,但對某些工作負載來說,這總比完全不能共用好。適合開發環境、Jupyter、平常沒在滿載的小型推論服務——重點是平常沒在滿載,因為你完全沒辦法保證任何一次請求要等多久。
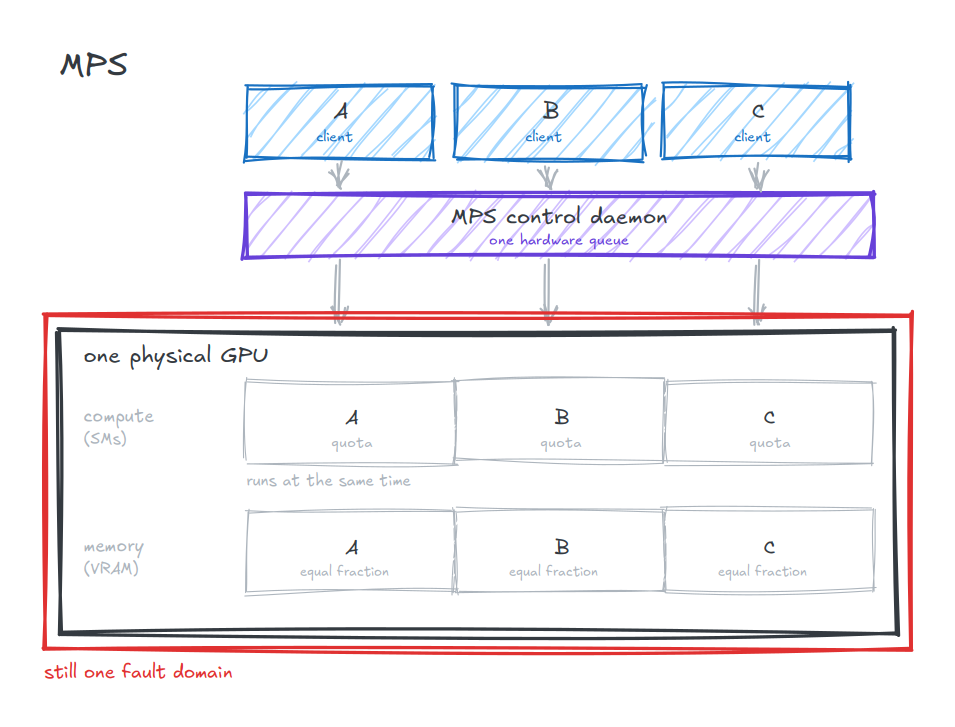
Time-slicing 是輪流,MPS(Multi-Process Service)是平行。
它在 GPU 前面放一個 control daemon 協調共用資源,讓多個 client 的 kernel 可以真的同時執行,省掉輪流的來回,換來更高的 GPU 使用率。
不過它不是任何情況都有用:MPS 適用的是單一 process 產生的工作量不足以餵飽 GPU的情況。
換句話說,MPS 解的是「一個人吃不完」,不是「想讓更多人擠進來」。如果你的程式本來就把卡榨乾了,MPS 不會變出算力,只會讓大家一起變慢。
NVIDIA Volta 問世後,MPS 可以限制每個 client 能用多少記憶體、能吃掉多少比例的算力。跟 time-slicing 比,這是多出來的東西。
但這裡有兩個很容易誤會的地方。
第一,這兩個限制預設是不設的。 不設的話,每個 client 一樣是看得到全部、要得到全部,跟 time-slicing 沒兩樣。它給你的是可以管,不是已經管好了。
第二,設了也只是上限,不是保證。 限制一個 client 最多用 30% 的算力,不代表它一定拿得到 30%。文件講得很直白:設上限不會替任何 client 保留專用資源,只是限制它最多能用多少,不同 client 的 kernel 仍然可能被排到同一個 SM 上。所以那是百分比,不是把晶片切開。
而它沒給的是故障隔離。 一個 client 出了致命錯誤,同一組 GPU 上的其他 client 全部會收到通知,而且必須自己退出——出事還是一起出事。(新一點的卡在這件事上有改善,但改善的是事後能恢復,不是不被波及。)
再往下還有一條,我覺得是 MPS 在多租戶情境下最致命的:一台機器上同時只能有一個使用者擁有運作中的 MPS server,而且 server 只服務跟它同一個 UID 的 client。UID 不對,client 根本起不來。但有個模式可以放寬這個限制,讓不同使用者連到同一個 server。但打開它的條件是:你要先確定不同使用者之間不需要隔離。
換句話說,MPS 從設計上就不是拿來隔開「不同的人」的。根據官方文件的建議:MPS 適合實質上等同單一應用程式的協作行程,例如同一個 job 的多個 rank。
所以 MPS 的定位是:讓同一個人的多個程式把卡餵滿。後面 vGPU 和 MIG 才開始處理「不同租戶」這件事。
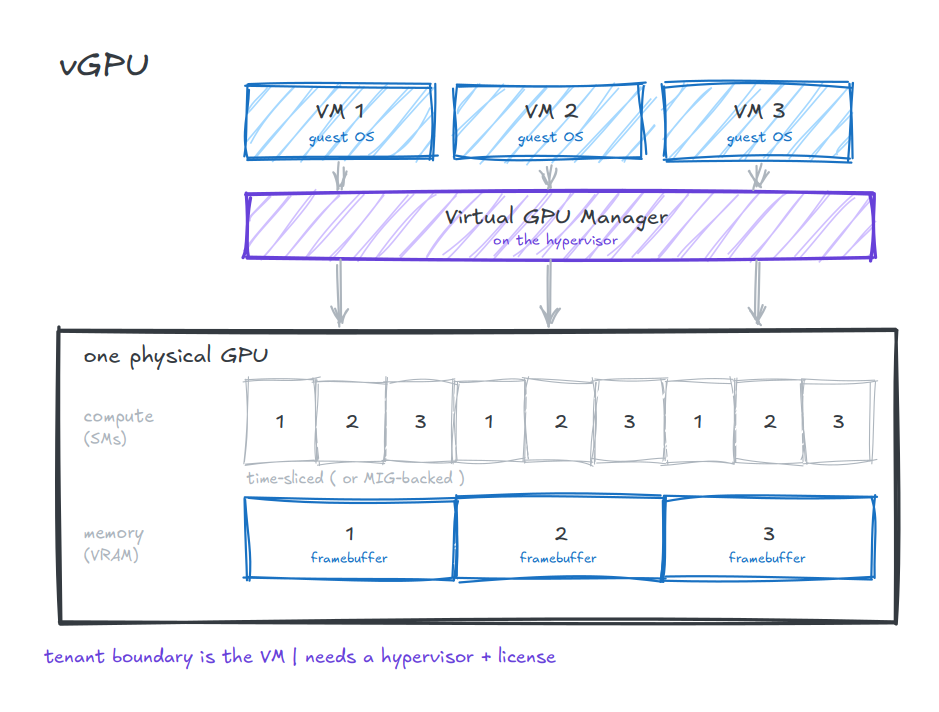
前兩個都是「同一台機器上的多個 process」。vGPU 換了一個層次:多個虛擬機共用一張卡。
NVIDIA vGPU for Compute 讓多個 VM 共用一張實體 GPU,而每個 VM 看到的,都像是一張專屬於自己的 GPU 裝置。
做這件事的是跑在 hypervisor 上的 Virtual GPU Manager,它把一張實體卡拆成多個 vGPU 掛給不同的 guest VM。每個 vGPU 在它存在的期間,都保留自己那一份 framebuffer 記憶體。
但這裡有個關鍵:vGPU 是「怎麼交付」,不是「怎麼切」。 它底下有三種模式:
| 模式 | 底下是什麼 |
|---|---|
| time-sliced vGPU | 還是輪流,只是輪流的單位變成 VM |
| MIG-backed vGPU | 每個 vGPU 跑在一個獨立的 MIG instance 上 |
| time-sliced MIG-backed | 兩者混合 |
所以「vGPU 的隔離強不強」這個問題沒有單一答案,要看它是哪一種。MIG-backed 那種把 MIG 的硬體切分和 vGPU 虛擬化結合起來,每個 vGPU 不是共用一整張實體卡,而是跑在一個專屬的 GPU instance 上;時間切分的那種,算力還是共享的。
GPU 真正獨有的價值是租戶邊界,而且這個邊界比前面幾個都硬:其他機制切的是一張卡,租戶還是共用同一個作業系統;vGPU 切在 hypervisor 那一層,VM 跟 VM 之間就是兩台機器。代價是它需要 hypervisor,而且是要授權的商業軟體,所以我們這種普通小老百姓就別想這個方法了吧。
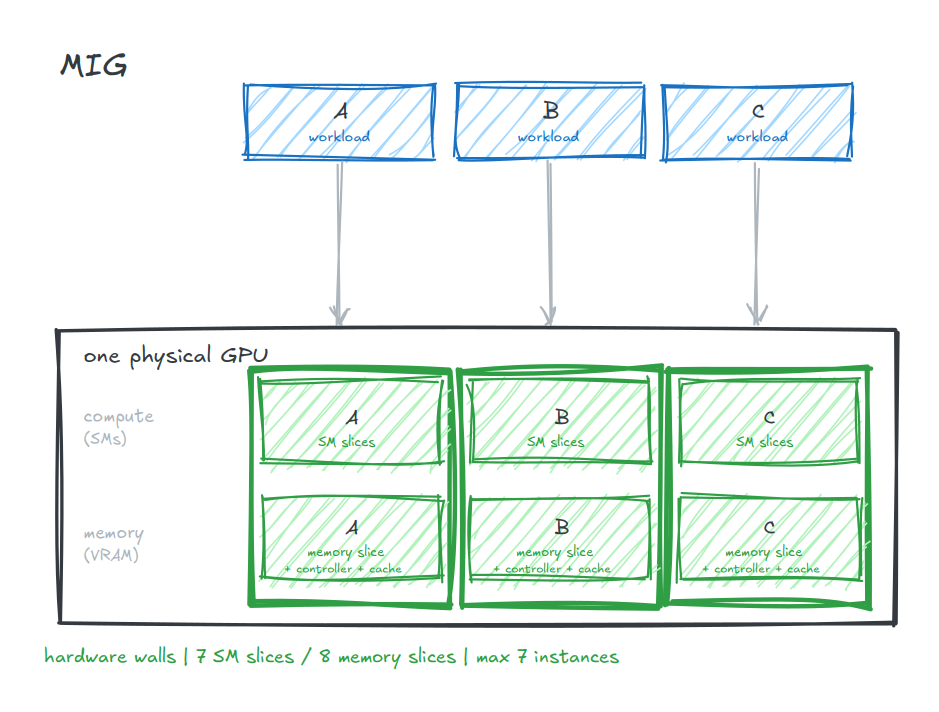
前三個都是軟體在協調,MIG 是把晶片實體切開。切出來的每個 instance 看起來都像一張迷你 GPU,在硬體層就有記憶體隔離和故障隔離,而切法是預先定義好的,不能任意比例。
切的單位是 slice,算力和記憶體分開算:
| 定義 | |
|---|---|
| SM slice | GPU 上 SM 的最小切分單位,大約是全部 SM 的七分之一 |
| Memory slice | GPU 記憶體的最小切分單位,含對應的 memory controller 和 cache,大約是全部記憶體資源的八分之一 |
以 A100-40GB 為例:8 個 memory slice、7 個 SM slice。
兩個數字不一樣,看起來很怪,但實際切分是照 memory slice 走的:記憶體八等分,SM 七等分,一個 GPU slice 就是一份記憶體配一份 SM。至於為什麼 SM 是七等分,那是硬體決定的,記起來就好。
而這就是 MIG 跟前面三個最不一樣的地方:memory slice 切走的不只是容量,memory controller 和 cache 也一起切,所以鄰居吃不到你的頻寬,也污染不了你的 cache。
profile 名字的規則:1g.5gb 前面是幾個 SM slice,後面是配到的記憶體。A100-40GB 上 7g.40gb 就是整張卡當成一個 instance(仍然是 MIG instance,不等於沒開 MIG)。
profile 在卡上有固定位置,所以會有碎片問題:總量還夠、位置排不下去,就是建不出來。DRA 那套 counter 加減法只算量,不算位置。
剩下的代價:只有部分型號支援,改切法要重設。
四個機制,其實是同一個問題的四種答案:你願意用多少彈性,換多少保證。
| 代價 | |
|---|---|
| Time-slicing | 幾乎沒有,改個 config 就好;但你的份額由全場的 process 數決定 |
| MPS | 要多跑一個 control daemon;同機只能有一個使用者的 server;device plugin 的 MPS 模式不支援已啟用 MIG 的裝置 |
| vGPU | 要 hypervisor + 商業授權 |
| MIG | 限型號、限 profile、改切法要重設,還可能卡在碎片 |
Time-slicing 你可以開 100 份;MIG 最多 7 份,而且只能挑表上排好的那幾種切法。這不是誰比較好的問題。
如果真的要挑一件最容易被漏掉的事,是記憶體頻寬。MIG 的 memory slice 切走的不只是容量,memory controller 和 cache 都一起切,所以鄰居把自己的 cache 打爛、把 DRAM 榨滿,都影響不到你。MPS 就沒有這件事,它的限制管得到記憶體容量,管不到頻寬,硬體資源還是大家共用的。
這幾個機制裡,沒有一個是 Kubernetes 做的。它們全部是廠商在卡上或驅動層做的事。
那 Kubernetes 的角色是什麼?表達。
TimeSlicing / MPS 這類 opaque config,就是 DRA 把「我要用哪種共享策略」這件事傳給 drivermig.nvidia.com),不是同一個 class 加參數最能說明這件事的例子:在 MIG 裝置上設 TimeSlicing,是沒有作用的。 API 收下了這個欄位,底下的硬體什麼都不會發生——要在容器之間共用一個 MIG slice,得改用 MPS。
換句話說:硬體決定能不能切,Kubernetes 決定怎麼講這件事。 兩邊是分開的。
今天整篇沒有指令輸出,因為這幾件事都不發生在 Kubernetes 這一層,它們發生在真正的矽晶片上。
但我覺得把這一層搞清楚是值得的,因為 DRA 那些 counter 加減法,看久了很容易產生一種錯覺:以為 Kubernetes 在切卡。 它沒有。它只是在記帳。
明天要看的 HAMi 走的是第五條路:不改硬體,也不依賴廠商的驅動功能,而是在應用程式和 CUDA 驅動之間插一層攔截。這一層讓它可以直接對每個容器下「你最多用 4GB、最多用 30% 算力」這種指令,數字自己填,不用等分,也不用挑卡。
NVIDIA Developer Blog:Improving GPU Utilization in Kubernetes(Table 1 機制比較)
NVIDIA GPU Operator:Time-Slicing GPUs in Kubernetes
NVIDIA/k8s-device-plugin:README(time-slicing 與 MPS 章節)
NVIDIA Multi-Process Service:Architecture(預設的時間分片排程、錯誤處理)
NVIDIA Multi-Process Service:When to Use MPS(適用情境與限制)
NVIDIA Multi-Instance GPU User Guide:Concepts
NVIDIA AI Enterprise:vGPU for Compute Overview
NVIDIA AI Enterprise:MIG-Backed vGPU


 iThome鐵人賽
 看影片追技術