
「兩瓶藥在手不是全能,是不可逆的枷鎖;容量給你,是要你預留,不是要你揮霍。」
——《阿帕契開源審計錄》¹ 卷二·序列擴容篇
幕間
狼窩第一夜,三號踱步發狠:「真預言家憑什麼拿警徽?我起跳時機明明沒錯!」
二號慢條斯理地重複:「你起跳時機沒錯……但他先開口。」
敘事者在旁聽著,第一次隱約感到二號說話的節奏有些詭異。
天快亮了,燭火將盡。女巫坐在長桌的陰影裡,指尖來回摩挲兩隻冰涼的琉璃瓶——一瓶溫潤綠光的解藥,一瓶幽黑沉芒的毒藥。
九人局有一條鐵律:女巫同一夜絕對不能同時用解藥與毒藥。她可以救、可以毒、可以兩瓶都扣著,但不能一次出兩瓶。今晚她選擇按兵不動,兩個容量都預留著,不動用。
而在白天那一側,我注意到七號記的東西又變了。這一世的發言輪次每天都在加長:第一天六個人講完就結束,今天排到第九個人才輪完一圈。她在羊皮紙邊上寫:「序列愈長,愈難插話。」——絕發規則下,你只能等整條序列跑到你這一格。
一條會愈長愈長的序列,底層到底怎麼長大的?每加一個人,是原地擴充,還是整條搬家?這正是動態陣列的核心問題。
四大語言的動態陣列,底層都是同一個結構:一塊連續配置的記憶體(backing array)、一個目前元素數量 len、一個目前容量 cap。只要 len < cap,追加元素就是把值寫進下一格,O(1)。一旦 len == cap 還要再加,就必須重新配置一塊更大的記憶體、把舊資料整批複製過去、更新指標——舊的位址從此失效。差別在於「更大」是多大,以及那塊記憶體裡裝的是值還是指標。
為什麼不是每次加一格就配一格剛好的大小?因為那樣追加 N 個元素要複製 1+2+3+…+N,是 O(N²)。改成「滿了就成倍擴」之後,複製總量收斂成 O(N),平均分攤到每次 append 就是 O(1)——這叫攤還分析(amortized analysis)。代價是空間:擴容策略越激進,尖峰時浪費的記憶體越多。1.5 倍、2 倍、1.125 倍這些數字,就是各語言在「重分配次數」與「記憶體浪費」之間下的不同賭注。還有一個常被忽略的細節:成長倍率小於 2(像 Java 的 1.5、Python 的約 1.125)時,先前釋放的舊區塊有機會被之後的配置重複利用,對配置器比較友善。
Go 的 slice 就是一個含 ptr、len、cap 的小結構。append 在容量夠時原地寫入;不夠時呼叫 growslice 配置新陣列。成長策略近年調整得更平滑:小 slice 大致翻倍,大 slice 逐步收斂到約 1.25 倍,避免大塊記憶體浪費。
func recordSpeeches() {
	// Preallocate capacity when the final size is known: zero reallocations.
	order := make([]string, 0, 9)
	for seat := 1; seat <= 9; seat++ {
		order = append(order, fmt.Sprintf("seat-%d", seat))
		fmt.Printf("len=%d cap=%d\n", len(order), cap(order))
	}
	// Without the cap hint, this loop would trigger several grow-and-copy cycles.
}
Kubernetes 處理節點清單、Pod 清單時大量使用 make([]T, 0, n) 預留容量,就是為了砍掉迴圈裡反覆的重分配。Go 的 slice 還有一個容易踩的坑:多個 slice 可以共用同一塊 backing array,對其中一個 append 若還在容量內,會悄悄改到另一個看到的資料;一旦觸發擴容,兩者才分家。理解 ptr / len / cap 三件組,才能預測這種行為。
ArrayList 內部是一個 Object[] elementData 加上 size。容量不足時,新容量是 oldCapacity + (oldCapacity >> 1),也就是 1.5 倍,再用 Arrays.copyOf 複製。注意:ArrayList<Integer> 存的是指向 Integer 物件的參考,不是連續的整數值——真正的數字散在堆積各處,走訪時 CPU 得為每一格再跳一次位址。這也是為什麼效能敏感的 Java 程式碼會改用原生 int[],或引入 primitive 集合函式庫。ArrayList 的 remove 在中間刪一個元素還要把後面全部往前搬,這些都是「連續記憶體」這個選擇帶來的固定成本。
// Give the constructor a capacity hint to avoid repeated Arrays.copyOf calls.
List<String> order = new ArrayList<>(9);
for (int seat = 1; seat <= 9; seat++) {
    order.add("seat-" + seat);
}
// The backing Object[] holds references; the String objects live elsewhere on the heap.
Apache Kafka 在批次處理 record 時對集合的預設容量很講究,因為 broker 熱路徑上每一次陣列複製都是可量測的延遲。
Vec<T> 同樣是 ptr / len / cap。成長策略是攤還式(amortized)翻倍,透過配置器重新要一塊記憶體。關鍵差異:Vec<i64> 裡就是一排連續的 8 位元組整數,不是指標——對 CPU 快取極度友善。Vec::with_capacity 一次備妥容量。
fn record_speeches() {
    let mut order = Vec::with_capacity(9); // one allocation, no reallocation
    for seat in 1..=9 {
        order.push(format!("seat-{seat}"));
        println!("len={} cap={}", order.len(), order.capacity());
    }
}
Apache DataFusion 的欄式緩衝區正是靠 Vec 的連續佈局,讓向量化運算能一次掃過整條快取列(cache line)——現代 CPU 一次搬 64 位元組進快取,Vec<i64> 剛好八個元素一列,掃描時幾乎沒有浪費;換成指標陣列,每次解參考都可能是一次快取未命中。Vec 擴容後舊記憶體立即釋放,配合借用檢查器,編譯期就擋掉「還握著擴容前的引用」這種錯誤。
CPython 的 list 是一個 PyObject ** 陣列——每一格都是指標,指向堆積上的物件。成長策略很溫和:新容量約為 newsize + (newsize >> 3),大致 1.125 倍再加一點常數。因為都是指標,走訪 list 會不斷跳位址,快取局部性天生比 Rust 的 Vec<i64> 差;即使裝的是一排小整數,每個整數也是獨立的 Python 物件。需要真正連續的數值緩衝區時,Python 生態是靠 array 模組或 NumPy 的 ndarray,那才是一塊沒有中間指標的記憶體。理解這個差別,你就懂了為什麼「純 Python 迴圈處理百萬筆數字」和「NumPy 向量化」的效能會差到數十倍——不只是直譯器開銷,還有記憶體佈局。
order: list[str] = []
for seat in range(1, 10):
    order.append(f"seat-{seat}")
# Each slot is a pointer to a str object; the objects are scattered on the heap.
Apache Airflow 在記憶體裡展開一個大型 DAG 的 task 清單時,這種指標陣列的走訪成本就是排程延遲的一部分。
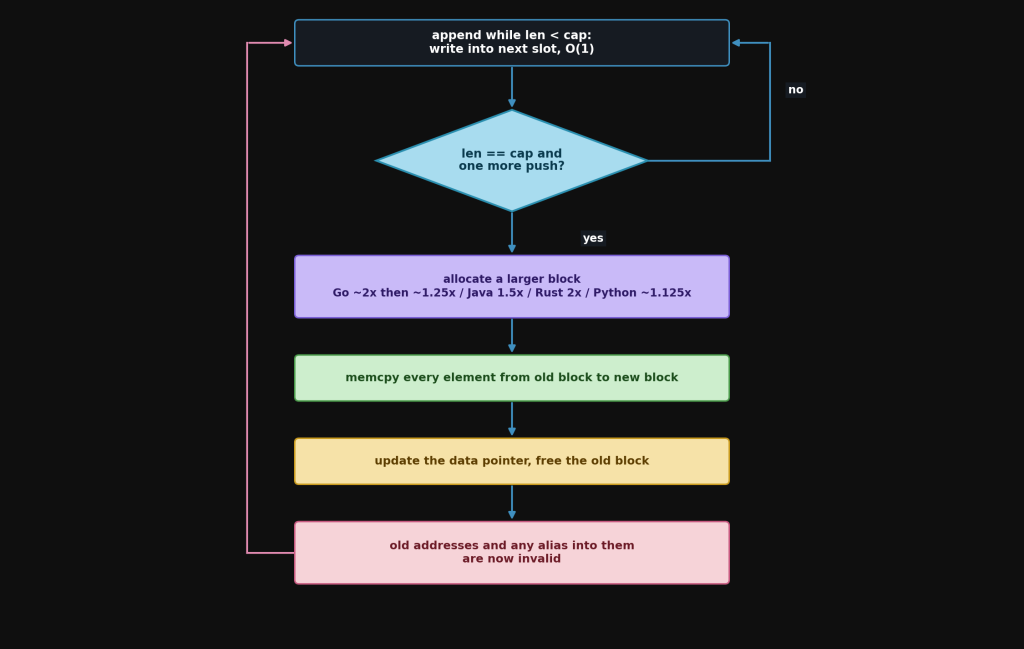
七號的觀察其實比她自己想的更準。發言序列每加一個人,如果紙上空間不夠,她就得把整卷羊皮紙的內容抄到一張更大的獸皮上——這就是一次重分配:攤還下來每一行的成本還是很低,但抄寫的當下,舊那張紙上所有位置引用全部作廢。她已經開始習慣「一次抄大一點,省得每天重抄」,等於在心裡做 with_capacity。我卻是反過來的:每重來一世,我能抄回第一夜的東西就更少一點,細節先糊掉,只剩一種說不出根據的直覺。她一條命把每一行老實鎖進羊皮紙,我幾十條命,手裡的紀錄反而越來越薄。
女巫則示範了容量的另一面:她有兩瓶藥的「容量」,但規則逼她一夜最多用一瓶。容量是預留給正確時機的餘裕,不是可以任意揮霍的額度——就像預配了 cap 不代表要立刻塞滿,也不代表可以無視規則一次全用掉。她今晚選擇不開藥,兩個容量都留著,這在牌桌上是完全合法的「持有」;等到真正的關鍵夜,她才會用掉其中一格,而且一旦用了就回不去。不可逆的寫入要挑對時機,這一點和重分配一樣:你不會希望在錯的時刻觸發那次昂貴的、無法撤銷的操作。
至於二號,今晚討論刀口時,他還是等三號、五號都講完,才補一句「我也覺得照剛才那個方向」。他從不第一個提名。
讀完這篇,你應該能估算「連續 append N 次會觸發幾次重分配」,並在已知大小時用 make([]T, 0, n) / Vec::with_capacity(n) / new ArrayList<>(n) 預留容量。想理解快取列與指標追逐的代價,ByteByteGo 與 Rust 官方 Book 的集合章節值得一讀。
runtime/slice.go(growslice 成長策略)
ArrayList
std::vec::Vec
Objects/listobject.c(list_resize 成長策略)
Go slice growth strategy growslice append capacity、Java ArrayList grow 1.5x Arrays.copyOf、Rust Vec amortized doubling RawVec with_capacity、CPython list over-allocation growth pattern cache locality
¹ 註:本書名為情境設定之虛構文獻,非真實歷史或開源紀錄。


用女巫兩瓶藥帶出 len/cap,再比較 Go、Java、Rust、Python 的成長策略,畫面感很強。我好奇這些倍率會隨版本調整,你會怎麼設計小實驗,讓讀者在自己的環境量出容量序列,而不是只記固定數字?

謝謝 @lin1015!這個提問完全切中痛點——與其死記規格書上的靜態數字,不如讓 runtime 自己「招供」。
這其實能完美套用你在 Day 7|只抽查三筆,抓得到 AI 的錯嗎? 提到的「邊界樣本」思維:不看平靜的表面,專抓數值跳變的那一瞬間!
實驗設計上,推薦讀者寫一個極簡的「探針迴圈」:
append 到 1,000 或 10,000 筆。cap 改變,就印出 (舊 cap → 新 cap, 增長倍率)。在本地環境跑完,終端機跳出來的就是該版本最真實的「擴容階梯」——不管是 Go 在臨界點後的平滑收斂,還是 Python 的溫和階梯,都能親眼驗證。
就像你 Day 7 說的:「比起看正常值,更該專看邊界」。記憶體底層有沒有背著我們重新搬家,直接抓它擴容瞬間的邊界,最不會說謊!

 iThome鐵人賽
 看影片追技術