
要怎麼設計?我問問題,AI 回答,簡單成這樣是要設計啥?
沒錯,好,本篇結束。
個頭,AI 查詢已經很強,在「怎麼查」這方面確實不需要設計,這對 AI 來說只是干擾。
但再怎麼強,都有缺點與限制,這個限制就是:理論上不是 100% 能查到
Grep 是純字面比對,不是概念比對。如果查詢用的詞彙跟檔案裡實際用的詞彙不一樣,那 Grep 就直接不命中,就我的觀察。
AI 解決這個非對稱問題的方式是,當直接搜尋查不到,依照語意多猜一些關鍵字去搜尋。
例如:幫我查查知識庫中,所有跟「熱狗」有關的研究資訊,AI 除了搜「熱狗」之外,可能還會搜「填充物|香腸|美國三明治」(舉例),再根據查到的內容去推敲,最終查到非對稱問題的答案。
但這是仰賴 AI 模型的猜語意能力與當前的上下文,因為問題太模糊導致查不到的情形還是會發生,這就是 AI 查詢的限制,具體地說,是 Claude 查詢的限制(我不知道Codex是不是類似情況)。
拿剛剛的例子來說,我搜尋時打:熱狗,其實是想找「小型犬如何利用吐舌降低體溫」,這種概念上相同,但文字不相同的狀況,AI 查不到。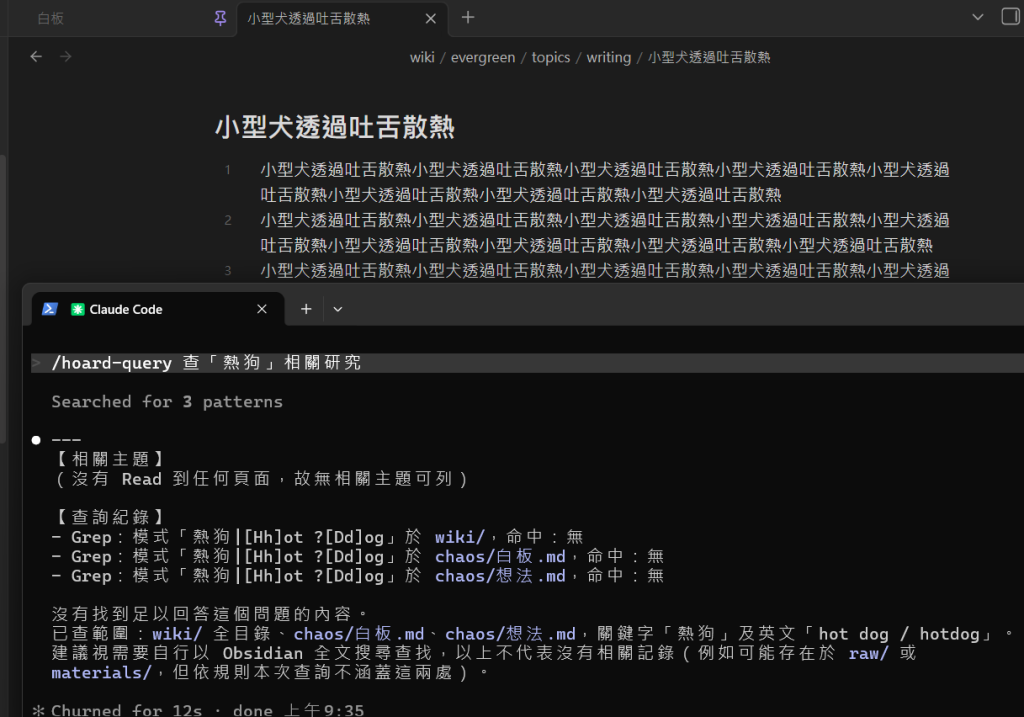
只看文字,不看概念,這是 Grep 這個查法的限制。
「更詳實的 Query 步驟」,我曾經用這個方向去設計 Query,像是什麼 1.先縮減查詢範圍、2.查不到候選頁面就 Grep。
像這樣的「規定」對 AI 來說是無效的,不論是 Claude.md 還是 Skills,AI 只看到「脈絡」而不是「規定」,也就是說 AI 沒有必要遵守更詳實的步驟,這個可以參考第七篇
我們的設計要儘量補償 Grep 只看文字不看概念的缺陷。這時候我們能做的是:提供脈絡
因為「規定」AI 不一定會照做(尤其是 Query 這個行為,AI 很容易做出,已判斷「怎麼查最有效」,於是直接忽略你的規定)
這不是壞事,只是這樣的話我們就很難得到穩定的結果,所以要。
「查不到」分兩種:
無論是哪一種,我們都想要知道:AI 在這次解答過程中查了什麼? 尤其是使用者「覺得有」卻查不到的時候。
AI 沒有義務跟你報告查詢細節,那就讓它有義務。
我們可以設計一個「查詢報告」:
上一篇的「Claude 是怎麼查資料的」有提到三種主要工具,在這裡我先說:我們用不到 Glob。
雖然 Glob 成本不高(據 AI 所說),但我們仍然不需要,因為我們的 CLAUDE.md 跟 index.md 已經把 Glob 所能做到的都做了,而且還做得更好。
我們有定義明確的資料夾結構(放在CLAUDE.md),主題和頁面也有摘要說明「主題概念」
除了「知道有什麼資料夾」之外,這兩份檔案還提供了概念上的範圍劃分,品質比單純一串檔名好得多,所以不用 Glob。
以上就是設計 Query 的全部邏輯。這套邏輯落地後長什麼樣,直接把現行的 skill 貼給你:
.claude/skills/hoard-query/SKILL.md
---
name: hoard-query
description: 搜尋wiki中的內容。
disable-model-invocation: true
allowed-tools: Read Grep
---

# DragonsHoard Query

**Q 代稱使用者提出的查詢問題。**

開始查之前,先讀取 `wiki/index.md`,比對各主題的範圍宣告與頁面摘要,判斷語意上最相關的候選頁面;

## 搜尋範圍

只查 `wiki/` 加 `chaos/白板.md`、`chaos/想法.md`,不查 `raw/`、`materials/`。

## 回答規則

- 已有足以回答 Q 的內容 → 綜合作答,並標註各論點來源;wiki 內容以頁面連結標示,僅存在於 `chaos/` 的內容標註「僅存在於 chaos,尚未整理進 wiki」。
- 沒有足以回答 Q 的內容 → 不得宣稱「沒有記錄」或內容不存在,改為回報已查範圍與使用過的關鍵字,並建議使用者視需要自行以 Obsidian 全文搜尋查找。
- 不得以與 Q 語意不相關的候選頁面作為答案來源。

## 查詢報告

不論查到或查不到,都要附上查詢報告,呈現順序固定為**相關主題 → 查詢紀錄 → 答案(或查無結果訊息)**,格式見 `report-format.md`。

- **查詢紀錄**:實際用過的 Grep 模式與範圍、原始命中檔名清單,以及實際 Read 過的頁面清單(區分「採用進答案」與「Read 後判斷不相關、未採用」)——要能對照到真的執行過的工具呼叫,不是事後描述出來的敘述。
- **相關主題**:對查詢紀錄裡列出的已讀頁面各自執行 `grep '\[\['`,把撈到的連結依 `report-format.md` 的主題判準對應到主題名稱、去重列出,不列個別頁面連結,也不追蹤展開這些頁面。
.claude/skills/hoard-query/report-format.md
# hoard-query 查詢報告格式

不論這次查到或查不到答案,都要附上這份報告。呈現順序固定為:**相關主題 → 查詢紀錄 → 答案(或查無結果訊息)**。

## 查到時

```
---
【相關主題】
- [[頁面A]] 連出的主題:iThome鐵人賽2026(進行中)、writing
- [[頁面B]] 連出的主題:自己

【查詢紀錄】
- Grep:模式「XXX」於 <範圍>,命中:[[頁面A]]、[[頁面B]]、[[頁面C]]
- Read(採用):[[頁面A]]、[[頁面B]]
- Read(未採用,判斷不相關):[[頁面C]]

【答案】
(綜合作答內容,各論點附來源)
```

- 【相關主題】對【查詢紀錄】裡列出的每個已讀頁面(不分採用/未採用),各自執行一次 `grep '\[\['`,把撈到的 wikilink 依下方「主題判準」對應到主題名稱,去重後列出;不列個別頁面連結,也不追蹤展開這些頁面內容、不判斷是否相關。
- 【查詢紀錄】列出這次真的執行過的 Grep 呼叫(模式、範圍)與其原始命中檔名,以及真的 Read 過的頁面——這是工具呼叫的實際紀錄,不是事後改寫的敘述。Read 過的頁面依有沒有拿來組成答案,分成「採用」與「未採用,判斷不相關」兩行,不得只列採用的、漏記 Read 過但沒用上的頁面。

### 主題判準

依 wikilink 路徑對應到哪一層當主題名稱,不得自行發明分類方式:

- `evergreen/topics/<主題名稱>/...` → 主題=`<主題名稱>`
- `evergreen/self/...` → 主題=「自己」
- `projects/active/<專案名稱>/...` → 主題=`<專案名稱>`(標記進行中)
- `projects/archive/<專案名稱>/...` → 主題=`<專案名稱>`(標記已封存)
- `entities/...` → 主題=「entities」
- 不屬於以上任何路徑(例如 wiki 根目錄的 `index.md`、`log.md`)→ 主題=「wiki 頂層」

## 查不到時

```
---
【相關主題】
(若有 Read 過的頁面,同上規則列出;若完全沒有 Read 到任何頁面,這段留白或省略)

【查詢紀錄】
- Grep:模式「XXX」於 <範圍>,命中:[[頁面A]](判斷不相關)
- Read(未採用,判斷不相關):[[頁面A]]

沒有找到足以回答這個問題的內容。
已查範圍:<摘要>
建議視需要自行以 Obsidian 全文搜尋查找,以上不代表沒有相關記錄。
```

- 【查詢紀錄】同上,即使沒查到答案也要附,讓使用者能判斷是「真的查過沒找到」還是「沒有認真查」;這種情況下 Read 過的頁面通常全部屬於「未採用」。
現在這樣就可以用了,有瑕疵的話就後續再優化,不預期一次就做倒好。


 iThome鐵人賽
 看影片追技術