
這篇要講Query,首先
Query 有分使用者查和 AI 查,使用者查就是直接用 Obsidian 的搜尋功能,或是說直接根據資料結構判斷檔案位置,這部份沒什麼好說的,所以從這篇開始往後所有跟 Query有關的敘述,都是
「AI 查」。
還記得我們說過本質上,LLM Wiki 就是一堆 Markdown 檔案 + 一個能操作檔案系統的 Claude 嗎?
先假設檔案夾裡面真的就「只是一堆檔案 + 一個能操作檔案系統的 Claude」。在這種情境下,AI 是怎麼查資料的?
以 Claude 為例,會使用三種主要工具:
Glob 是用檔名/路徑模式找檔案,不看內容、不看時間,適合「我知道檔案長什麼樣子或放在哪個目錄結構,但不確定實際檔名或想批次列出」的情境。
簡單記的話:這個方法「只看檔案名稱」。
舉例:
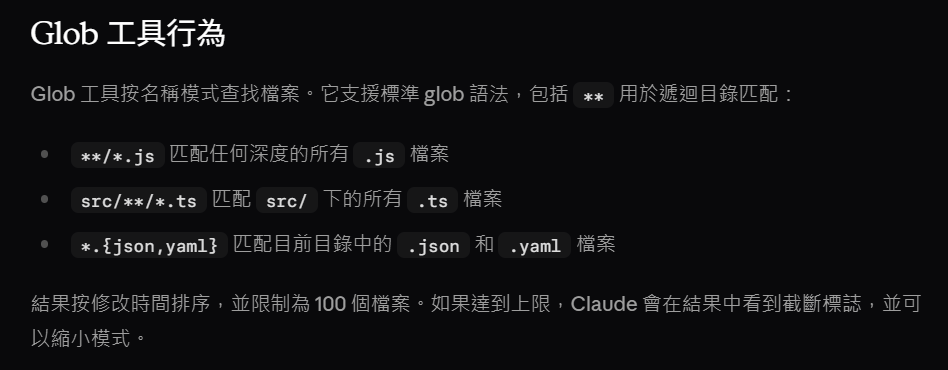
需要詳細 Glob 行為說明,可以到 Claude 官網查,上方截圖就是去官網截的。
Grep 是找檔案「內容」裡有沒有某個字串或模式(pattern),適合找內容,也是最主要 AI 用來搜尋的工具。
舉例:
## [YYYY-MM-DD] 開頭,搜尋 ## \[2026-09 就能篩出某個月份所有操作紀錄,不用整份從頭讀到尾。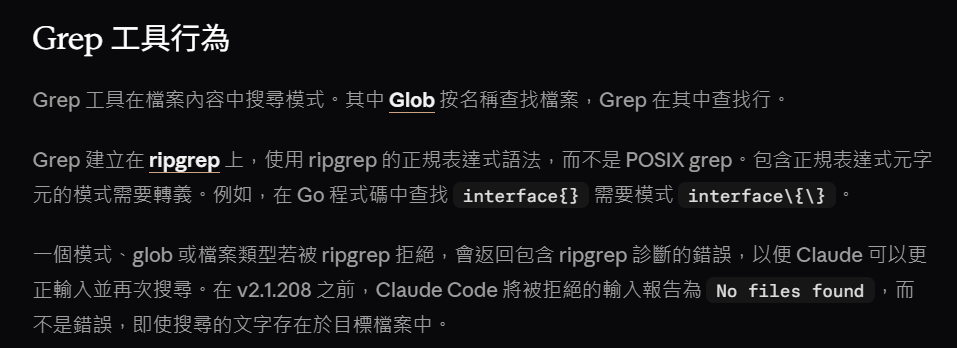
Read 是在你已經知道「就是這個檔案」之後,把完整內容拿進來看。
舉例:
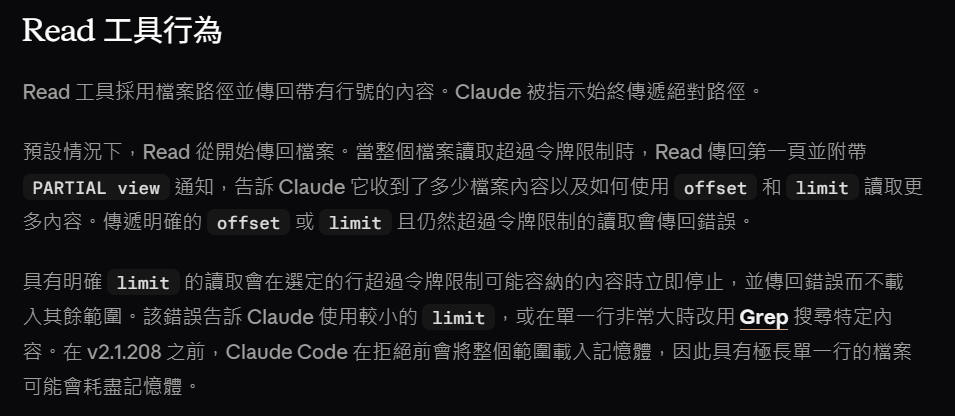
具體流程通常長這樣:
上面這四個步驟「全部」都是 Agent(有工具、能操作檔案系統的那種 AI)自己的行為;更具體地說,是 Claude 的行為。
前面講的是「只是一堆檔案」的情況,沒有CLAUDE.md、index.md這些「導引」,Claude 只能用 Glob 猜「大概在哪裡」。
換成 LLM Wiki 的話,CLAUDE.md 跟 index.md 能夠提供足夠上下文,讓 AI 不用猜。
具體是這樣:
以上就是這篇的全部內容,本來只是弄 LLM Wiki,不知不覺就進入到 Harness 的範疇(Glob/Grep/Read 這三個工具)。
主要是 Query 這個動作越是想要查得澈底,就越需要對 AI 的搜尋有更多了解,因此很自然地,了解 AI 能做什麼成了需要做的事。
在知識庫資料量還沒起來的初期,使用者往往會發現讓 AI 自己搜,不去對查詢做太多的限制與規範,其實會搜的比較快。
但是隨著資料增長,問題肯定會隨之而來,像是:越來越失控的 AI 行為、怎麼問就是查不到的資料、以及 AI 逐漸失智的回答。
細節不顧好,失智的速度就越快,所以持續的學習試錯與調校,這是我一直在做的事。
也鼓勵想建知識庫的夥伴們不要覺得麻煩,如果覺得麻煩,先把我走過的路(文章)看完。


 iThome鐵人賽
 看影片追技術