
第 5 層:人工閘道。Part 1 的最後一天。
前面四層都在講怎麼用機器。這一層講人。
而這一層的核心原則只有一句話:
人只看機器看不出來的東西。
那個案子的人力配置是這樣的:
九輪人工測試  →  找出 187 個問題單
12 輪修復迴圈  →  每輪五件
人在做什麼?比對畫面、找出差異、寫問題單。
這些全部是第 4 層該做的事。
而人被放在第 4 層的後果,Day 18 講過了:疲勞、漏看、成本結構錯誤。但還有一個更嚴重的後果。
當人忙著做偵測,就沒有人在做設計。
12 輪修復、每輪五件、一個下午修六十個。在那個節奏下,沒有人有空停下來問:「這五個是不是同一個 bug?」「這個 pattern 要怎麼防止再犯?」「我們的規則該加在哪一層?」Day 03 講的膨脹、Day 15 講的速度壓過抽象,根源都在這裡。
我的答案是:
人應該專注在「設計」緊箍咒,不是「執行」緊箍咒。
具體來說,人真正不可取代的工作有四類。
一、判斷業務規則的合理性
「這個欄位為什麼必填」「這個狀態轉換的條件對不對」「這個計算規則是法規要求還是歷史遺留」。這些不在程式碼裡,也不在任何文件裡,只在人的腦子裡。
二、判斷架構決策
「這個模組該不該切開」「這個相依方向對不對」。這要看三年後的演進方向,而那個方向只有人知道。
三、設計檢查
這是我認為最被低估的一項。**設計一個好的檢查,是完全的人類工作。**它要抓什麼?放過什麼?什麼時候跑?誤報率能接受到什麼程度?失敗的時候該給什麼訊息?
這些判斷沒有標準答案,而且做得好不好,決定了前面四層有沒有用。
四、每發現一個 bug,決定它該沉澱到哪一層
這是把人的注意力轉化成長期資產的關鍵動作。
上面那四類是我從案子裡歸納出來的。問題是:遇到第五類的時候,你怎麼知道它該不該歸給人?
我後來用一個二分來想這件事,覺得比列舉好用:
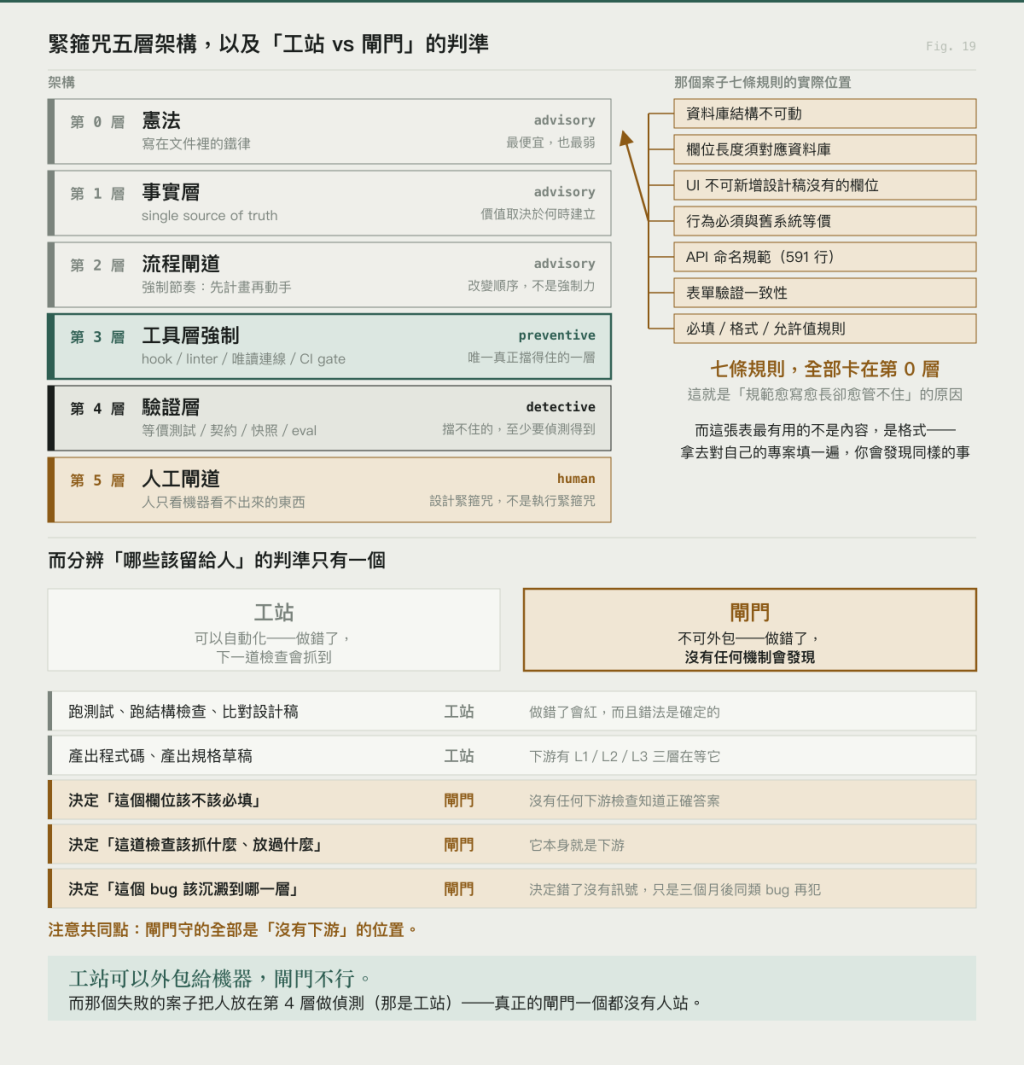
工站   ——  可以自動化的。做錯了,下一道檢查會抓到。
閘門   ——  不可外包的。做錯了,沒有任何機制會發現。
判斷一件事屬於哪邊,問這句:
如果機器在這裡做錯了,錯誤會不會被下游的某道檢查抓到?
如果不會——而且只有「懂這個系統為什麼長成這樣」的人判斷得出來——那它就是閘門。
拿這個判準回頭檢查前面十四天:
| 屬性 | 為什麼 | |
|---|---|---|
| 跑測試、跑結構檢查、比對設計稿 | 工站 | 做錯了會紅,而且錯法是確定的 |
| 產出程式碼、產出規格草稿 | 工站 | 下游有 L1/L2/L3 三層在等它 |
| 決定「這個欄位該不該必填」 | 閘門 | 沒有任何下游檢查知道正確答案 |
| 決定「這道檢查該抓什麼、放過什麼」 | 閘門 | 它本身就是下游 |
| 決定「這個 bug 該沉澱到哪一層」 | 閘門 | 決定錯了,沒有訊號,只是三個月後同類 bug 再犯 |
注意那個共同點:閘門守的全部是「沒有下游」的位置。
這也解釋了那個失敗的案子為什麼會垮。它把人放在第 4 層做偵測(那是工站,機器做得比人好),而真正的閘門一個都沒有人站。規格沒有人拍板、檢查沒有人設計、bug 沒有人決定沉澱到哪。
一句話:
工站可以外包給機器,閘門不行。
而分辨兩者的問題只有一個:做錯了,還有沒有人會發現。
那個案子的修復流程,每個 bug 修完之後問的是:
「修好了嗎?」
而應該問的是:
「這個 bug 怎麼變成自動規則,防止再犯?」
這兩個問題的差距有多大?我只能給一個下界:**Day 03 拆過的那一輪,35 張單收斂成 18 個原因。**如果每一個原因在第一次出現的時候就被沉澱成規則,後面那些重複出現的就不會再變成問題單。
至於 187 張最後會收斂成幾條,我沒有算過。那需要把九輪的單全部攤開、按原因重新歸一次類,而那份資料我手上沒有。所以這裡不給數字,只給方向。
我後來把沉澱的去處整理成一張表,優先序由上到下:
| 原因 | 沉澱到哪 | 為什麼 |
|---|---|---|
| 能用腳本擋 | 第 3 層加一條檢查 | 最優先,一勞永逸,零 context 成本 |
| 範例不夠好 | 去改黃金範例 | 改一次,之後所有產出都受惠 |
| 規則沒寫 | 開一份決策紀錄 + 更新審查清單 | 有紀錄、有理由、可追溯 |
| 反覆發生且影響大 | 才升格為第 0 層鐵律 | 而且仍然 ≤5 條,滿了要汰換 |
注意順序:寫進第 0 層是最後手段,不是第一反應。
Day 13 講過為什麼。第 0 層最便宜也最弱,而且會佔 context、會稀釋優先序、會漂移。
而大多數團隊的直覺剛好相反:出事了就往規範文件加一條。加到第十七條的時候,那份文件已經沒有人在讀了。
把 Part 1 收在一張表上。這是那個案子的規則,現在在哪層、應該在哪層:
| 規則 | 當時在哪層 | 應該在哪層 | 具體做法 |
|---|---|---|---|
| 資料庫結構不可動 | 第 0 層(方框) | 第 3 層 | 唯讀連線 + hook 攔截 Migration 指令 |
| 欄位長度須對應資料庫 | 第 0 層(檢查清單) | 第 1 + 4 層 | 事實層工具強制查詢 + 契約測試比對 |
| UI 不可新增設計稿沒有的欄位 | 第 5 層(人工發現) | 第 4 層 | 對設計稿做快照比對,差異就擋 |
| 行為必須與舊系統等價 | 第 0 層(規範文字) | 第 4 層 | 行為等價測試:兩系統並行跑、自動比對 |
| API 命名規範(591 行) | 第 0 層 | 第 3 層 | Linter 規則 + CI gate 自動拒絕 |
| 表單驗證一致性 | 第 0 層(清單) | 第 1 + 3 層 | 前後端驗證從同一份來源生成 |
| 必填/格式/允許值規則 | 第 0 層(六項清單) | 第 1 + 4 層 | 事實層工具 + 自動契約測試 |
七條規則,全部卡在第 0 層。
這就是「規範愈寫愈長卻愈管不住」的原因。
而這張表最有用的地方不是它的內容,是它的格式。你可以拿去對自己的專案填一遍,然後你會發現同樣的事。
如果要濃縮 Part 1 這八天,我會用三個方向。
一、From advisory to preventive(從告誡到封鎖)
把規則從「寫在文件裡」搬到「寫在工具裡」。每一條 advisory 規則都問:這條能不能用工具強制?
二、From rules to specs(從規則到規格)
從「禁止做什麼」進化到「明確規定要做什麼」。
規格比規則更不容易被誤解。「這個欄位必填」可能被解讀成「永遠必填」或「某情境下必填」,但一份結構化的規格定義沒有解釋空間。
而且規格是工具的輸入,AI 不會去「猜」規格。
三、From human review to harness(從人工審查到機器試煉)
把品質守門的工作,從人移交給可重複跑的測試。
人設計緊箍咒,機器戴緊箍咒。
回到 Day 11 那個比喻。
孫悟空那個緊箍咒之所以有效,不是因為金屬硬,是因為它:
而我們寫在文件裡的「絕對禁止」,兩個性質都沒有。
所以那個案子留下最重要的一課,我用一句話收掉 Part 1:
規範文件愈長,往往代表它在愈底層。
因為真正有效的緊箍咒不需要 591 行說明,只需要一個 hook 腳本或一條 CI gate。
如果這八天你只帶走一件事,我希望是這個檢查動作:
打開你的規範文件,逐條問「這條在第幾層?」
如果還在第 0 層,那它就還沒有設計完。
明天開始 Part 2。前面十六天都在講「為什麼會失敗」,接下來要講「做對了長什麼樣」。而且有數據。那是同一個團隊的另一個案子:43 次執行、一次通過率 36/37、350 條測試全綠,而且它跑的是真實的錢。


 iThome鐵人賽
 看影片追技術