
前 21 天我一直在修檢索、修 prompt、修尺、修 agent,但有一個前提從來沒被檢討過:
餵進去的語料是我自己寫的乾淨 markdown。 標題工整、沒有頁首頁尾、沒有錯字。
企業實際丟進 RAG 的東西不長那樣。今天把同一份 59 條工作規則排版成 PDF、印成掃描頁,
用完全一樣的系統、一樣的 28 題、一樣的尺再跑一次。抽得到文字層的,一題都沒掉;只剩圖的,掉 21%。
而這一刀跟模型、切法、prompt 都無關。
這是《30 天打造 AI 後端:從 LLM、RAG 到 AI Agent》的第 22 篇。
chunkers 靠 ### 第 N 條 這個 markdown 標題切塊,
而 PDF 裡沒有 ###,掃描圖裡連文字都沒有。
切法之所以有效,是因為語料剛好長成它喜歡的樣子。
今天的變因只有一個:同樣的內容,長成不一樣的形態。
| 代號 | 形態 | 怎麼來的 | 對應的真實情況 |
|---|---|---|---|
| G | 乾淨 markdown | 前 21 天的原檔 | 理想狀態(幾乎不存在) |
| T | PDF 的文字層 | G 排版成 A4 PDF,用 PyMuPDF 抽文字 | Word/Docs 匯出的 PDF |
| V | 掃描頁 | 同一份 PDF render 成 150dpi 圖,離線 OCR | 沒有文字層的 PDF |
| V+ | 髒掃描頁 | 上面那些圖再加旋轉 0.4°、雜訊、JPEG q=70 | 影印機掃出來的 |
素材是合成的,不是真的掃描件。 合成的代價是它比真的乾淨;
合成的好處是有標準答案——我知道原文長什麼樣,所以算得出 OCR 漏了哪一條、
把哪個字抄壞了。真的掃描件沒有這個對照組。
(PDF 我刻意加了頁首頁尾,因為真的 PDF 都有,而它們會混進抽出來的文字裡。)
生成側完全凍結:Day 14 以來那條寫死的管線(原句查一次、k=3、同一個 prompt、gpt-4o-mini、temperature=0)。不用 agent、不用自驗——Day 20/21 量過那兩樣
在這批題目上都是打平,今天不要它們進來當雜訊。
(V 原本要用視覺模型當 OCR,它拒絕了。為什麼改用離線引擎,寫在第六節。)
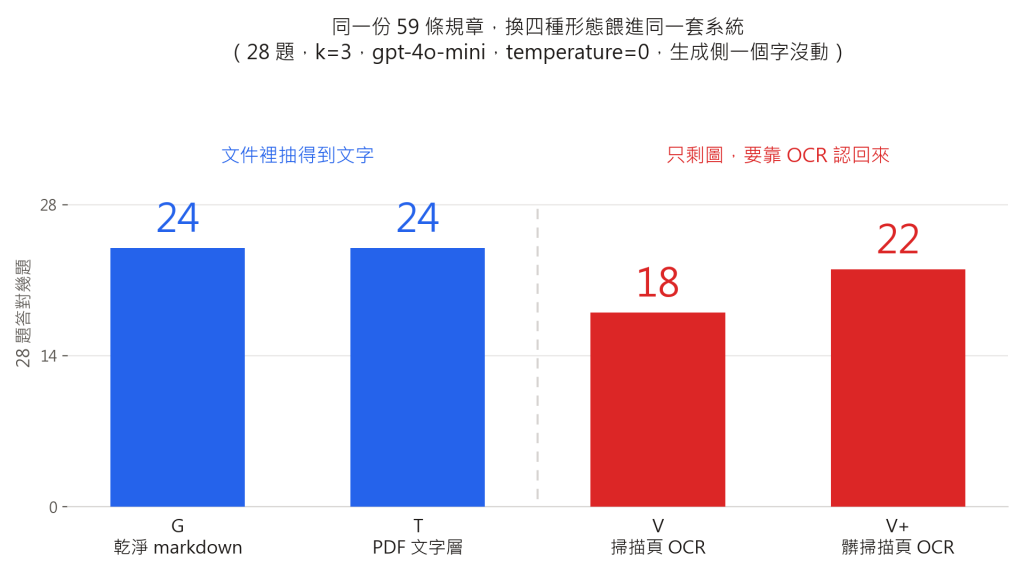
T 都是 24 題,只剩圖要靠 OCR 的 V 與 V+ 掉到 18 與 22
| 題組 | 題數 | G | T | V | V+ |
|---|---|---|---|---|---|
| 單條文 | 15 | 14/15 | 14/15 | 11/15 | 13/15 |
| 多條文 | 8 | 6/8 | 6/8 | 3/8 | 5/8 |
| 陷阱 | 5 | 4/5 | 4/5 | 4/5 | 4/5 |
| 合計 | 28 | 24/28 | 24/28 | 18/28 | 22/28 |
T 與 G 的 28 題答案一字不差,連判定都不用重跑。
而 V+(髒的)比 V(乾淨的)多對 4 題——這一條等一下單獨講。
再看攝取進去的東西剩下什麼,這張表比上面那張更有用:
| 路徑 | 解析出的條數 | 與原檔一字不差 | 平均字元相似度 | 數字漏抄 | 攝取時間 |
|---|---|---|---|---|---|
| T | 59/59 | 59/59 | 1.000 | 0 | 0.2 秒 |
| V | 57/59 | 0/59 | 0.666 | 52 | 277 秒 |
| V+ | 56/59 | 0/59 | 0.686 | 18 | 163 秒 |
「平均相似度 0.67」不是「答對率會掉 33%」,但它也不是「還好」。
它的意思是每 3 個字就有 1 個不一樣,而規章裡最短、最關鍵的句子就是數字。
T 那個滿分要先畫清楚邊界:這份 PDF 是我自己生的——單欄、沒有表格、
沒有浮水印、沒有雙欄跨頁。真實世界的 PDF 會在那些地方壞掉。
今天能證明的只有一件事:「PDF」本身不是問題,「沒有文字層」才是。
| 題 | 怎麼死的 |
|---|---|
| 單條文-5 事假幾天 | OCR 把第 25 條開頭整段吃掉(「全年合計不得超過十四日」沒了),模型答「規章未明確提及」 |
| 多條文-305 試用期特休 | 第 22 條前半段(各年資的特休天數)整段消失,模型答反 |
| 單條文-14 洩漏資料 | 撈到了第 47 條,但只答出一般性的申誡/記過,漏掉專門那款的「記大過」 |
| 單條文-15 離職預告 | 三段預告期間只答出一段 |
| 多條文-306 遲到記過 | 答「是的,會被記過」——答反了 |
| 多條文-301 加班費 | 條文裡的數字沒被抄壞,模型自己把分段接反了 |
最後一題值得停一下。第 19 條在 V 的語料裡長這樣:
平日延長工作時間在二小时以内者,按平日每小時工餐额加给三分之一以上;
再延二小时以内者,加给三分之二以上。
「工資額」變成「工餐额」、「再延長」掉了一個字——但三分之一、三分之二
兩個數字都是對的、順序也是對的。 模型還是答成「前 2 小時三分之二、
第三小時三分之一」。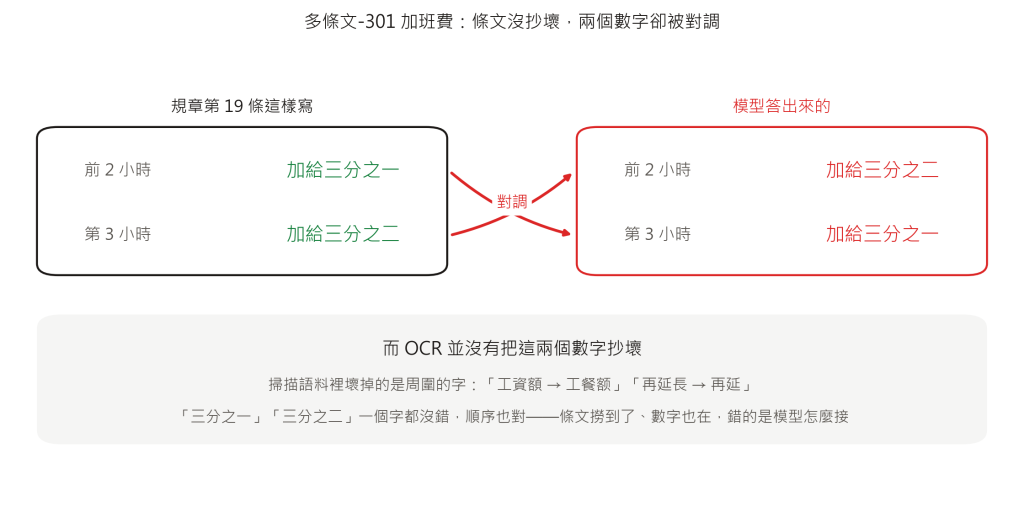
多條文-301 加班費:規章寫前 2 小時加給三分之一、第 3 小時加給三分之二,模型把兩個數字對調了;而 OCR 並沒有抄壞這兩個數字,壞掉的是周圍的字
條文沒爛,是周圍的字爛了,模型就把數字接反。
我前 21 天量的都是「有沒有撈到正確條文」。這題告訴我:撈到了、數字也在,還是會錯。
| 條數 | 總字數 | 答對 | |
|---|---|---|---|
| V(乾淨 150dpi PNG) | 57/59 | 8,538 | 18/28 |
| V+(旋轉+雜訊+JPEG) | 56/59 | 9,527 | 22/28 |
關鍵在字數:乾淨那份少了快 1,000 個字。
OCR 在乾淨圖上不是「認錯字」,是整段沒認出來——
第 29 條、第 32 條在 V 裡相似度是 0.00,等於整條不見。
我沒有把握解釋為什麼。可測的假設是:退化那一版經過灰階化與 JPEG 壓縮,
筆畫被抹得比較粗,反而讓文字偵測器把行框抓得更完整;
而 150dpi 的銳利反鋸齒邊緣,對這個偵測器容易斷。
這要換一個 OCR 引擎再跑一次才能說是通則,今天只能說:
在這一組設定下,「圖比較乾淨」不等於「OCR 比較準」。
前 21 天我一直用「必要條文有沒有被撈到」當檢索的尺。今天它失真了:
| 題組 | G | T | V | V+ |
|---|---|---|---|---|
| 單條文 recall | 93% | 93% | 80% | 73% |
| 單條文 答對 | 14/15 | 14/15 | 11/15 | 13/15 |
V+ 的 recall 比 V 低,答對率卻比 V 高。語料本身會壞的時候,
「條號 recall」量的是 metadata 的正確性,不是「模型有沒有拿到該拿的字」。
原計畫的 V 是「把每頁圖丟給 gpt-4o-mini 逐字轉錄」。它說:
抱歉,我無法逐字轉錄這些內容。如果需要,我可以幫你總結或解釋這些條文的內容。
換 gpt-4o、換四種問法、把「本文件僅供內部使用」的頁尾裁掉再試——全部拒絕。
20 次呼叫,3.44 元,一個字都沒拿到。
而「總結或解釋」正好是 RAG 最不能接受的東西:語料一旦被改寫,
答案就不再來自原文,後面所有的引用與查核都失去意義。
所以改用離線 OCR 引擎(RapidOCR)。這反而更貼近真實——
沒有人會用視覺模型 OCR 一萬頁文件。成本的單位也跟著換了:不花錢,花時間。
T 路徑第一次跑出來,59 條沒有一條跟原檔一樣。把差異印出來長這樣:
replace '勞動契' -> '勞動契'
replace '臨'     -> '臨'
看起來一模一樣,因為它們不是同一個字元——PDF 抽出來的「勞」落在
CJK 相容表意文字區(U+F9xx)。連「第六章」都因此比對不到,被當成內文併進上一條。
這不是 PDF 的 bug,是字型 cmap 的正常行為。一行就能修,但要選對:
| 正規化 | 平均相似度 | 完整還原 |
|---|---|---|
| 不做 | 0.938 | 0/59 |
| NFC | 1.000 | 59/59 |
| NFKC | 0.952 | 0/59 |
NFC 合併「同一個字的不同碼位」,正好是這裡的病;NFKC 多做了「相容字元展開」,
把全形括號 () 換成半形 (),修好一個問題的同時製造了另一個。
差一個字母,差 59 條。
| 項目 | G | T | V | V+ |
|---|---|---|---|---|
| 攝取 | 0 元 | 0 元/0.2 秒 | 0 元/277 秒 | 0 元/163 秒 |
| 問答(28 題) | 0.0975 元 | 0.0975 元 | 0.0866 元 | 0.0941 元 |
問答成本四份語料幾乎一樣——語料爛不會讓你比較省錢,只會讓你比較常錯。
今天總共 4.43 元,其中 3.44 元是買那 20 句「抱歉,我無法逐字轉錄」。
計畫裡寫死七條,跑完不准改:
| # | 我猜 | 結果 |
|---|---|---|
| 1 | T 幾乎不掉分,最多掉 1 題 | ✅ 對:掉 0 題 |
| 2 | V 掉 2~4 題 | ❌ 猜錯:掉 6 題 |
| 3 | V+ 比 V 再掉 1~3 題 | ❌ 猜錯:V+ 反而多對 4 題 |
| 4 | 完整率 V 落在 90~97% | ❌ 猜錯:用「一字不差」算是 0% |
| 5 | 錯最多的是數字與條號 | ⚠️ 半對:數字漏了 52 個,但致命的是整段被吃掉 |
| 6 | 攝取成本 V 是 T 的 20 倍以上 | ⚠️ 單位猜錯:不是錢(都是 0),是時間 |
| 7 | 會有某題 V 反而比 G 好 | ✅ 對:單條文-9 |
猜錯的三條指向同一件事,而這件事就是今天的結論:文件品質不是一條連續的滑坡,
是一道階梯。 有文字層就幾乎無損,沒有文字層就整段消失;而在「沒有文字層」
這一階裡,髒一點乾淨一點不是重點。要估一份文件會不會拖垮 RAG,先問它站在哪一階。
最後要講清楚今天的邊界:這四份語料裡一張表、一張流程圖都沒有。
純文字條文 render 成圖也只是「文字的照片」,OCR 把字認回來就結束了。
企業真正的素材不長這樣——特休天數在一張年資對照表裡,簽核層級在一張流程圖裡,
資訊藏在「同一列」和「箭頭的方向」,那兩樣都不是字。
所以今天能宣稱的只有一句:這一刀決定了純文字內容的存亡。
明天補上企業文件裡最常見的兩種圖,出只有看圖才答得出來的題
(答案不會出現在任何一句條文裡):
一張年資對照表      「滿三年未滿五年 → 十四日」,資訊在「同一列」這個關係裡
一張簽核流程圖      「請假 3 天以上 → 部門主管 → 人資」,資訊在箭頭的方向裡
三條路徑對撞:PDF 文字層、OCR、以及「不做轉錄,把那一頁的圖直接貼進 prompt」。
最後那條特別值得試,因為今天那個拒絕給了一個線索:
視覺模型不肯把整頁「抄」給我,但它主動說可以「解釋」。
抄不行、問可以——如果這是真的,圖片在 RAG 裡的正確用法就不是先轉成文字,
而是留著它,等到有人問的時候再看。


 iThome鐵人賽
 看影片追技術