
昨天文末我留了一句話當預告:企業真正的素材不是純文字。特休天數藏在「滿三年未滿五年|十四日」的同一列裡,簽核層級藏在箭頭的方向裡。那兩樣都不是字。今天照預告把它測掉。加兩張表、一張流程圖,出 8 題只有看圖才答得出來的題目,三條路對撞。結果一半對一半錯。表格活下來了,5 題全對;塌的是那張流程圖。而且是這樣塌的:OCR 把方塊裡的字一個不漏地認回來,答案照樣錯。它拿得到字,拿不到「哪個方塊屬於哪一條路徑」。七條預測錯四條。
三句話。後面每一節都只是在證明其中一句。
還有一條跟錢有關的,我到現在還是覺得怪:處理圖片的時候,不要預設 mini 比較省。同一張 150dpi 的 A4,gpt-4o-mini 收 36,891 個 token,gpt-4o 收 1,161 個,差 32 倍。便宜的那個模型在圖片上比較貴,答得還比較差。(六節)
總分(8 題新題,答案不在任何一句條文裡):
| 題型 | 題數 | T(文字層) | O(OCR) | M-mini | M-4o |
|---|---|---|---|---|---|
| 表格 | 5 | 5/5 | 5/5 | 2/5 | 5/5 |
| 流程圖 | 3 | 1/3 | 2/3 | 1/3 | 0/3 |
| 合計 | 8 | 6/8 | 7/8 | 3/8 | 5/8 |
為什麼是這四個數字,看下面這張表就知道了。攝取之後,每一段還剩幾個字:
| 段落 | T(文字層) | O(OCR) |
|---|---|---|
| 附表一 | 119 字 | 121 字 |
| 附表二 | 119 字 | 162 字 |
| 附圖一 | 0 字 | 150 字 |
兩張表兩條路都拿得到字,所以表格題打平。附圖一在 T 那條路是 0 字,在 O 那條路有 150 字,而那 150 個字就是下面所有麻煩的來源。
昨天的結論是「PDF 有沒有文字層,決定純文字內容的存亡」。但那份語料從頭到尾是條文,沒有任何一個需要看圖才懂的東西。渲染成圖也只是「文字的照片」,OCR 把字認回來就結束了。表格的資訊在「同一列」這個關係裡,流程圖的資訊在箭頭的方向裡,這兩樣都不是字,認得再準也不保證拿得到。所以在 59 條後面加一份附件,兩頁:
| 素材 | 形態 | 為什麼選它 |
|---|---|---|
| 附表一 健康檢查補助標準表 | 用文字與線條畫的表格 | 文字層抽得到字,但欄列關係會不會塌? |
| 附表二 教育訓練補助標準表 | 同上 | 兩張表才看得出是通則還是巧合 |
| 附圖一 請假簽核流程圖 | 點陣圖貼進 PDF | 簡報截圖貼進 Word,企業文件最常見的那種 |
8 題新題:5 題表格(「45 歲健檢補助上限多少?」)、3 題流程圖(「請假 5 天要經過哪些人簽核?」)。標準答案不是我事後判讀圖片,是產生器裡的那幾個,表格與流程圖就是用它們畫出來的。
昨天預告寫的是「年資對照表」,實際做出來是健檢與教育訓練補助表。原因是這樣:附件的主題要前 22 天一題都沒問過才安全,而特休年資前面早就問過了,拿它當附件會回頭改掉舊題目的答案。換掉的是題材,要驗的東西(欄列關係存不存在)一樣。四條路徑,檢索與生成全部凍結(k=3、P1 prompt、temperature=0):
T        PDF 文字層 → 切塊 → 塞進 prompt      最常見的做法
O        頁面圖 → 離線 OCR → 同上             掃描件只能這樣
M-mini   檢索一樣,但把那一頁的圖貼進 prompt   多模態 RAG(gpt-4o-mini)
M-4o     同上,換 gpt-4o
M 的檢索與 T 一模一樣,差別只在最後一步交給模型的是「字」還是「圖」。
這是今天最該承認的一條。我的預測是「T 會抽到一堆數字、把年齡對到錯的金額,而且答錯還很有自信」。實際上 PyMuPDF 抽出來的表格長這樣:
未滿 30 歲 2,000 每三年一次
30 歲以上未滿 40 歲 3,500 每二年一次
40 歲以上未滿 50 歲 6,000 每年一次
列是完整的。 PDF 的文字物件帶著座標,抽取時是一列一列吐出來的,「45 歲 → 6,000」這個關係沒有丟。5 題表格題,T 全對,O 也全對。
附圖一是一張點陣圖。同一題「請假 5 天要經過哪些人簽核?」,T 跟 O 錯得完全不同。先說清楚附圖一跟前面兩張表差在哪,因為這是今天所有事情的分界線。
兩張表看起來也像「圖」,但它們是用 PDF 的文字物件跟線條排出來的,每個字都帶座標。附圖一不是。它是先用 PIL 畫成一張 1380×600 的 PNG,再整張貼進頁面:
img = Image.new("RGB", (W, H), "white")          # 用畫的
page2.insert_image(img_rect, filename=FLOW_PATH)  # 整張貼上去
所以它在文字層裡一個字都沒有,整張只有像素。它長這樣:
附圖一 請假簽核流程圖:四列並排。半日以下是提出申請→直屬主管→完成;逾半日未滿三日多一關部門主管;三日以上未滿十日再多一關人資單位會簽;十日以上最後再加總經理核准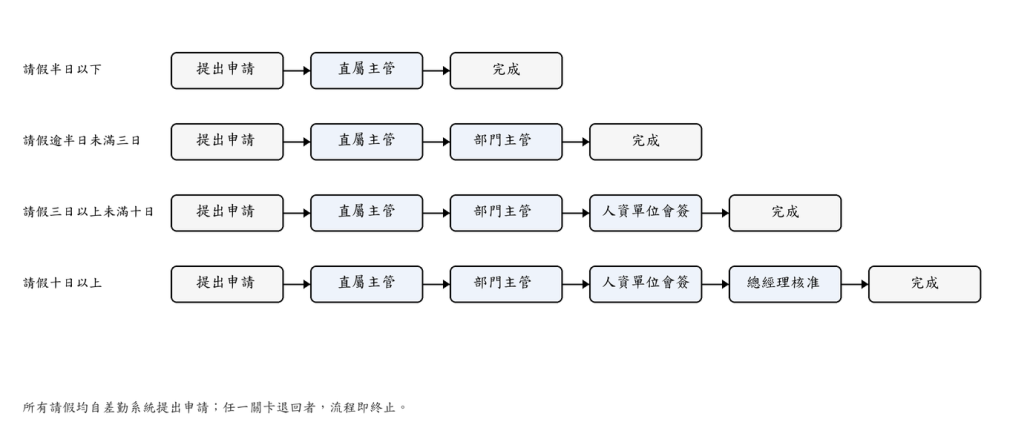
請假 5 天走第三列(三日以上未滿十日),三關:直屬主管、部門主管、人資會簽。
總經理只出現在第四列。下面兩種錯法,對著這張圖看就知道問題出在哪。
同一題「請假 5 天要經過哪些人簽核?」,T 跟 O 錯得完全不同。
死法一:語料裡沒有,模型不會空著。
T 的文字層裡那一段是 0 字,只剩一行圖表標題。它的答案是:
請假5天需經過職務代理人同意及直屬主管核准後,方可離開職務。
它沒有說「規章未規定」。它去撈了第 30 條(請假一日以上要指定職務代理人),
把一個不相干的條文編成了一個簽核流程。
死法二:字全部認對了,關係還是丟了。
O 這條路把圖裡的字讀出來了,150 字,長這樣:
请假签核流程圖提出申直属主管请假半日以下完成提出申请直属主管部門主管
请假逾半日未满三日完成直屑主管提出申请部門主管人资罩位會签假三日以上未满十日完成…
簡繁混雜、缺字,「人資單位」變成「人资罩位」。但關鍵詞一個都沒少,
所以 503(請假 12 天還要誰核准)它答對了:總經理。
501 它照樣答錯:
首先由直屬主管提出申請,接著由部門主管及人資會簽,最後需經總經理核准。
總經理是「十日以上」那一列才有的。OCR 讀得到方塊裡的字,讀不到「哪個方塊屬於哪一條路徑」,箭頭與列的對應關係就是在這裡沒了。
兩種死法的來源是同一件事:表格的列關係因為座標而活了下來,流程圖的箭頭關係沒有座標可依靠,變成一串沒有順序意義的詞。
M-4o 在表格題 5/5,流程圖題卻是 0/3。最關鍵的一題是 503:
問題:請假 12 天,除了直屬主管、部門主管和人資之外,還要誰核准?
T 的檢索 top-3:第 30 條、第 31 條…(附圖一完全沒進來)
→ M 沒有圖可以貼 → 退回吃文字 → 跟 T 錯得一模一樣
附圖一在文字索引裡只有一行標題,它幾乎沒有東西可以被比對,而問題裡那些「主管」「人資」「核准」反而跟一般條文更像。這一題的勝負,在多模態被呼叫之前就已經決定了。
另外兩題流程圖題 M 有拿到圖,但也不穩。M-4o 的 501 只講了直屬主管與部門主管,漏掉人資會簽。502「請假半天需要部門主管簽核嗎」它答「需要經過直屬主管簽核」,沒有正面回答要不要,依 Day 21 對 306 的同一把標準記不完整。這一筆最接近邊界,翻成正確的話 M-4o 就是 6/8。
| 路徑 | 模型 | 輸入 token | 8 題成本 | 每題 | 對 T 的倍數 |
|---|---|---|---|---|---|
| T | gpt-4o-mini |
3,674 | 0.0213 元 | 0.0027 元 | 1× |
| O | gpt-4o-mini |
4,068 | 0.0223 元 | 0.0028 元 | 1× |
| M-mini | gpt-4o-mini |
259,039 | 1.2111 元 | 0.1514 元 | 57× |
| M-4o | gpt-4o |
8,929 | 0.7583 元 | 0.0948 元 | 36× |
每題差 0.09 元聽起來沒事,換成上線的量就有感:一天一千個問題,走文字是 2.7 元,每題貼一張圖是 95 到 151 元。差的不是幾成,是兩個數量級。
那為什麼 mini 的同一張圖要多收這麼多?這件事查得出來,所以我去查了。
官方對 4o 這一家的算法寫得很清楚:detail: "high" 的圖先縮到短邊 768,數裡面有幾個 512×512 的方塊,每塊 170 token,再加 85 的底。我這張 A4 是 6 塊。mini 那組數字官方沒寫,社群回報是底 2,833、每塊 5,667:
gpt-4o          85 + 170   × 6 =  1,105
gpt-4o-mini  2,833 + 5,667 × 6 = 36,835     底與每塊都剛好是 4o 的 33.33 倍
這組數字可以驗,不必相信我。把它從 API 回報的 input token 裡扣掉,剩下的就是文字的部分,而文字兩邊是一樣的:
題        401  402  403  404  405  501  502
4o  扣完  105  104  110  101  104  103  101
mini 扣完  105  104  110  101  104  103  101
七題、兩列,一個字都不差。所以圖片 token 就是固定的 33.33 倍,跟圖的內容無關,也不是「mini 看得比較仔細」。
接下來這一步才是重點。mini 的文字單價便宜 16.67 倍(0.15 對 2.50),圖片 token 多 33.33 倍,兩個一除:
同一張圖,mini 的圖片費用正好是 4o 的兩倍。
mini 省的是文字。圖片上它從定價設計就沒有便宜過,而且是固定貴一倍,不會因為你換圖、調解析度而改變。我一開始那個「mini 比較省」的直覺,錯的不是程度,是方向。
day23_rag/ 裡有兩樣東西可以直接搬。
一是題目怎麼出。8 題的標準答案不是我事後看圖判讀的,是 make_annex_day23.py 裡畫圖用的那幾個 dict,圖是從答案長出來的,不是反過來。這樣「我自己看錯圖」就不可能變成標註誤差,重跑也不必重新判讀一次。
二是圖片不要先轉文字,留著等人問。檢索完全沿用文字那條路,只有最後一步改成把「那一頁」貼進去:
hits  = chroma_store.retrieve(collection, vectors[0], K)   # 與 T 完全相同
pages = [SOURCE_PAGE[h["meta"]["annex"]] for h in hits if ...]

if not pages:                       # 一張圖都沒對到
    out = answer_text(collection, question)
    out["fell_back"] = True         # ← 這一行是今天報表的關鍵
    return out

content = [{"type": "text", "text": f"以下是規章的內容(圖片)。\n問題:{question}"}]
for page in pages:
    raw = (PAGE_DIR / f"annex_p{page}.png").read_bytes()
    content.append({"type": "image_url", "image_url": {
        "url": "data:image/png;base64," + base64.b64encode(raw).decode(),
        "detail": "high"}})
fell_back 那一行不起眼,但沒有它,503 就會被記成「多模態答錯了」,而真相是多模態根本沒上場。一條路徑答錯的時候,要先問它是不是連題目都沒拿到。
| # | 我猜 | 結果 |
|---|---|---|
| 1 | 流程圖題 T 與 O 掛零 | ❌ 錯:T 1/3、O 2/3 |
| 2 | 表格題 T 錯 3 題以上 | ❌ 大錯:T 5/5 |
| 3 | M 是唯一答得出流程圖題的 | ❌ 錯:M-4o 0/3 |
| 4 | M 在表格題至少 4/5 | ⚠️ 半對:M-4o 5/5、M-mini 2/5 |
| 5 | M-4o 比 M-mini 便宜 | ✅ 對:0.76 vs 1.21 元 |
| 6 | O 比 T 更糟 | ❌ 錯:O 7/8 > T 6/8 |
| 7 | 舊 28 題最多 2 題的 top-3 會變 | ✅ 對:1 題 |
七條錯四條。錯的四條有一個共同的來源:我假設「圖片」是一種東西。
語料這一側到今天收工,明天開始把這 22 天的實驗腳本變成一支真的服務。
明天 Day 24 開始換一個階段:前面 23 天都在量語料與檢索,明天起把這些腳本收成一支真的服務。要從頭跟這一段的話,現在是剛好的時間點——


 iThome鐵人賽
 看影片追技術