
昨天我們學會了查證 AI 提供的資料,但即使資料來源可靠,如果一開始交代的任務很模糊,AI 仍可能產生一篇「看起來很完整,實際上不能用」的答案。
例如,許多第一次使用生成式 AI 的同學會輸入:
幫我想一個厲害的 AI 專題。
這句話沒有錯,但 AI 不知道:
因此,AI 只能自行猜測。
今天要學的不是某一句神奇咒語,而是如何把模糊想法整理成一份「AI 看得懂、團隊能重複使用、成果可以驗收」的小型任務規格。
提示詞(Prompt)就是我們交給 AI 的任務說明。
好的提示詞和向組員分配工作很像。假設你只對組員說:
幫我做一份簡報。
對方一定還會想知道主題、觀眾、頁數、截止時間及評分標準。
AI 也是如此。
Google 的官方提示設計指南指出,清楚、具體的指令是調整模型行為的有效方式;提示工程本身也是反覆實驗與改善的過程。Anthropic 的官方指南則建議,在改善提示詞前,應先定義成功標準,並準備可以實際測試的方法。
換句話說,提示詞的目的不是讓文字看起來很專業,而是降低 AI 猜錯需求的機率。
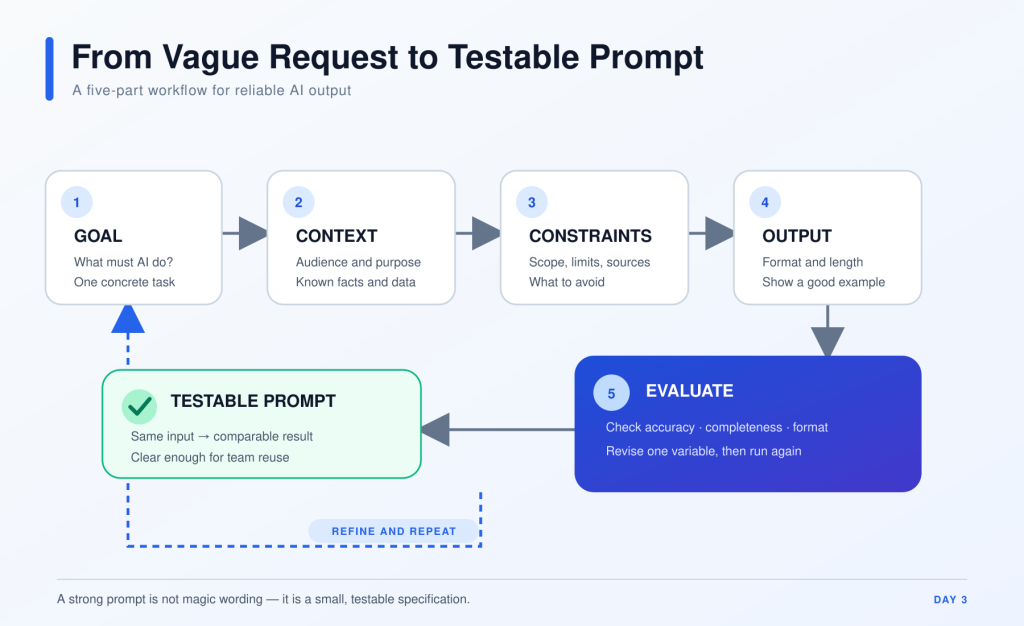
我把適合初學者的提示詞結構整理成五個欄位:
圖 1:從模糊需求到可驗收提示詞的五步流程。製作方式:依 OpenAI、Anthropic 與 Google 官方提示指南整理,以 SVG 自製並輸出為 PNG。
圖片替代文字:
提示詞從任務、背景、限制、輸出格式到驗收與反覆修改的五步流程圖。
一個提示詞最好先有一個主要動作。
例如:
不建議一次要求 AI:
幫我想題目、找資料、寫程式、做簡報、預測評審問題,最後再幫我檢查。
任務塞得越多,越難判斷是哪一個步驟出了問題。
比較好的寫法是:
請先提出五個 AI 專題方向。本次只進行題目發想,不撰寫程式或簡報。
AI 不知道你的課程規則、團隊能力及真實需求,除非你主動提供。
可以補充:
例如:
我們是四位非資訊科系的大一生,將參加校內 AI 專題競賽。專題製作時間為八週,成員會使用 ChatGPT、Google 表單與 Canva,但目前沒有網站開發經驗。
這段背景比「你是一位世界級專家」更有用,因為它提供了真正影響答案的資訊。
角色設定不是完全沒用,但應該用來指定觀察角度,例如:
請以大學專題評審的角度,檢查這個構想是否具有明確問題、目標使用者與展示價值。
限制不是越多越好,而是要排除目前不能接受的方案。
常見限制包括:
例如:
優先使用具有免費方案的工具,不自行訓練大型模型,不蒐集敏感個資。題目必須能在八週內完成最小可行版本,並能於五分鐘內展示主要功能。
限制能避免 AI 提出「理論上很厲害,實際上做不完」的專題。
如果沒有指定格式,AI 可能回傳一大篇文章;但你真正需要的也許是一張比較表。
可以指定:
例如:
請以 Markdown 表格輸出五個題目。欄位包含:題目名稱、目標使用者、真實痛點、需要的資料、AI 的作用、八週 MVP、主要風險。
如果你有理想答案,可以再提供一個範例。OpenAI 與 Google 的官方指南都提到,少量且格式一致的輸入/輸出範例,可以幫助模型掌握期望的格式與模式。
例如:
範例題目:校園剩食媒合助手
目標使用者:學生與校內餐廳
真實痛點:打烊前仍有可食用餐點,但學生不知道
AI 的作用:根據預算、距離及飲食限制排序選項
範例不是要 AI 照抄題目,而是告訴它答案應有的具體程度。
這是最常被忽略的一步。
如果沒有成功標準,我們只能憑感覺說:
這個答案好像不錯。
比較好的方式,是先建立簡單的評分表。
| 驗收項目 | 0 分 | 1 分 | 2 分 |
|---|---|---|---|
| 問題明確 | 沒有真實問題 | 問題存在但模糊 | 使用者與情境明確 |
| 可行性 | 時間內無法完成 | 需要大量簡化 | 八週內能做出 MVP |
| AI 必要性 | 不使用 AI 也一樣 | AI 只有附加效果 | AI 是核心處理環節 |
| 資料可得性 | 找不到資料 | 需要自行大量蒐集 | 有開放或可合法取得資料 |
| 展示效果 | 無法現場操作 | 只能展示部分成果 | 五分鐘內能完成完整 Demo |
總分為 10 分。
可以把這張表一起交給 AI:
請依照問題明確度、可行性、AI 必要性、資料可得性及展示效果,各以 0~2 分評分。請說明扣分原因,不要為了鼓勵我而全部給高分。
這樣,同一組的不同構想才能用相同標準比較。
以下是一份適合非本科大一生進行 AI 專題發想的提示詞:
【任務】
請為我們提出 5 個適合參加大學 AI 專題競賽的題目。

【背景】
我們是 4 位非資訊科系的大一生,製作時間為 8 週。
成員會使用 ChatGPT、Google 表單與 Canva,但沒有完整的網站開發經驗。
我們希望解決校園生活或學習效率中的真實問題,最後需要進行 5 分鐘現場展示。

【限制】
1. 優先使用免費或具有免費方案的工具。
2. 不自行訓練大型語言模型。
3. 不蒐集姓名、電話、病歷等敏感個人資料。
4. 題目必須能在 8 週內做出可操作的 MVP。
5. AI 必須負責一個明確且可說明的核心任務,不能只是裝飾。
6. 如果需要外部資料,請說明資料可能來自哪裡,不要捏造資料集名稱。

【輸出格式】
請使用 Markdown 表格,欄位包含:
- 題目名稱
- 目標使用者
- 真實痛點
- AI 的核心作用
- 所需資料
- 8 週 MVP
- 免費工具選擇
- 主要風險

【驗收方式】
請再依下列項目各以 0~2 分評分:
- 問題明確度
- 可行性
- AI 必要性
- 資料可得性
- 展示效果

依總分排序,詳細說明前 2 名值得繼續發展的原因。
若資訊不足,請先提出最多 3 個必要問題,不要自行假設。
這份提示詞不只適用於 ChatGPT,也可以放進其他支援文字對話的生成式 AI。不同模型的輸出仍可能不同,因此不要只執行一次就直接採用。
提示詞不需要一次就寫到完美,可以採用三輪流程。
先使用完整提示詞產生五個構想。
請不要新增題目。以嚴格競賽評審的角度,找出前兩名構想最可能失敗的原因。

請分別檢查:
1. 問題是否真的存在
2. AI 是否不可取代
3. 資料是否取得得到
4. 八週內是否做得完
5. 現場展示可能發生什麼問題

對無法確認的事項標示「需要查證」。
根據上一輪找出的風險,修改前兩名構想。

請保留原本要解決的核心問題,只調整:
- 功能範圍
- 資料來源
- AI 任務
- MVP 驗收方法

最後列出修改前後的差異。
這種「產生、批評、修改」的流程,比一直輸入「再專業一點」「再有創意一點」更容易得到可用成果。
你是世界上最強的 AI 專家,幫我想一個一定會得獎的題目。
問題在於「最強」「一定得獎」都無法驗收,也沒有提供團隊條件。
角色可以保留,但必須搭配背景、限制與成功標準。
如果希望 AI 分析問卷,至少要提供:
不要只說:
幫我分析學生對 AI 的看法。
否則 AI 可能只會產生一般性的推測。
AI 可以依評分表檢查答案,但不能取代真實使用者。
如果 AI 說「學生一定會喜歡」,仍然需要:
AI 的評分適合用來篩選構想,不代表市場或使用者已經驗證。
第一次結果不好時,不要把整份提示詞全部重寫。
可以一次只修改一個變因:
每次保留結果,才能知道是哪一項修改真正改善了答案。這和做實驗時一次只改一個變因的概念相同。
請選擇一個你最近真的想請 AI 完成的任務,例如:
接著完成以下步驟:
今天的完成條件不是「AI 回答很多」,而是你能明確說出:
哪些條件讓答案變得更可用?
好的提示詞通常具備五個部分:
提示詞不是一次性的神奇句子,而是一份可以測試、比較與持續改善的任務規格。
當提示詞能被驗收,我們才有辦法把 AI 從「聊天工具」逐步變成專題中的可靠工作流程。
Day 4,我們將把 AI 找到的網頁、PDF、影片與筆記整理成「專題資料庫」,建立不再到處複製貼上的資料管理方法。
以上官方文件皆於 2026 年 9 月 17 日查閱。各平台功能與可用額度可能調整,請以官方最新說明為準。


 iThome鐵人賽
 看影片追技術