
當我們要處理一封客戶來信並建立客服工單時,整個流程包含兩項不同性質的工作:先由 AI 理解信件內容並整理出結構化事實,再由程式呼叫工單系統 API 完成建單。
如果把這兩件事全部寫在同一個節點,不僅職責混在一起,當 API 呼叫失敗時也無法單獨重試。
本篇我們要將這項任務拆成多個專注的處理節點(Node):第一個節點由模型專注抽取事實,第二個節點由純程式呼叫外部工單 API,並用自訂 State 在節點之間傳遞資料。
本篇對應的範例程式位於 ai-agent-sample/langgraph/langgraph-review-workflow。
假設客戶寄來了一封包含多個問題與訴求的來信:
您好,我在上週三訂購了一件外套(訂單編號:#ORD-8821)。
原本預期三天內送達,但今天才收到包裹。
打開檢查時發現外套拉鍊卡死無法正常使用,似乎有瑕疵。

由於我明天有出差行程急需使用,剛才撥打客服專線暫時無人接聽,
希望能協助盡快確認並辦理全額退款,謝謝。
要處理這封信,在 LangGraph 架構中會拆分成兩個獨立的 Node(節點):
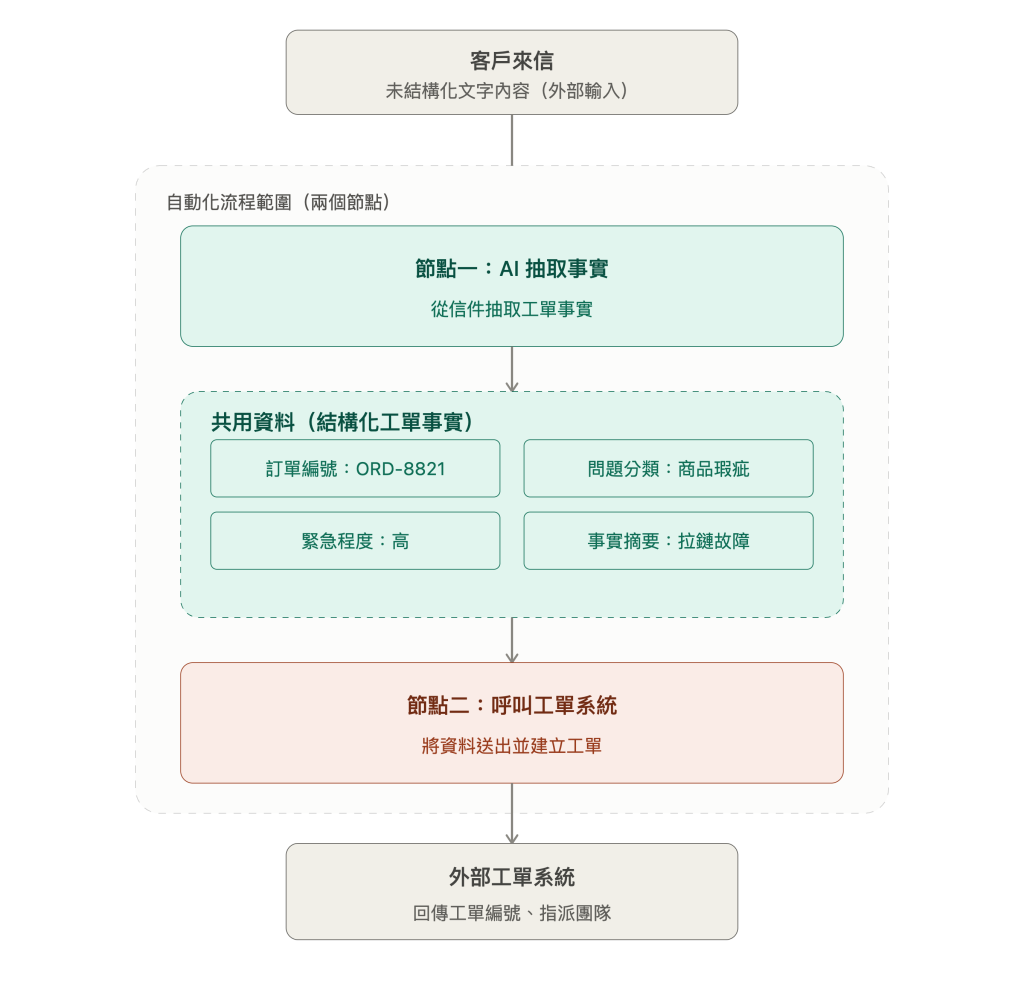
extract_ticket,AI 模型節點):專注從非結構化信件中,抽取出客觀的結構化工單事實(訂單編號、問題分類、緊急程度與事實摘要)。create_dispatch_ticket,外部 API 節點):不呼叫模型,將整理好的結構化資料發送給外部工單系統 API(例如 Jira 或 Zendesk),完成建單並取得回傳的工單編號與指派團隊。在 LangGraph 中,每個節點(Node)本質上就是一個普通的 Python 函式。所有節點函式都遵守相同的簽章規則:
state 字典。這是一個負責呼叫 AI 模型的 Python 函式。它從傳入的 state 讀取 raw_email,呼叫模型將長信整理為結構化 JSON,最後回傳包含抽取事實的字典:
import json
from langchain_core.messages import AIMessage, HumanMessage, SystemMessage

def extract_ticket(state: State) -> StateUpdate:
    response = model.invoke(
        [
            SystemMessage(
                content=(
                    "你負責從客戶來信中提取客觀事實,輸出 JSON 格式包含四個欄位:\n"
                    "- order_id (字串)\n"
                    "- issue_type (字串,如:物流延遲、商品瑕疵)\n"
                    "- priority (字串,高/中/低)\n"
                    "- facts_summary (字串,客觀事實摘要)\n"
                    "只輸出 JSON 字串,不要加 markdown 標記或多餘文字。"
                )
            ),
            HumanMessage(content=state["raw_email"]),
        ]
    )
    if not isinstance(response, AIMessage):
        raise TypeError("model must return an AIMessage")

    ticket_data = json.loads(response.text.strip())
    return {"ticket_info": ticket_data}
函式回傳 {"ticket_info": ticket_data} 後,LangGraph 會自動將這個 key 寫入中央 State,並沿著連線傳遞給下一個節點。
這是一個普通的 Python 函式,完全不呼叫 AI 模型。它從 state 讀取前一步整理好的 ticket_info,模擬呼叫工單系統 API 建立工單,最後回傳包含工單編號與指派團隊的訊息:
def create_dispatch_ticket(state: State) -> StateUpdate:
    ticket = state["ticket_info"]
    if ticket is None:
        raise ValueError("ticket_info 必須在 create_dispatch_ticket 前完成抽取")

    issue_type = ticket.get("issue_type", "")
    if "瑕疵" in issue_type or "拉鍊" in issue_type:
        team = "品管檢驗組"
    elif "延遲" in issue_type or "物流" in issue_type:
        team = "物流與倉儲組"
    else:
        team = "綜合客服組"

    # 模擬呼叫外部工單系統 API 建立工單並取得回傳編號
    raw_order = ticket.get("order_id", "0000").replace("#", "")
    ticket_id = f"TICKET-2026-{raw_order}"

    return {
        "dispatched_ticket_id": ticket_id,
        "assigned_team": team,
    }
這個節點清楚展示了 LangGraph 的擴充彈性:節點不一定要執行 AI 模型,也可以是資料庫寫入、呼叫外部 REST API 或觸發訊息通知。
在這條流程中,節點之間要交換資料,必須先定義全圖共用的資料規格。這份規格在 LangGraph 稱為 State,它定義了 Node 可以讀取與更新哪些欄位。
第一個 Node 需要從長信中抽取結構化的工單事實,我們用 TicketInfo 定義抽取的目標欄位;接著,再將呼叫端的原始輸入與各步驟的產物組合成整張圖的 State:
from typing import TypedDict

class TicketInfo(TypedDict):
    order_id: str
    issue_type: str
    priority: str
    facts_summary: str


class State(TypedDict):
    # 呼叫端填入:客戶原始長信
    raw_email: str

    # 第一步填入:抽取的結構化工單事實
    ticket_info: TicketInfo | None

    # 第二步填入:外部工單系統回傳的建立結果
    dispatched_ticket_id: str | None
    assigned_team: str | None


# Node 回傳型別:只包含要更新的局部欄位
class StateUpdate(TypedDict, total=False):
    ticket_info: TicketInfo
    dispatched_ticket_id: str
    assigned_team: str
TypedDict 提供靜態型別資訊,讓編輯器與型別檢查工具知道每個欄位的型別。它不會在執行時驗證資料,也不負責合併或保存 State;Node 回傳值如何套用到 State,是 StateGraph 的執行機制。
extract_ticket 與 create_dispatch_ticket 不會直接呼叫彼此。在 LangGraph 中,節點之間的資料交接是透過局部更新(Partial Update)完成的:
每個 Node 都不需要回傳整個 State,只需要回傳自己要更新的欄位。 LangGraph 會自動將回傳的新值合併回全圖的 State,再把更新後的 State 傳給下一個 Node。
整個流程中,State 字典的變化如下:
{
    "raw_email": "您好,我在上週三訂購了一件外套……",
    "ticket_info": None,
    "dispatched_ticket_id": None,
    "assigned_team": None,
}
extract_ticket)執行後:回傳 {"ticket_info": ticket_data},LangGraph 將它合併進 State,沒有出現在回傳值裡的欄位保留原值:{
"raw_email": "您好,我在上週三訂購了一件外套……",
"ticket_info": {
"order_id": "#ORD-8821",
"issue_type": "物流延遲、商品瑕疵",
"priority": "高",
"facts_summary": "下單後超過約定三天未送達;收件後外套拉鍊故障卡死無法使用,客戶有緊急出國時效需求。",
},
"dispatched_ticket_id": None,
"assigned_team": None,
}
create_dispatch_ticket)執行後:直接從 state["ticket_info"] 讀取抽取事實,建單後回傳工單編號與指派團隊,最終 State 變成:{
"raw_email": "您好,我在上週三訂購了一件外套……",
"ticket_info": {
"order_id": "#ORD-8821",
"issue_type": "物流延遲、商品瑕疵",
"priority": "高",
"facts_summary": "下單後超過約定三天未送達;收件後外套拉鍊故障卡死無法使用,客戶有緊急出國時效需求。",
},
"dispatched_ticket_id": "TICKET-2026-ORD-8821",
"assigned_team": "品管檢驗組",
}
流程結束後,呼叫端就能直接從最終 State 取得每個步驟的產出。
當 Node 回傳某個 State 欄位的新值時,LangGraph 必須決定如何處理該欄位目前的值。
例如,State 原本尚未指定處理團隊:
{"assigned_team": None}
create_dispatch_ticket 回傳:
{"assigned_team": "品管檢驗組"}
這個欄位只需要保留最新結果,因此 LangGraph 用新值覆蓋舊值:
{"assigned_team": "品管檢驗組"}
對話紀錄需要不同的更新方式。假設 messages 已經包含兩則訊息:
[
    HumanMessage("你好"),
    AIMessage("您好"),
]
下一輪加入一則使用者訊息時,不能用新串列覆蓋舊串列,否則前兩則對話會消失。MessagesState 內建的 add_messages 會將新訊息合併進原有紀錄:
[
    HumanMessage("你好"),
    AIMessage("您好"),
    HumanMessage("我要查訂單"),
]
LangGraph 將這項「如何把目前值與 Node 回傳的新值組成下一個值」的規則稱為 Reducer:
這個工單流程的每項產物都只需要一個最新值,使用預設覆蓋規則即可。當某個欄位需要持續累加多次更新時,才需要另外定義 Reducer。
定義好 State 與節點函式後,我們使用 StateGraph 組裝成固定路徑的圖:
from langgraph.graph import END, START, StateGraph


def build_graph(model):
    # 建立 StateGraph 並傳入自訂 State 型別
    builder = StateGraph(State)

    # 1. 註冊節點
    builder.add_node("extract_ticket", extract_ticket)
    builder.add_node("create_dispatch_ticket", create_dispatch_ticket)

    # 2. 連接固定執行路徑
    builder.add_edge(START, "extract_ticket")
    builder.add_edge("extract_ticket", "create_dispatch_ticket")
    builder.add_edge("create_dispatch_ticket", END)

    return builder.compile()
呼叫端傳入初始資料並執行:
graph = build_graph(model)
result = graph.invoke(create_initial_state(CUSTOMER_EMAIL))

# 從最終 State 中取得各步驟產物
print("【工單結構化資料】", result["ticket_info"])
print("【外部工單編號】", result["dispatched_ticket_id"])
print("【指派處理團隊】", result["assigned_team"])
執行結束後,回傳的 result 包含完整的 State 。呼叫端可以直接確認工單編號與指派結果。
最後,小結一下。將資料抽取與 API 呼叫拆成兩個 Node,並用固定 Edge 串接,為系統建立了清楚的責任與重試邊界:
ticket_info 是 State 的明確欄位,呼叫端與測試可以直接驗證抽取結果,不需從 API 請求或最終輸出反推。START → extract_ticket → create_dispatch_ticket → END)由程式寫死順序,可確保建單行為百分之百觸發,避免模型漏發 Tool Call 或改寫參數。但如果外部服務不是每次都必須執行,而是需要由 AI 模型依據對話當下來自主判斷是否呼叫呢?
在下一篇 [[讓 LangGraph Agent 使用工具查詢外部資料]] 中,我們將把決定權交給模型,學習如何透過條件邊(tools_condition)與 ToolNode,建立具備動態決策能力的 Agent Loop。


 iThome鐵人賽
 看影片追技術