
在 Day 10 中,我們用「運費比率」量化了偏遠地區買家的物流負擔。但商業常識告訴我們:買家願意付款結帳,代表運費再貴他都已經「知情且默許」。
真正會讓買家留下極端差評(1 星負評)的,通常不是預期內的成本,而是「預期的落差」也就是平台答應了預計送達日,包裹卻遲遲沒出現。
今天我們將引入全新的顧客評價表 (order_reviews),
透過時間特徵工程計算「實際配送天數」與「延遲天數」,用數據量化物流跳票對顧客滿意度的毀滅性打擊。
我們先從資料字典中取出 olist_order_reviews_dataset:
# 從字典中取出評價表
reviews = olist_db['olist_order_reviews_dataset']

# 檢視欄位資訊
reviews[['review_id', 'order_id', 'review_score', 'review_creation_date']].head(3)
如圖:
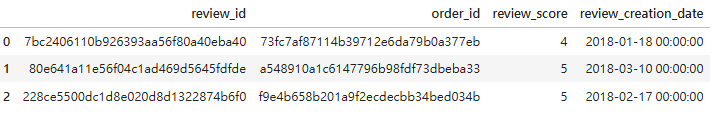
在進行跨表合併前,老手的防呆雷達必須立刻啟動:一張訂單只會有一則評價嗎?
# 檢查是否有同一張 order_id 對應多筆 review 的情況
duplicate_reviews = reviews['order_id'].duplicated().sum()
print(f"重複評論的訂單數: {duplicate_reviews} 筆")
如圖 :
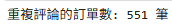
執行後會發現有數百筆訂單存在多次評價(可能買家更新了評論)。
如果直接 Merge,資料粒度又會被悄悄拉膨脹!
我們在合併前先按評論時間保留最新的一筆:
# 依據 review_creation_date 排序,只保留每筆訂單最新的評價
clean_reviews = reviews.sort_values('review_creation_date').drop_duplicates(
    subset='order_id',
    keep='last'
)

# 合併回我們的有效訂單主表
orders_with_reviews = pd.merge(
    valid_orders,
    clean_reviews[['order_id', 'review_score']],
    on='order_id',
    how='inner'
)

print(f"成功合併評價的訂單數: {len(orders_with_reviews):,} 筆")
如圖:

我們需要從時間戳記中衍生出兩個關鍵的行為指標:
# 1. 實際配送耗時(換算為天數)
orders_with_reviews['actual_delivery_days'] = (
    orders_with_reviews['order_delivered_customer_date'] - orders_with_reviews['order_purchase_timestamp']
).dt.total_seconds() / (24 * 3600)

# 2. 延遲落差(大於 0 代表遲到,小於等於 0 代表提早或準時送達)
orders_with_reviews['delay_days'] = (
    orders_with_reviews['order_delivered_customer_date'] - orders_with_reviews['order_estimated_delivery_date']
).dt.total_seconds() / (24 * 3600)

# 3. 建立二元標記:是否延遲交付?
orders_with_reviews['is_delayed'] = orders_with_reviews['delay_days'] > 0

orders_with_reviews[['order_id', 'actual_delivery_days', 'delay_days', 'is_delayed', 'review_score']].head(3)
實作 :
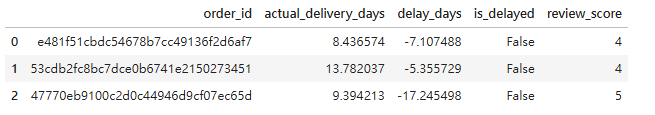
實際配送天數 (actual_delivery_days): 送達顧客時間 - 下單購買時間
延遲天數 (delay_days): 送達顧客時間 - 官方預估送達時間
有了標籤後,我們馬上比較「準時履約」與「延遲履約」的顧客評分差異:
# 依是否延遲分組,計算平均評分與單量佔比
delay_impact = orders_with_reviews.groupby('is_delayed').agg(
    order_count=('order_id', 'count'),
    avg_score=('review_score', 'mean')
).reset_index()

delay_impact['share_pct'] = (delay_impact['order_count'] / delay_impact['order_count'].sum() * 100).round(2)
delay_impact['avg_score'] = delay_impact['avg_score'].round(2)
delay_impact
實作 :
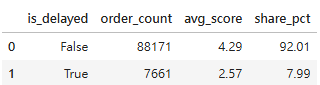
數據對比:
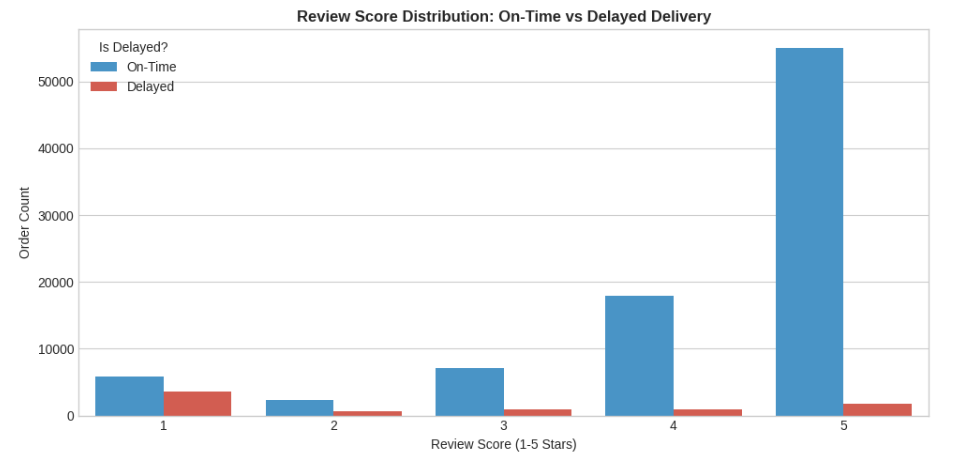
延遲訂單雖然只佔整體約 7%~10%,但它幾乎直接宣判了這批顧客的流失。
買家對「平台食言」的容忍度幾乎為零。
我們透過堆疊長條圖(Barplot)直接觀察評分結構的變化:
import matplotlib.pyplot as plt
import seaborn as sns

plt.figure(figsize=(10, 5))
sns.countplot(
    data=orders_with_reviews,
    x='review_score',
    hue='is_delayed',
    palette=['#3498db', '#e74c3c']
)

plt.title('Review Score Distribution: On-Time vs Delayed Delivery', fontsize=12, fontweight='bold')
plt.xlabel('Review Score (1-5 Stars)')
plt.ylabel('Order Count')
plt.legend(title='Is Delayed?', labels=['On-Time', 'Delayed'])
plt.tight_layout()
plt.show()
實作 :
今天打通了物流與客戶體驗的數據孤島:
識破多對一評論: 在 Join 前先進行 order_id 去重,捍衛資料粒度。
提煉體驗指標: 用時間差衍生出 delay_days 與 is_delayed,量化履約承諾。
定位體驗斷崖: 證實了延遲是直接造成 1 星負評的核心原因,為營運團隊提供了改善滿意度的明確抓手。
我們現在清楚知道了「時效跳票」對評分的殺傷力。
那麼,到底哪一種類型的商品最常延遲?
或者是哪種商品即使準時到了,依然常常拿差評?
明天 Day 12,我們將跨入「品類維度 (Product Category)」,找出產品本身的潛在地雷!


 iThome鐵人賽
 看影片追技術