
利用Pandas進行全欄位資料健康檢查,排查有無缺失值(NaN)、確認資料型態(dtypes),並透過描述性統計檢驗數值合理性。
一、實作前情境:為什麼不能直接開始畫圖?
昨天雖然順利把 digital_eye_strain_students_professionals.csv 讀進Colab並看過前5筆,但實務上資料不能只看表象。
如果資料集暗藏「缺漏值(NaN)」、「數值被存成字串(例如數字混到空白或英文字母)」或是「邏輯不合理的數值(例如每日螢幕時長 28 小時、年齡負數)」,後面直接套用Seaborn畫圖或算統計量時一定會報錯,甚至得出錯誤的結論。
因此,今天要在同一個 Colab 筆記本中建立 Day 4 的單元格,進行標準的「資料健康度三道關卡檢查」。
二、資料型態與非空值檢查(df.info())
在 Day3的程式碼下方,新增一個程式碼儲存格執行:
# 1. 檢視資料基本結構、欄位型態與非空值計數
print("=== 資料集基本結構檢查 ===")
df.info()
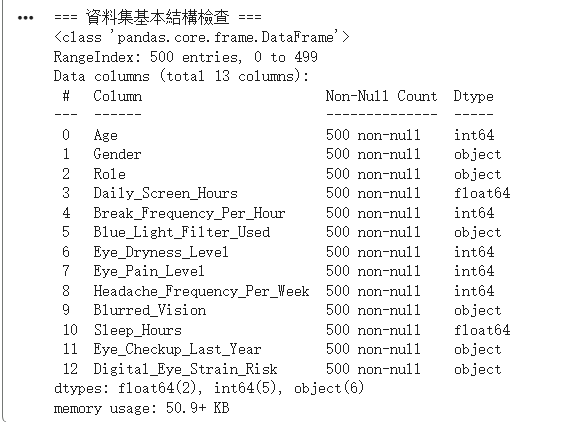
三、缺失值精確統計(isnull().sum())
為了百分之百確認沒有隱藏的空值,執行缺失值累加統計:
# 2. 統計每個欄位的缺失值(NaN)數量
missing_values = df.isnull().sum()
print("=== 各欄位缺失值統計 ===")
print(missing_values)

# 計算整體缺失率
total_missing = missing_values.sum()
print(f"\n總計缺失值個數: {total_missing} 個")
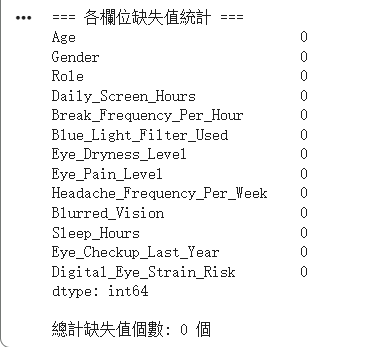
檢查心得:
輸出結果整齊地顯示每個欄位的缺失數量全部都是0。
這代表這份資料集在被作者整合或生成時,已經做過基本的完整性過濾,不需要在初期執行 dropna()或 fillna()等繁瑣的補值步驟,這對初學者來說大幅降低了踩坑門檻。
四、數值合理性與極值檢驗(df.describe())
即便沒有空值,也不代表數值是合乎邏輯的。接下來使用 df.describe() 檢視數值欄位的五數綜合摘要(最小值、最大值、四分位數、平均值、標準差):
# 3.檢視數值欄位的統計摘要(四捨五入到小數點後兩位)
df.describe().round(2)
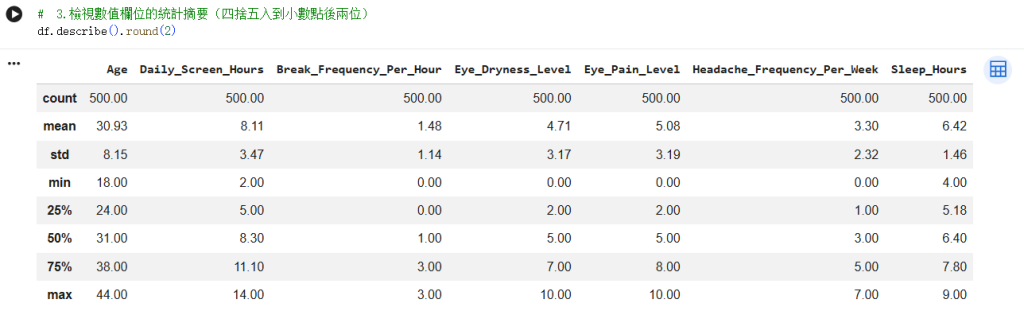
1.年齡 (Age):
2.每日螢幕時數 (Daily_Screen_Hours):
3.每小時休息次數 (Break_Frequency_Per_Hour):
4.眼部症狀評分 (Eye_Dryness_Level 與 Eye_Pain_Level):
5.每週頭痛頻率 (Headache_Frequency_Per_Week):
6.睡眠時間 (Sleep_Hours):


 iThome鐵人賽
 看影片追技術