

月會快結束的時候,稽核小組的一位資深護理師講了這句話。
那時候,AI 跑出來的疑似缺失清單已經每個月發下去複核了半年——Day 9 那次全量之後就沒停過。清單很長,小組能挪的時間卻固定:每人每月大概半天,半天認真看完三十份已經是極限。
她說的不是抱怨,是一個很準確的觀察:那三十份裡,有二十四份是在確認「這份沒問題」。
那是全院最懂病歷品質的幾雙眼睛之一。我們讓它花了一個下午,去證明二十四份文件沒事。
同一場會上,另一位委員問了一個看起來相反的問題:「那 AI 說沒問題的那幾百份,我們就都不看了嗎?」
兩個問題其實是同一個。專家時間是這套系統裡最貴、也最不可能擴充的那一項資源,而我當時給不出一個站得住的答案。不是答不出「該看幾份」——小組早已在流程裡訂了數字。答不出的是憑什麼是那個數字。
後來才想通,這件事我不必自己發明:「一批東西該檢多少」,有一整個產業做了幾十年。
這幾年開會,只要簡報上出現 AI,一定會有一頁寫著 human in the loop。那一頁通常是一個人形圖示站在流程圖中間,底下一行小字「人工審核」,然後就沒有下文了——沒寫審幾成、沒寫審完誰簽名、也沒寫審核紀錄要不要留 log。
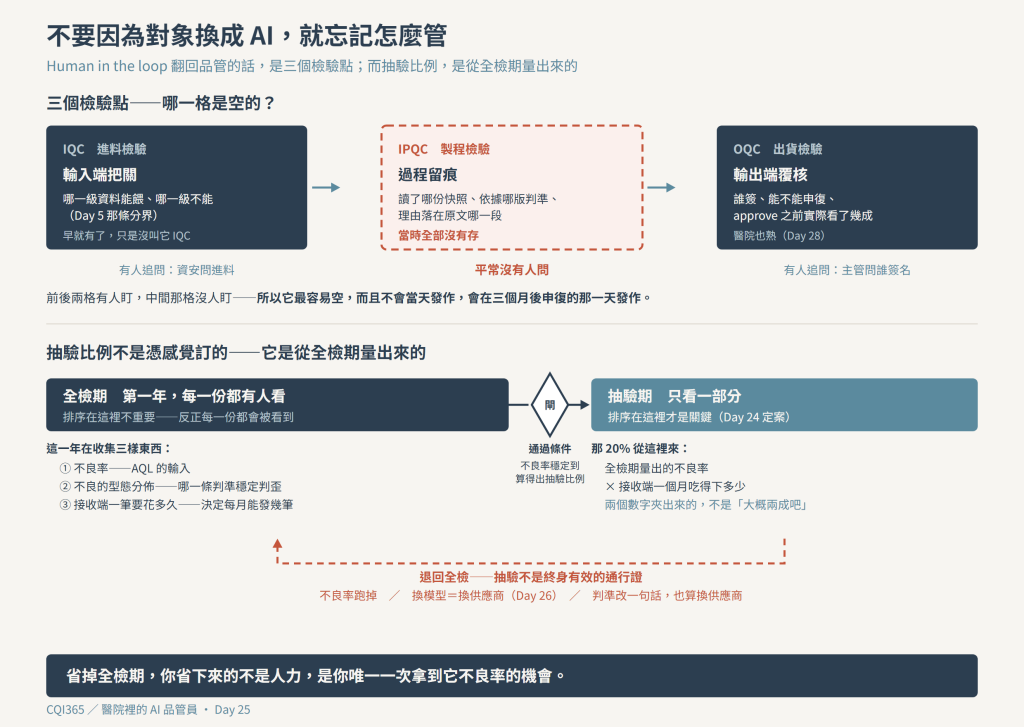
這個詞不新。翻回品管的話,它就是製造業做了半世紀的三個檢驗點——只是這一次,那條線上站的不是機台,是一個語言模型。
| 早就在做的 | 過去的對象 | 換成 AI |
|---|---|---|
| IQC 進料檢驗 | 來料合不合格 | 輸入端把關:哪些資料能餵、哪些不能 |
| IPQC 製程檢驗 | 過程有沒有跑掉 | 過程留痕:它讀了什麼、依據什麼、做了哪幾步 |
| OQC 出貨檢驗 | 出去的東西能不能見人 | 輸出端覆核:誰簽、抽驗比例多少 |
IQC 那一格我們早就有了,只是沒叫它 IQC。 進料規範在這裡就是資料分級——哪一級可以走雲端、哪一級只准留在院內(Day 5 那條分界)。你的服務本來就會在入口擋掉不合規格的輸入,只是我的 schema 不是欄位型別,是敏感度:一段真實的護理紀錄不是「格式錯誤」,它是不該進到這條產線上的來料。
OQC 那一格,醫院也熟。 稽核判定要有人簽名、要能被申復、要說得出理由(Day 28 整篇談這個)。翻成你們的語言就是誰按 approve,以及——重點在這裡——approve 之前實際看了幾成。
空掉的是中間那一格。 品管與資訊一起盤點這條流程時:IQC 有、OQC 有,IPQC 幾乎是空的。模型讀了哪一份快照、依據哪一版判準、理由落在原文哪一段,當時全部沒有存。這個缺口不會當天發作,它會在三個月後單位主管來申復的那一天發作。而它最容易空,因為前後兩格有人追問——資安問進料、主管問誰簽名——中間那格平常沒人問。
這是你明天上班就可以做的一件事:把你手上那條 AI 流程對著這三格盤一次,看哪一格是空的。
回到那位委員的問題:AI 說沒問題的那幾百份,要不要看。
「要檢多少」這件事,在品管有一個標準答案的形狀,叫 AQL——允收品質水準。邏輯大致是這樣:
第一年 100% 全檢——AI 出的每一份都有人看過。跑三個月、六個月,它的不良率你就有數字了,這時候才降到抽驗。
順序不能倒過來。你不能先訂一個「抽兩成」,再回頭證明兩成夠。抽驗比例是從不良率算出來的,而不良率只有一個地方來得到:一段你什麼都不敢省的全檢期。
這件事你們有一個沒寫成制度的版本:新服務上線頭幾個月大家會盯著看,過一陣子就不盯了。差別是我們連「什麼時候可以不盯」都寫下來,而且寫成一個要拿數字去對的條件。
所以那個我答不出來的問題,有一個很不浪漫的答案:因為我還沒跑完全檢期,根本還沒有資格降到抽驗。
而我當時已經在抽驗了。
把第一年全檢講成「先辛苦一年」是錯的理解。那一年的產出不是「每一份都被看過」,是三樣後面全部要用的東西:
一、不良率。 AQL 的輸入。沒有它,往後每一個抽驗比例都是憑感覺。
二、不良的型態分佈。 比不良率有用得多。AI 是不是穩定地在同一類情境上判歪,只有把複核結果按判準條目拆開才看得出來——這一條的成立率很難看、那一條完全沒問題,而總體的數字會把兩者攪成一個沒有意義的平均。Day 24 講的逐規則追蹤,資料就從這裡來。
三、接收端一筆要花多久。 一位委員複核一筆平均花多少時間,決定之後每個月能發幾筆出去。它跟你估一條 pipeline 的吞吐是同一種數字:先量單筆成本,才有資格決定一批發多少。它是設計輸入,不是驗收結果。
第二樣靠一個欄位撐著,值得單獨講。
複核者按下「這不是問題」之後,要出現兩個欄位:
只留分類,你會得到一份很整齊、卻看不出下一步該改什麼的統計;只留自由欄,你會得到幾百則讀到第四十則就開始失焦的文字。兩格都要,而且必選的那格不能是自由欄——不然三個月後,你手上沒有任何一個畫得上 dashboard 的東西。
有一位同仁把 Day 24 和這一篇的規則擺在一起,問我為什麼對不上:一邊說清單要排序、每個月只發前 N 筆,一邊說第一年每一份都要有人看——到底是全看還是只看一部分?
我愣了一下才反應過來。那不是兩套互相打架的規則,是兩個階段。
| 全檢期 | 抽驗期 | |
|---|---|---|
| 看多少 | 全部 | 由不良率算出的比例 |
| 排序重不重要 | 不重要——反正每一份都會被看到 | 關鍵——沒被排進去的那些不會有人看 |
| 什麼時候結束 | 不良率穩定到算得出抽驗比例 | 不良率跑掉就退回全檢 |
排序是抽驗期才存在的問題。而抽驗期怎麼排,Day 24 已經定案:由接收端這個月吃得下幾筆決定 N,由外部資訊排序——這類問題的歷史成立率、病人的風險等級、這個單位本月已收到幾筆,全部是模型看不到的東西。
那 20% 就是這樣來的。它不是我看著清單覺得「大概兩成吧」,是全檢期量出來的不良率,加上接收端一個月吃得下多少,兩個數字夾出來的。
表的最後一行也要寫進制度:不良率跑掉就退回全檢。 抽驗不是終身有效的通行證——來料出問題,那家供應商就從免驗打回全檢。而模型換版就是一次換供應商(Day 26):同一段判準、同一批病歷,換掉 API 背後的東西,行為不保證一樣。判準自己改一句話,也算換供應商。
「抽驗」不是一件事,是三件用途完全不同的事。我踩過的坑是把三種塞進同一批樣本,三個問題一個都沒答好。
從全部輸出裡隨機抽,AI 不參與挑選。這是唯一一批沒有被 AI 挑過的樣本,也是唯一一批人跟機器看過同一份病歷、可以拿來當 ground truth 的資料。所以:
報表上的缺失率,永遠只准用這一批算。
這條規則在會議桌上很難擋,因為「我們複核了三百筆,其中一百二十筆有問題」聽起來就是一個數字,沒有人會自動想到那三百筆是 AI 挑出來的、本來就富集了問題。拿它報缺失率,那個數字會隨著模型每次調整上上下下——你以為在看品質,其實在看模型的脾氣。
這一批也是唯一「人跟機器讀過同一份病歷」的資料,AI 到底表現如何只有這裡量得出來。
但它不是這套系統的健康檢查。 這點我必須講清楚,因為我自己弄混過。
Day 9 就算過那筆帳:想用隨機抽驗去抓偽陰性——AI 判「沒問題」但其實有問題的那些——效率極差。判符合的那堆基數太大、真的有問題的比例太低,抽幾十筆可能一筆都沒抓到。這跟你要證明自己的 alert 沒漏報是同一個死結:沒觸發的事件裡抽不出漏報。所以 Day 9 就說了得換方法,而換掉的那個方法就是 Day 22 的陷阱池。
所以這兩件事的分工要寫清楚,不能互相頂替:
隨機抽驗量的是不良率,陷阱池量的是偵測能力。前者是抽樣,後者是 regression test。
AQL 本來就有加嚴檢驗這一級:某些項目不管整批表現多好,都要按固定比例抽。
哪些條目漏掉會真的傷到病人,是品管累積幾十年的既有知識,跟模型無關。這是整套抽驗規則裡唯一由人給的先驗,而且它壓過其他所有訊號:高風險項目就算三個模型都說沒問題,還是要抽出來給人看。
理由是代價不對稱。多看十份沒問題的病歷,成本是一個下午;漏掉一個高風險缺失,成本是一件本來不該發生的事。這種不對稱不該交給模型分數去權衡,它應該寫死在抽驗規則裡,而且要進版本控——那是整條流程裡最不該被誰在某個趕時間的下午順手調掉的一行。
Day 23 講過那個分工:造題的、設計判準的、打分數的,不能是同一批。打分數的那三個並排跑、互不知情(Day 20 那套做法),拿到的東西剛好可以當抽驗訊號:三個判不一樣的那幾份病歷,一定送人看。
分歧的好處是它不依賴模型的自我評估,是從外面量到的。你的 CI 裡有同樣的結構:兩個獨立的檢查同時指著同一行,權重跟只有一個在叫完全不同。
但它有一個盲點必須講清楚,這是本篇最重要的一條負面規則:
分歧小不代表答案對,只代表三個都覺得這題容易。
它們共享的訓練分佈,會讓它們對同一類案例同時失準——三個一起錯,而且錯得很整齊。Day 20 那三位資深評審把同一份圈報告一起看偏過,換成三個模型一樣會發生。所以「一致就不用看」絕對不能寫進系統;加嚴抽驗存在的理由有一半就是擋住它。
至於模型自己說的把握程度——Day 24 已經把它判出局了:把握程度是模型的內部狀態,值不值得看是接收端的成本問題,這兩件事本來就不該由同一個欄位回答。
但它不是沒用,是位置錯了。它不該站在 OQC 那一格當分派依據,它屬於 IPQC——它該進 log,不該進佇列:等單位主管來申復、要回頭查「這一份病歷當初為什麼判成這樣」的時候,它是一條線索。
一個訊號有沒有用,跟它該站在哪一格,是兩個問題。 我把它放在錯的那一格。
不要因為對象換成 AI,就忘記怎麼管。
進料要驗、過程要留痕、出貨要抽檢。前兩件你的 CI 裡本來就有;第三件多半是空的——沒人規定一份 AI 產出上線前要抽驗幾成,更沒人規定那個比例該怎麼算。
那 20% 一直都在。過去它散在每個月幾千份出院病歷裡,我們用隨機抽樣去碰運氣,碰到多少算多少。現在能做的,是先把不良率老老實實量出來,然後才有資格說「只看兩成」。
所以如果只能保住一件事,我會保住第一年那個全檢:
省掉全檢期,你省下來的不是人力,是你唯一一次拿到它不良率的機會。


 iThome鐵人賽
 看影片追技術