

季報表出來,7B 病房的病歷品質缺失率跳上去了。陳護理長來品管室,話講得很客氣,但意思很清楚:
「我們沒有改任何東西,為什麼分數會變。」
品管團隊回查歷次報表,7B 病房協助確認人員與流程沒有變動,資訊同仁核對那一季的表單與版本紀錄。稽核小組再抽閱幾份電子病歷,內容和前幾個月看不出明顯差別。
對照版本紀錄後才發現:那一季的中間,我們把跑判定的模型換了版本。換的理由現在已經不重要,重點是我們照排程換掉了,而且那天沒有人覺得這是一件需要驗證的事。
換版當天,系統沒有壞。輸出格式正常,每一筆的理由都寫得好好的。上線後第一批結果我也看過幾筆,沒有一筆讓我覺得不對。
因為沒有任何一筆是錯的。錯的是那把尺。
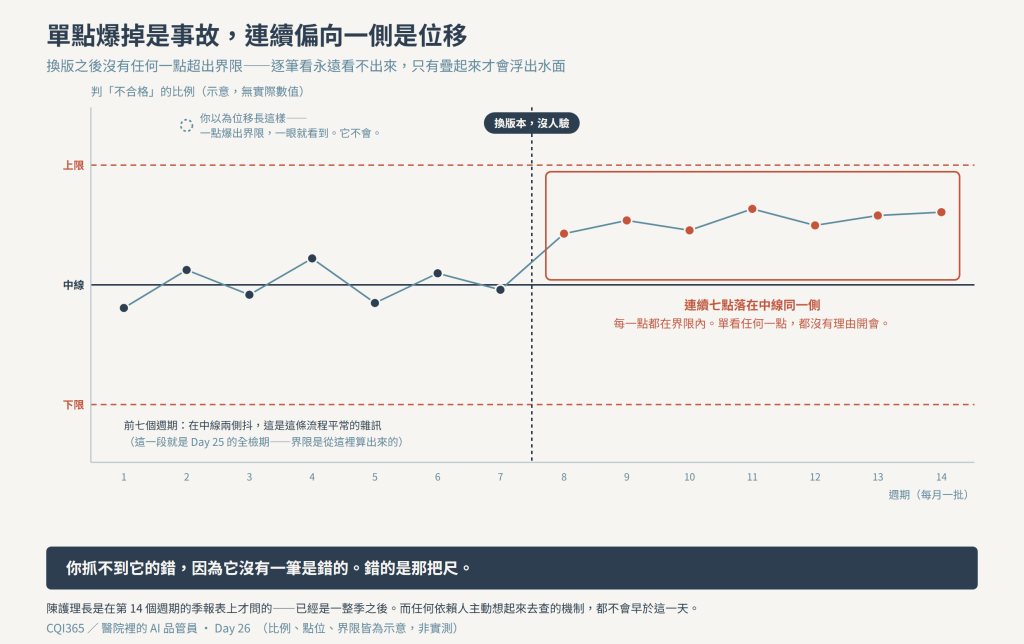
新版比舊版嚴格一點。就一點。逐筆看永遠看不出來,只有把幾百筆疊起來,那個位移才會浮出水面。
陳護理長提出疑問後,我們才想到要把不同批次的判定分布放在一起比。
這個問題不是 AI 帶來的。管制圖回答的就是它,而且回答了快一百年。
我不打算在這裡講管制圖怎麼畫——那是任何一本品管教科書的第三章。只留三句你等一下會用到的:
第三句是這一篇的全部。單點爆掉是事故,連續偏向一側是位移。
而位移,就是模型換版之後會發生的事。
要把管制圖搬到 AI 上面,先得承認一件事:一個每個月固定跑一次的 AI 判定流程,就是一條生產線。 它有輸入、有產出、有變異。
但要接上去,有個很硬的問題:管制圖需要一個可以連續量測的量。
工廠量的是尺寸、重量、扭力。AI 判定的產出是「合格/不合格」加一段中文理由——你要量什麼?
這是這篇最主要的設計工作。我們最後放上管制圖的有四個量,靈敏度跟可信度剛好排成一個梯度。
一、輸出格式的破損率。 欄位缺漏、格式跑掉、理由欄空白、判定值出現不在稽核條目表上的東西。這是最粗的訊號,但也最早——模型端一有變化通常這裡先抖。它跟判斷品質沒有直接關係,但它免費:一個 schema 驗證就跑完了,不需要人。
二、判定分佈。 每一批跑完,各判定等級各佔多少。比例型資料本來就有現成的管制圖可用。只要每個月出院的病歷母體沒有大變,判定比例應該是穩的;它一旦整體往嚴格或寬鬆的某一側移動,就是開頭那件事。
三、固定基準集的前後一致性。 這是四個裡面最乾淨、也最該投資的一個。
準備一組永遠不變的病歷案例,每個週期、每次換版都拿同一組跑一次,量新舊兩次輸出的一致程度。用的工具就是 Day 20 那套評分者間一致性,只是這次的兩個「評分者」是同一套系統的前後兩版。
它最接近你們的 snapshot test:輸入釘死,任何 diff 都只能是被測的東西自己變了。
它乾淨在哪裡:輸入完全固定,任何變化都只能來自模型端。 另外三個量都混著輸入的變化,只有這一個沒有。
四、人工複核的退回率。 這是 Day 25 那個抽驗流程的下游。退回比例開始往上爬,代表 AI 的判斷跟複核委員的判斷正在拉開。
它最有意義,因為它直接量的是「人還同不同意它」。但它也最遲鈍——要等一個複核週期才有數字,而且它自己也會漂:複核者換人、變累、或開始信任 AI 而放鬆標準,都會動到這個數字。
四個量的關係是一個典型的取捨:越早發現的訊號越粗,越準的訊號越晚。 格式破損當天就知道,但它不代表判斷變了;退回率真的代表判斷變了,但你得等一整輪。所以四個都要,不是挑一個。
明天上班就能做的一件事:把你手上那條 AI 流程過去三個月的輸出,按批疊起來,只看一件事——某一類判定的比例有沒有整體往一邊移。 這不需要新工具,一個 group by 就夠了。看不出來很好,那是基線;看得出來,你剛剛替自己省掉一場跟單位主管的對質。
上面第三項有一條規則,比其他所有設計都重要,而且我看過太多團隊在這裡出事:
基準集的結果不可以拿來調判準。
一旦你用它調過,它就從量尺變成了訓練目標。之後它永遠是綠的,而你會以為系統很穩。
這對你們不新鮮,那是 test set leakage。但在這裡它發生得隱蔽得多——調 prompt 不像訓練模型,不像作弊,就是改幾句話而已。你只是想把那三筆判錯的修好,然後那組基準集就死了,而且沒有任何跡象告訴你它死了。
所以要準備的是兩個池子,而且從第一天就要分開,事後補分是分不開的:
| 開發案例池 | 基準集 | |
|---|---|---|
| 用途 | 改判準的時候拿來試 | 量這套系統有沒有漂 |
| 可不可以看結果去改判準 | 可以,它就是為此存在 | 絕對不行 |
| 誰會碰它 | 品管室,每個星期 | 排程,每個週期一次 |
| 換版時 | 不參與決策 | 新舊兩版就跑它 |
| 你們的名字 | dev set | test set |
明天那條把改判準自動化的流程,跑的是左邊那一欄。右邊那一欄從頭到尾只有排程碰得到,連我自己要調它都要有人核准——因為判準的量尺跟判準本身,不能由同一隻手改。
這一條寫進制度的時候,在品質委員會上一定會被問一句「有必要分這麼細嗎」。有。它是這整套監測唯一的地基;地基被動過一次,上面所有的圖都只是裝飾。
回到開頭那個場景。真正的問題不是模型變嚴格了,是我們把換版當成換一個字串。
在一般系統裡這是例行公事,改個設定值的事。但在一套判準寫成自然語言的稽核系統裡,「換一版模型」這句話的意思是:
你的判斷標準要換一把尺,而你不知道新的那把跟舊的差多少。
所以換版應該長成這樣:新舊兩版對同一組基準集各跑一次,比對差異,差異落在管制界限內才換;超出去就先停下來,回頭重新校準 Day 21 那些錨點。
這就是回歸測試,只是斷言不是「輸出要一模一樣」,而是「一致性要落在界限內」。
這也是必須事先跟資訊單位講好的事。他們管的是 API 可用性、成本、供應商時程;品管室管的是判準一致性,兩邊的時程不會自動對上。換版前要留出重跑基準集的時間——這要寫進雙方的協議,不是等通知來了再臨時協調。
這一課我學得晚了,代價是陳護理長白跑一趟品管室。
這是我認為整個系列最值得帶走的失效型態。
我們對 AI 出錯的想像通常是幻覺、胡說、格式壞掉——那些都很好抓,因為它們看起來就不對:不是讓下游的 parser 當場爆掉,就是一眼看出這句話不可能對。
標準位移不是這樣。換版之後的模型不是變笨了,是變得比較嚴格、或比較寬鬆。它每一筆的理由都還是寫得漂亮、引得到病歷原文、說得通。你把任何單獨一筆拿出來檢查,都挑不出毛病。
你抓不到它的錯,因為它沒有一筆是錯的。錯的是那把尺。
這個型態可怕之處在於,它把逐筆抽查整個廢掉了——而逐筆抽查恰好是絕大多數團隊唯一在做的品質確認方式,也是絕大多數 code review 實際上在做的事。
位移只在分佈上看得見。看不見的原因不是它藏得好,是你用錯了解析度。
管制圖有一個必須事先講明的限制:它只告訴你變了,不告訴你為什麼變。
一個判定分佈的位移,至少有三種來源,而它們在圖上長得一模一樣:
| 來源 | 實際發生的事 | 該做的處置 |
|---|---|---|
| 模型端變了 | 換版,或供應商靜默更新 | 重新校準,或先 rollback |
| 輸入端變了 | 真的品質變化,或換了新病歷模板、書寫習慣改了 | 這才是稽核本來要抓的東西 |
| 你自己改了判準 | 上個月為了修某三筆,補了一句話 | 回去看那次到底改了什麼 |
第三種最常發生,也最常被忘記——因為改的人覺得那只是「調一下措辭」。
要分辨這三種,方法只有一個:把其中兩個固定住,才知道第三個變了。 基準集固定住了輸入,所以它能排除第二種。但要排除第三種,你必須知道這一批結果到底是用哪一版判準跑出來的。
而這正是陳護理長坐在對面那天,我答不出來的問題。明天整篇談它。
前面所有的設計,只要它是「想到才跑」,價值就是零。
漂移的性質決定了這一點:它是慢的、連續的、每一筆都合理的。任何依賴人主動想起來去查的機制,都會在漂移面前失效,因為漂移不會給你一個想起來的理由。開頭那個場景裡,團隊是在單位提出疑問後才回查的——那已經是一整季之後。
所以這條流程長這樣:固定週期自動重跑基準集、算一致性、把點畫上管制圖、超界就發訊息給人。人在這裡只剩最後一步——判斷這次超界要不要處理。
這是 Day 1 講的「可觀測」在這套系統上的具體樣子。一個看不見自己何時開始漂的判斷系統,跟一個沒有監控的服務是同一件事:它不是還沒出事,是出事了你不會知道。
管制圖需要一段穩定期的歷史,才算得出界限。而一套剛上線的 AI 判定流程,沒有歷史。
這沒有捷徑:前幾個週期不是在監測,是在建立基線。 這段期間的界限是暫定的,會抖、會誤報。這跟 Day 25 那個全檢期是同一段時間、同一個理由——你在量這條流程自己平常抖多大,不然之後所有的判斷都沒有比較基準。
這一點必須在上線前就跟品質委員會講清楚,否則前兩次誤報會被直接解讀成「這個系統不可靠」,然後你就沒有第三次機會了。我後來把它寫進上線報告的第一頁,位置比效益還前面。
還有反過來的風險:管制圖自己也會製造告警疲勞。 界限設太緊,每個週期都響,響到第四次就沒人看了——Day 24 談的那件事,對監測系統一樣成立。
所以界限必須放寬到一個「會漏掉某些真實位移」的寬度。這是刻意的取捨,不是疏失。但取捨要寫下來、要有人認可:沒有寫下來的取捨,事後都會變成疏失。
品管有一句老話:沒有量測,就沒有管理。
放到 AI 上面,要補一個前提才成立:
沒有一個固定不變的參照,就沒有量測。
我們花了很多力氣在讓 AI 判得更準。但真正讓這件事能長期跑下去的,反而是右邊那一欄——那組永遠不變、刻意不去優化、每個月拿出來重跑一次的案例。
它不會讓系統變好。它只是讓系統變壞的時候,有人知道。


 iThome鐵人賽
 看影片追技術