

假設你拿到一本厚達 100 萬個英文字母 的解密小說,想像你要在其中找尋關鍵線索……
如果只用人力去讀,簡直是不可能的任務。而 Google DeepMind 的 AlphaGenome 能夠在 1 秒內吞下 100 萬個 DNA 鹼基(1 Megabase),正是因為它配備了 AI 界的兩大頂級武器:卷積神經網路(CNN) 與 Transformer!
今天,我們就來拆解這兩大 AI 技術如何分工合作,化身為生命科學界的「雙劍合璧」!
在 100 萬個鹼基的浩瀚 DNA 序列中,並非每一個字母都同等重要。DNA 上散佈著許多短小的特定序列(長度約 6 到 20 個字母),稱為 「基序(Motif)」。
這些基序就像是蛋白質(如轉錄因子)在 DNA 上降落的 「專屬停機坪」。如果突變把停機坪的標誌改掉了,蛋白質就無法降落,基因開關也就無法打開。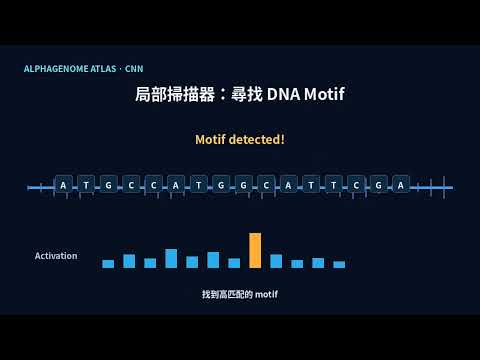
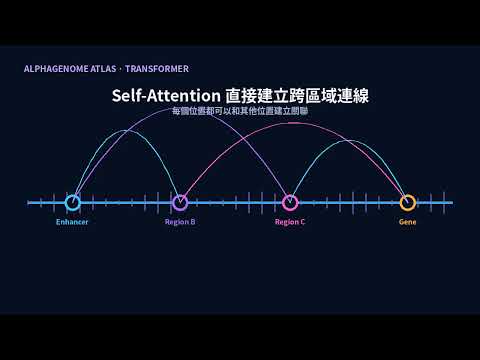
TATA-box 或特定的剪接點標記)。光找到當地的停機坪還不夠!我們前面提到,位於 50 萬個字母外的「遙控開關(增強子)」,會在 3D 空間中彎過來貼在基因上。
如果只靠 CNN,訊號在大範圍傳遞時會像「玩傳話遊戲」一樣,傳得越遠,訊息衰減得越嚴重。AlphaGenome 因此請出了當今大語言模型(如 Gemini)的核心技術—— Transformer!
| 網路架構 | 在 AlphaGenome 中的任務 | 白話比喻 | 對應的生物學意義 |
|---|---|---|---|
| CNN (卷積神經網路) | 捕捉局部短序列特徵 | 關鍵字高亮筆(精準找出短序列特徵) | 辨識轉錄因子結合位點(TFBS)、RNA 剪接位點、核心啟動子 |
| Transformer | 建立超遠距離調控連線 | 跨頁超連結(無視距離瞬間對接) | 模擬 3D 染色質環(Chromatin Loops)、遠端增強子與啟動子的互動 |
AlphaGenome 回傳的是一個層次分明的字典(Dictionary / JSON)。今天我們撰寫一個解析函數,精準提取 avi_score(AVI 風險百分位) 與 feature_attribution(主要分子破壞機制)。
parse_response.py# parse_response.py - 解構 AlphaGenome API 的 JSON 回傳包
import config
from hello_alphagenome import fetch_variant_raw_response
def parse_variant_metrics(raw_response):
"""將複雜的字典數據萃取為乾淨的核心指標"""
variant_id = raw_response.get("variant_id", config.TEST_VARIANT)
# 1. 提取 AVI 風險評分 (Percentile / PHRED 標尺)
avi_data = raw_response.get("avi_score", {})
avi_percentile = avi_data.get("percentile", 0.0)
# 2. 提取 SHAP 特徵歸因(主要破壞機制)
attribution = raw_response.get("feature_attribution", {})
drivers = attribution.get("top_drivers", [])
primary_mechanism = "未知機制"
if drivers and len(drivers) > 0:
primary_mechanism = drivers.get("feature_name", "未知機制")
return {
"variant_id": variant_id,
"avi_percentile": avi_percentile,
"primary_mechanism": primary_mechanism
}
if __name__ == "__main__":
raw = fetch_variant_raw_response(config.TEST_VARIANT)
metrics = parse_variant_metrics(raw)
print("\n🎯 萃取後的關鍵數據:")
print(f" • 變異座標: {metrics['variant_id']}")
print(f" • AVI 分數: {metrics['avi_percentile']} / 30")
print(f" • 主要機制: {metrics['primary_mechanism']}")
明天,我們將剖析 AlphaGenome 如何利用這套強大架構,在單一鹼基解析度上同時輸出數千項調控特徵,完成這場多模態的預測革命!


 iThome鐵人賽
 看影片追技術