

試想,要如何在 50 萬部 4K 高畫質電影裡,秒速找到「某個演員的某個眼神」?
1 Petabyte(PB)到底有多大?
1 PB 等於 1,000 TB,或者相當於 1,000,000 GB!如果換算成我們平常看的 4K 超高畫質影片,大概可以連續播放幾十年不間斷;如果把它存進智慧型手機,需要上千支頂配手機才裝得下!
Google DeepMind 的 AlphaGenome Atlas 打造的這座「全基因組預計算地圖」,資料量就高達 1 PB。
但是,如果醫生或科學家要在這座 1 PB 的資料大海中,查詢某位罕見病患者身上「第 9 號染色體某個字母突變」的影響,點一下查詢,如果需要等半小時,那這座地圖就毫無臨床實用價值了。
今天,我們就來拆解 AlphaGenome 如何透過空間索引(Spatial Indexing)與數據壓縮技術,實現「從 1 PB 海洋中秒撈數據」!
為什麼 AlphaGenome Atlas 的資料量會膨脹到如此誇張的 1 PB?我們可以算一筆賬:
90 億個變異 × 數千項跨組織特徵 = 1 PB 的巨型資料海洋。如果用傳統的 Excel 表格或純文字 JSON 檔開啟,電腦會瞬間崩潰!
當你去一座擁有幾百萬本書的國家圖書館,如果想找一本關於「大腦神經發育」的書,你大概不會從第一排書架的第一本書開始一頁頁翻(這在電腦裡叫「全表掃描 Full Table Scan」)。最好是從「分類索引」開始找(例如:神經科學類 ➔ 第三排書架 ➔ 第五層)。
AlphaGenome 檢索 1 PB 資料庫的核心思想稱為 「空間索引(Spatial Indexing)」:
在資料庫中,每個變異都有專屬的「地理座標 GPS」:
chr9)。123,456)。A > G)。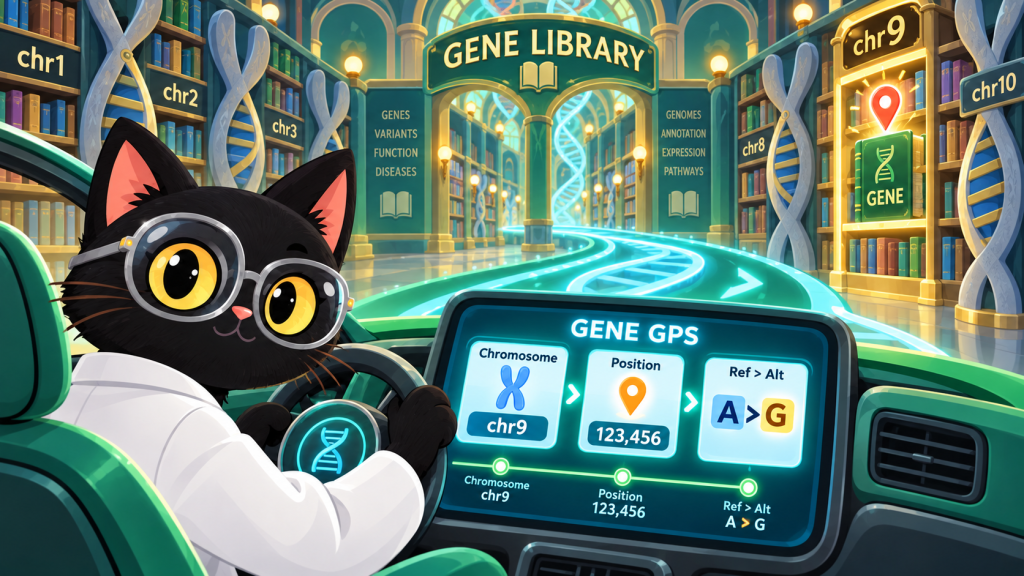
系統利用類似 Tabix 或 BigWig 的技術,把 1 PB 的巨型地圖切分成無數個極小的「數據方塊(Chunks)」。
當研究員輸入 chr9:123456 時,後端伺服器完全不需要解開整座 1 PB 資料庫,而是透過 B-Tree 空間索引直接定位到存有該座標的那一個幾 KB 微小數據塊,解壓並回傳,瞬間完成「秒撈」!
| 儲存與檢索挑戰 | 傳統處理方式(全表掃描) | AlphaGenome 的雲端原生解法(空間索引) |
|---|---|---|
| 資料下載 | 需下載幾百 GB 原始檔案到本地電腦解析 | 透過 RESTful API 進行「點對點串流查詢」,用多少抓多少 |
| 檢索速度 | 逐行搜尋,耗時數分鐘甚至數小時 | 依賴 B-Tree 空間索引,毫秒至秒級立即回應 |
| 硬體依賴 | 醫院/研究室需自購數百萬的高級伺服器叢集 | 無伺服器架構(Serverless),運算與儲存壓力全在雲端 |
calculate_delta.py)拿到特定器官的預測波形後,我們會得到兩組一維數字陣列:野生型 (ref_signal) 與突變型 (alt_signal)。
為了找出突變帶來的 「淨破壞力(Net Impact)」,我們不能單看突變後的高度,而是必須計算兩者的落差,也就是 Delta Score:
[\text{Delta Score} = \text{Alt (突變型波形)} - \text{Ref (野生型波形)}]
calculate_delta.py# calculate_delta.py - 用 NumPy 計算波形 Delta Score 差值
import numpy as np
import config
from hello_alphagenome import fetch_variant_raw_response
from filter_tissue_tracks import filter_tissue_tracks
def compute_track_delta(track_data):
"""將列表轉為 NumPy 矩陣,計算差值並找出最大波峰位置"""
ref_arr = np.array(track_data.get("ref_signal", []))
alt_arr = np.array(track_data.get("alt_signal", []))
# 核心矩陣減法:計算 Delta 陣列
delta_arr = alt_arr - ref_arr
# 找出絕對破壞力最大的波峰位置與數值
max_idx = np.argmax(np.abs(delta_arr))
max_delta = delta_arr[max_idx]
return {
"tissue": track_data.get("tissue"),
"assay": track_data.get("assay_type"),
"max_delta_value": float(max_delta),
"max_delta_index": int(max_idx),
"delta_array": delta_arr
}
if __name__ == "__main__":
raw = fetch_variant_raw_response(config.TEST_VARIANT)
tracks = filter_tissue_tracks(raw, config.TARGET_TISSUE, "splicing")
delta_res = compute_track_delta(tracks)
print("\n" + "="*50)
print(f"🧠 器官: {delta_res['tissue']} | 模態: {delta_res['assay']}")
print(f"⚠️ 最大波峰破壞力 (Max Delta): {delta_res['max_delta_value']:+.4f} (發生在相對座標 {delta_res['max_delta_index']})")
print("="*50)
到目前為止,對於 AlphaGenome 演算法與工程黑盒子的深度拆解:CNN + Transformer 雙劍合璧、多模態分子軌跡、VEP 差分數學,一直到 1 PB 的預計算架構。
後續將探討 AlphaGenome 如何將這些海量數據濃縮成終極的 AVI (AlphaGenome Variant Impact) 評分,並開始拆解關於癲癇嬰兒的真實病歷。


 iThome鐵人賽
 看影片追技術