

如果你玩過「大家來找碴(Spot the Difference)」遊戲,你一定知道:如果單獨看其中一張圖片,很難看出哪個細節被偷偷改動了。但只要把「原本的照片(原圖)」和「修改後的照片(改圖)」疊在一起比對相減,被動過手腳的地方就會瞬間亮起來!
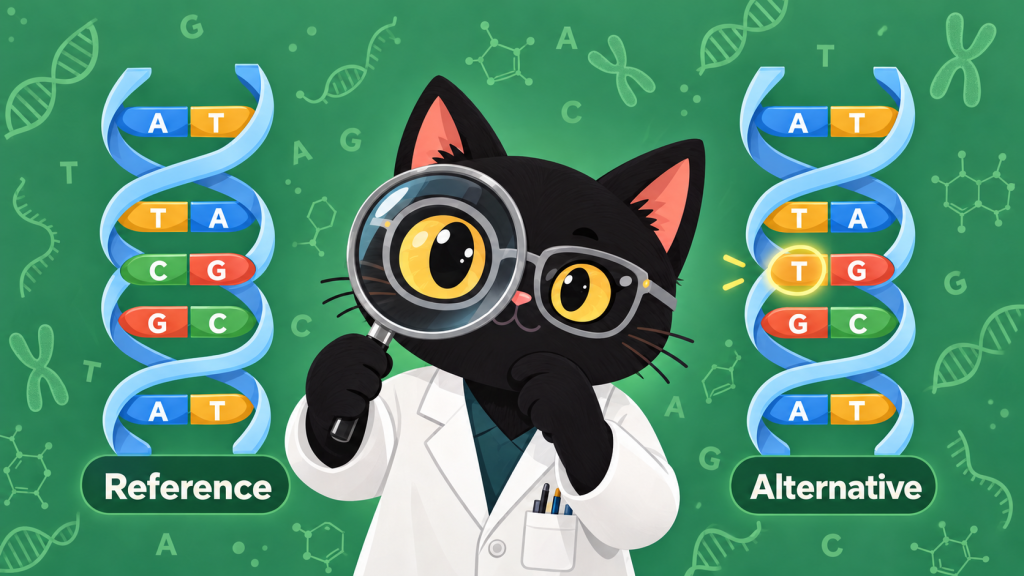
在基因科學的世界裡,要評估一個 DNA 字母突變(A、T、C、G)到底會不會讓人致病,AI 採用的就是這種「找不同」的差分數學邏輯,稱為 突變效應預測(Variant Effect Prediction, VEP)。
今天,我們就來揭開 VEP 的數學本質,並看看 AI 如何像「找不同」遊戲一樣精準抓出致病訊號?透過「序列平移增強(Shift Augmentation)」技術消除邊界誤差,實現極致純淨的基因訊號捕捉!
要評估一個單鹼基突變是否有害,單看突變後的預測數值是沒有意義的。這就像是看足球比賽:如果只看「進球數」而不看「失球數」,就無法算出真正的「淨勝球」。
AlphaGenome 進行突變效應預測(VEP)時採用了完全相同的差分邏輯。面對人類參考基因組(hg38)中約 90 億種單鹼基變異(SNVs)與超過 1 億種插入缺失(Indels),AI 模型在後台對長達 1 Megabase(100 萬鹼基)的序列會執行兩次預測:
系統最後會將這兩個矩陣進行相減,得出一個 Delta Score(信號變化量)。
這個「淨差值」剔除了個體背景的基因雜訊,精準量化了這個突變到底讓 RNA 剪接增加了多少,或者讓染色質開放度下降了幾成。
當卷積神經網路(CNN)處理高達 100 萬鹼基(1 Mb)的長序列時,遇到了一個令人頭痛的數學問題:邊界誤差(Boundary Artifacts)與座標錯位。
當 AI 使用滑動窗口掃描序列時,如果某個基因突變(特別是改變序列長度的插入或缺失 Indels)剛好落在窗口的最邊緣,CNN 在提取特徵時就會因為視角被裁切或記憶域錯位,產生數學上的「邊界邊緣鋸齒與數值失真」。
| 處理階段 | 運算邏輯與挑戰 | 在 AlphaGenome 中的解決方案 | 白話比喻 |
|---|---|---|---|
| 信號差分 (Delta) | 排除背景基因表現的干擾,找出突變造成的絕對變化量。 | 矩陣相減 (Alternative - Reference),提取純淨變異影響。 | 就像足球比賽算「淨勝球」,剔除背景干擾。 |
| 邊界偽影 (Artifacts) | 突變點位於卷積窗口邊緣或 Indel 導致座標錯位時,特徵失真。 | 採用 Shift Augmentation,平移序列窗口並進行激活層拼接(Stitching)與平均。 | 拍照時主角太靠邊緣?鏡頭往左往右多拍幾張並拼接取平均! |
filter_tissue_tracks.py)AlphaGenome 能同時預測數千條跨器官的分子波形。但正如我們在六週大癲癇嬰兒案例中學到的:有些致病變異(如隱藏剪接)只在大腦神經元裡發作,血液裡完全測不到。
今天我們撰寫一個「軌跡篩選器」,根據你在 config.py 設定的 TARGET_TISSUE(如 brain、heart、mammary_gland),將無關器官的數據全部「靜音」!
filter_tissue_tracks.py# filter_tissue_tracks.py - 組織特異性軌跡過濾器
import config
from hello_alphagenome import fetch_variant_raw_response
def filter_tracks_by_tissue(raw_response, target_tissue, target_assay="splicing"):
"""
從 API 回傳的 tracks 陣列中,精準過濾出指定器官與模態的波形數據
"""
tracks = raw_response.get("tracks", [])
print(f"📡 API 共回傳 {len(tracks)} 條跨器官軌跡,正在篩選 [{target_tissue} - {target_assay}]...")
matched_tracks = []
for t in tracks:
# 比對器官名稱與實驗模態 (如 splicing, DNase, ATAC)
tissue_match = target_tissue.lower() in t.get("tissue", "").lower()
assay_match = target_assay.lower() in t.get("assay_type", "").lower()
if tissue_match and assay_match:
matched_tracks.append(t)
# 如果找不到實際軌跡,提供新手模擬軌跡 (Mock Track Data)
if not matched_tracks:
print(f"💡 [Mock 模式] 生成 [{target_tissue}] 組織的 100 bp 模擬波形數據...")
import numpy as np
# 模擬野生型 (Ref) 正常生理狀態趨近於 0.02
ref_sim = np.full(100, 0.02).tolist()
alt_sim = np.full(100, 0.02).tolist()
alt_sim = 0.87 # 模擬在相對第 50 個位置觸發突變波峰!
matched_tracks.append({
"tissue": target_tissue,
"assay_type": target_assay,
"ref_signal": ref_sim,
"alt_signal": alt_sim
})
return matched_tracks
if __name__ == "__main__":
raw = fetch_variant_raw_response(config.TEST_VARIANT)
brain_splicing = filter_tracks_by_tissue(raw, config.TARGET_TISSUE, "splicing")
print(f"\n✅ 成功抓取 {len(brain_splicing)} 條特異性軌跡!")
後續探討這套涵蓋 90 億突變的 1 PB 巨量資料庫,在工程上是如何被壓縮、索引,並部署成全球科研社群都能秒速查詢的公共基礎設施!


 iThome鐵人賽
 看影片追技術