
主張:傳統軟體測試問「對不對」,agent 測試要多問一句「走的路合不合理」。
讀完能做到:用 ADK 內建的評估準則替 agent 建一條可以掛進 CI 的品質防線,並知道adk optimize能自動改到什麼程度、不能改到什麼程度。
Day 25 講完 Agent Skills 之後,第五篇「實彈演習」正式開始——前面四篇都在教你怎麼把 agent 做出來,接下來五天要處理的是另一個問題:你怎麼知道它做得夠好,而且明天還是一樣好。
這其實是個很容易被輕忽的問題。傳統軟體有單元測試,斷言一行對不對、一個函式回傳值符不符合預期,非黑即白。但 LLM agent 是機率性系統:同一句提問問十次,可能有十種措辭略有不同的回答,但語意都對;也可能有一次因為 retrieval 抓錯資料而整段胡說八道。你沒辦法只斷言字串相等,你需要質化評估,同時看兩件事:最終回應的品質,以及agent 是怎麼走到這個回應的。
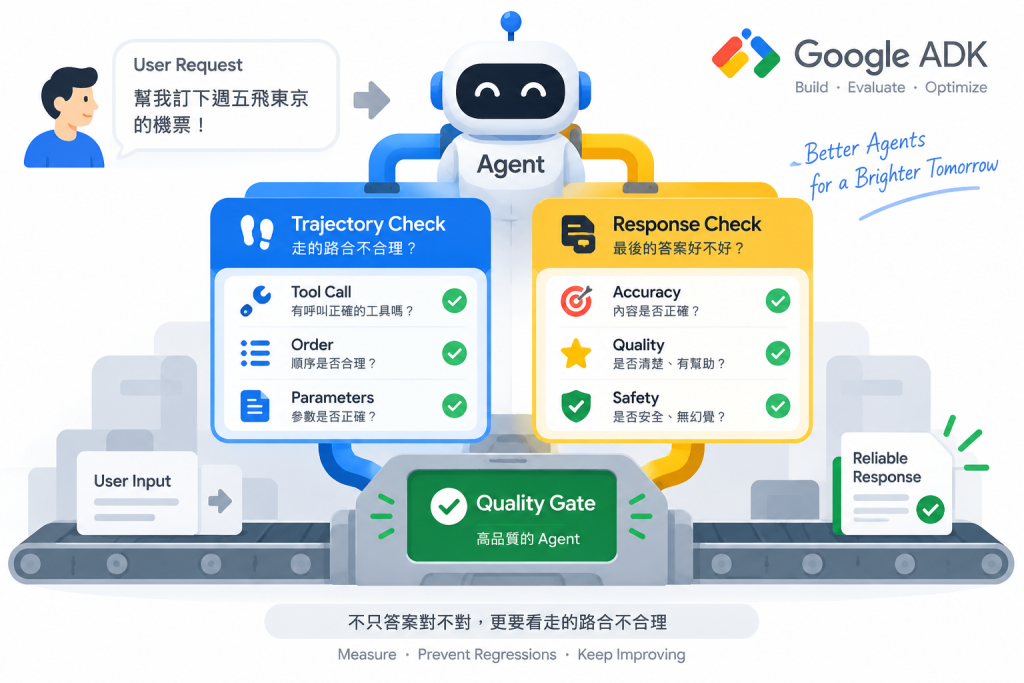
想像一個訂票 agent。使用者問「幫我訂下週五飛東京的機票」,agent 回了一句「已為您完成訂票」。單看這句回應,完全正確,語氣得體。但如果拉開它的執行軌跡,你可能會發現它壓根沒呼叫查詢航班的工具,直接編了一個訂位結果——這種情況只看最終回應是抓不出來的,你得看軌跡:agent 實際呼叫了哪些工具、用了什麼參數、順序是什麼。
ADK 把這條軌跡定義成一份步驟清單,拿它跟你預期的步驟清單做比對:
expected_steps = ["determine_intent", "use_tool", "review_results", "report_generation"]
actual_steps = ["determine_intent", "use_tool", "review_results", "report_generation"]
這就是為什麼 ADK 的評估框架不是單一指標,而是一整組準則(criteria),分別鎖定軌跡與結果的不同面向。
寫評估案例之前,先決定你要用哪一種容器裝它們。
Test files(*.test.json)是最輕量的形式,一個檔案代表一次簡單的 agent-model 互動(可能含多輪),適合在開發期當單元測試跑,追求快速執行。每個 test file 記錄使用者輸入、預期的中間工具呼叫軌跡、預期的中間 agent 回應(在多 agent 系統裡,子 agent 產生的自然語言回應對開發者很重要——它們證明 agent 走的是對的路)、以及最終回應。這些資料現在都有正式的 Pydantic schema 撐腰(EvalSet 與 EvalCase)。
一份 test file 濃縮之後長這樣(官方 home_automation_agent 範例,裁掉部分欄位):
{
  "eval_set_id": "home_automation_agent_light_on_off_set",
  "eval_cases": [
    {
      "eval_id": "eval_case_id",
      "conversation": [
        {
          "invocation_id": "b7982664-0ab6-47cc-ab13-326656afdf75",
          "user_content": {
            "parts": [{"text": "Turn off device_2 in the Bedroom."}],
            "role": "user"
          },
          "final_response": {
            "parts": [{"text": "I have set the device_2 status to off."}],
            "role": "model"
          },
          "intermediate_data": {
            "tool_uses": [
              {
                "args": {"location": "Bedroom", "device_id": "device_2", "status": "OFF"},
                "name": "set_device_info"
              }
            ],
            "intermediate_responses": []
          }
        }
      ],
      "session_input": {
        "app_name": "home_automation_agent",
        "user_id": "test_user",
        "state": {}
      }
    }
  ]
}
user_content 是使用者輸入,intermediate_data.tool_uses 是預期的工具呼叫軌跡(照時間順序排列),final_response 是預期的最終回應。
Evalset file(*.evalset.json)則是把多個、可能很長的 session 打包進一份資料集,適合當整合測試,模擬複雜的多輪對話。因為涵蓋範圍更完整,通常跑的頻率比 test files 低。
第三種是這次連載大綱完全沒提到、但我認為才是「上線」真正需要的東西——conformance testing。
adk conformance test 解決的是一個很具體的痛點:你改了 agent 的 instruction、換了個模型版本、或升級了 ADK,怎麼知道有沒有把原本能動的東西改壞?它的做法是把「現在的即時行為」拿去跟一份事先錄好的「golden baseline」比對。
測試目錄有固定階層,靠這個結構自動發現與對映測試案例:
tests
└── category_name/
    └── test_case_name/
        ├── spec.yaml                   # 測試規格
        ├── generated-recordings.yaml   # 錄製的 baseline 互動
        └── generated-session.yaml      # 錄製的 baseline session
spec.yaml 只需要描述初始條件與使用者 prompt:
description: "Verifies the agent correctly identifies location and calls the weather tool."
agent: "weather_agent"
user_messages:
  - text: "What's the temperature in San Francisco right now?"
官方文件有一句話值得停下來記:不要自己手寫 baseline 檔案,因為背景資料(LLM request、tool call)太複雜,容易手滑寫錯。正確做法是先啟動帶錄製 plugin 的 web server,再用 adk conformance record 自動錄:
adk web -v --extra_plugins=google.adk.cli.plugins.recordings_plugin.RecordingsPlugin /path/to/agents
adk conformance record tests/category/test_name none
第二個參數是 streaming 模式,none 或 sse 二選一(bidi 目前不支援錄製)。跑完之後,adk conformance test 就能用 Replay Mode(預設,拿即時行為比對錄好的 baseline)執行——Live Mode 目前官方標為「work in progress」,還不建議依賴。加上 --generate_report --report_dir=reports 可以產出一份乾淨的 Markdown 測試報告。這正是它最實用的地方:因為 conformance test 是命令列工具、失敗就會回非零狀態碼,你可以直接把它掛進 CI/CD,設定成只要 agent 的預期行為變了就擋下 PR 合併——這比任何質化的 LLM-judge 準則都更適合當守門員,因為它的判斷是確定性的。
ADK 內建了十二個評分準則,分成四種性質,選錯準則是評估體系最常見的浪費——花錢跑 LLM-as-a-judge 卻只是想確認工具呼叫順序對不對。
| 準則 | 是否需要標準答案 | 是否需要 rubric | 是否用 LLM 當裁判 | 支援 User Simulation |
|---|---|---|---|---|
tool_trajectory_avg_score |
是 | 否 | 否 | 否 |
response_match_score |
是 | 否 | 否 | 否 |
final_response_match_v2 |
是 | 否 | 是 | 否 |
rubric_based_final_response_quality_v1 |
否 | 是 | 是 | 是 |
rubric_based_tool_use_quality_v1 |
否 | 是 | 是 | 是 |
rubric_based_multi_turn_trajectory_quality_v1 |
否 | 是 | 是 | 是 |
hallucinations_v1 |
否 | 否 | 是 | 是 |
safety_v1 |
否 | 否 | 是 | 是 |
per_turn_user_simulator_quality_v1 |
否 | 否 | 是 | 是 |
multi_turn_task_success_v1 |
否 | 否 | 是 | 是 |
multi_turn_trajectory_quality_v1 |
否 | 否 | 是 | 是 |
multi_turn_tool_use_quality_v1 |
否 | 否 | 是 | 是 |
挑準則的邏輯其實不複雜。要接進 CI/CD 做快速的迴歸測試,用 tool_trajectory_avg_score 加 response_match_score 就好——它們是確定性計算,不用等 LLM 判官,便宜又穩定。tool_trajectory_avg_score 還有三種比對嚴格度可選:EXACT 要求完全一致(哪怕多呼叫一次工具都算失敗)、IN_ORDER 要求關鍵呼叫照順序出現、允許中間插別的呼叫、ANY_ORDER 只要求都出現、不管順序——像是你的 agent 一次發五個搜尋請求,你不在乎哪個先哪個後,就該用 ANY_ORDER。
沒有標準答案可以比對、或答案的措辭本來就會變動時,才輪到 LLM-as-a-judge 出場:final_response_match_v2 判斷語意是否等價、rubric_based_final_response_quality_v1 讓你用自訂的 rubric(比如「回應是否簡潔」「有沒有正確推斷使用者意圖」)去評分,適合完全沒有標準答案、但你能描述「什麼是好答案」的情境。
有一個容易漏掉的限制:safety_v1、multi_turn_task_success_v1、multi_turn_trajectory_quality_v1、multi_turn_tool_use_quality_v1 這幾個準則委派給 Vertex Gen AI Evaluation Service API 或 Agent Platform Eval SDK 執行,需要設定 GOOGLE_CLOUD_PROJECT 與 GOOGLE_CLOUD_LOCATION 並拿到有效憑證——沒有 GCP 專案就用不了這幾個。另外,rubric 型準則的有效規則清單不能是空的,否則 RubricBasedEvaluator 會直接丟 ValueError;rubric 可以定義在 EvalConfig 層級,也可以掛在個別 EvalCase.rubrics(依 type 過濾),兩者是聯集關係。
不指定任何 criteria 時,ADK 會退回一組預設值:tool_trajectory_avg_score 門檻 1.0(要求百分之百比對),response_match_score 門檻 0.8。
Python v1.18.0 起,你可以寫自己的評分函式。簽章是固定的:
from typing import Optional
from google.adk.evaluation.eval_case import Invocation
from google.adk.evaluation.eval_metrics import EvalMetric
from google.adk.evaluation.conversation_scenarios import ConversationScenario
from google.adk.evaluation.evaluator import EvaluationResult

def my_custom_metric_function(
    eval_metric: EvalMetric,
    actual_invocations: list[Invocation],
    expected_invocations: Optional[list[Invocation]],
    conversation_scenario: Optional[ConversationScenario],
) -> EvaluationResult:
  ...
回傳一個帶 overall_score、overall_eval_status、per_invocation_results 的 EvaluationResult。也支援 async,官方範例是一個檢查回應有沒有髒話的假 API 呼叫——這個模式很適合套進真實場景,比如檢查回應裡有沒有洩漏你資料庫的內部欄位名稱,或是有沒有引用過期的價目表。定義好之後在 EvalConfig 的 custom_metrics 物件裡,用 code_config.name 指向 Python import path(my_agent.metrics.check_final_response_exact_match)註冊,就能跟內建準則一起在 adk eval 裡跑。
adk eval <AGENT_MODULE_FILE_PATH> <EVAL_SET_FILE_PATH_OR_ID>...,這是最適合接自動化的形式;adk eval_set create / add_eval_case 管理資料集,adk eval_set generate_eval_cases 甚至能用 Agent Platform Eval SDK 自動生成多樣化的測試情境(這個功能也需要 GCP 憑證)。pytest 裡呼叫 AgentEvaluator.evaluate(agent_module=..., eval_dataset_file_path_or_dir=...),直接整進你既有的測試套件與 CI pipeline。adk optimize:讓評估結果反過來改 agent如果評估告訴你 agent 有問題,下一步通常是手動改 instruction、重跑評估、再改——這個迴圈本身也能自動化,這就是 adk optimize(Python v1.24.0)在做的事。
它的架構分兩個角色:Sampler 負責跑候選 agent 並產生詳細的評估結果,Agent Optimizer 讀這些結果、決定怎麼改進 agent。官方範例讓我印象很深——拿 hello_world 範例 agent(原本只會判斷質數)去學一條它完全沒被教過的新規則:質數叫「壞數字」、非質數叫「好數字」。這條指令不是憑空跑起來的,前面要先備好兩個檔案。Step 1:在 contributing/samples/core/hello_world/ 底下建立 train_eval_set.evalset.json,定義三個 eval case——一個是原本就會的質數判斷(「Is 7 prime?」),兩個是「好/壞數字」的新規則,每個案例都附上預期的 final_response。Step 2:建立 sampler_config.json,指定要評估的 app_name、要用哪個 train_eval_set,以及比對用的門檻:
{
  "eval_config": {
    "criteria": {
      "response_match_score": 0.75
    }
  },
  "app_name": "hello_world",
  "train_eval_set": "train_eval_set"
}
兩個檔案都準備好,Step 3 才是真正跑最佳化:
adk optimize contributing/samples/core/hello_world \
--sampler_config_file_path contributing/samples/core/hello_world/sampler_config.json
Optimizer 產出的新 instruction 不只補了「好/壞數字」的定義,還主動要求 agent 一律先呼叫 check_prime 工具、外加一句「不要說你無法回答這類問題」——這兩件事都沒有寫在原始的三個評估案例裡,是 optimizer 從評估結果的落差裡自己反推出來的。這說明了 optimizer 做的不是關鍵字比對,而是真的在分析「哪裡沒達標、為什麼」。
但這裡有兩個限制,寫進團隊的 checklist 之前務必先確認:預設的 GEPARootAgentPromptOptimizer 只改 root agent 的 instruction,不會動任何 sub-agent、agent tool 或 skill——想連 skill 指令一起優化,要換用 GEPARootAgentOptimizer。第二,它是 Experimental,建構時會跳警告,API 可能不經通知就改變。如果你不想要 GEPA 那種維護多候選 Pareto frontier 的複雜度,還有一個更直白的選項 SimplePromptOptimizer——序列式跑 Execute → Evaluate → Critique → Rewrite 四階段迴圈,只專注在改善單一 prompt,而且不會原地修改你的 agent 實例,完成後回傳分數最高的版本讓你自己決定要不要採用。
今天講的評估,前提是你已經有一份寫好的評估資料集——固定的使用者提問、固定的預期回應。但真實使用者的對話走向本來就不是照劇本走的,同一個任務,有人會一次把資訊全講完,有人會被問一句答一句。明天要看 ADK 怎麼連使用者本身都用 LLM 動態模擬出來,而且連 agent 呼叫的外部工具都能一併模擬,讓整個測試環境變成完全可控、可重現的沙盒。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術