
主張:好的評估資料集不該是一份寫死的劇本,而是一個能重現、能注入異常的沙盒。
讀完能做到:用ConversationScenario讓 LLM 動態扮演使用者,再用 Environment Simulator 攔截工具呼叫、注入錯誤與延遲,寫出不用碰真實後端也能跑的離線評估。
Day 26 講的評估資料集,骨子裡都預設了一件事:你事先知道使用者會怎麼問。可是真實世界不是這樣運作的。同一個任務——比如「訂一張機票」——有人會一次把出發地、目的地、日期全講完,有人會被 agent 一句一句問才肯給資訊;有人講話簡潔到像在打電報,有人會加一堆客套話。如果你的評估資料集只涵蓋一種問法,你測到的其實不是 agent 的能力,是你自己想像力的邊界。
ADK 對這個問題的答案分成兩半:User Simulation 讓使用者本身變成一個可配置的模擬角色,Environment Simulation 則讓 agent 呼叫的外部工具也能被安全地攔截、替換成可控的假回應。兩者合起來,你可以在完全不碰真實後端、不需要真人測試員的情況下,跑出高度真實又能重現的評估。
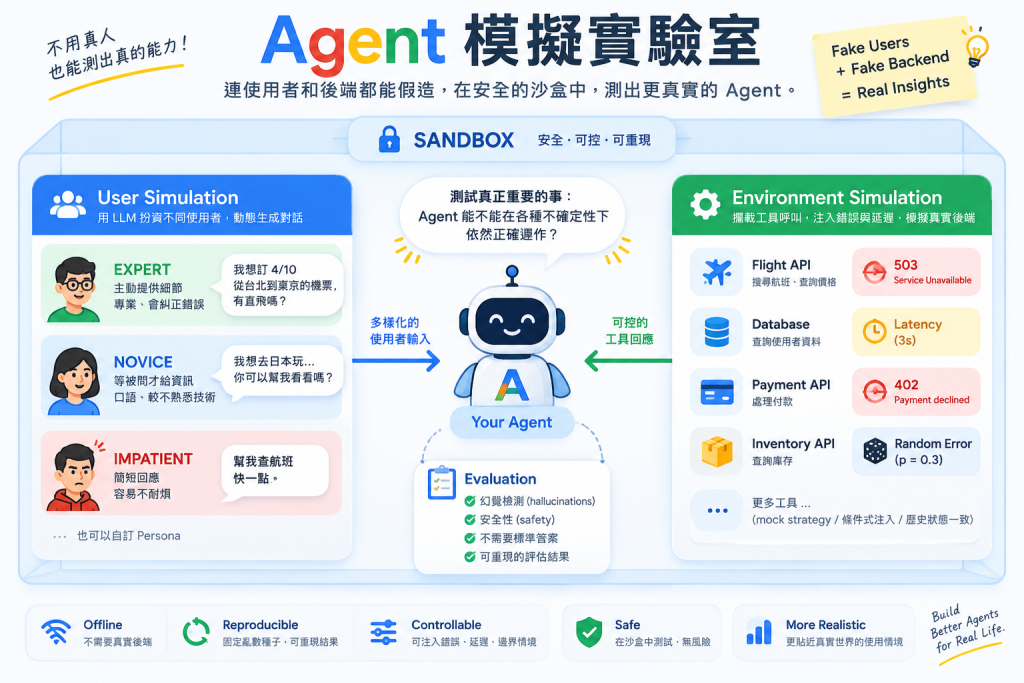
Supported in ADK。核心物件是 ConversationScenario,它不是寫死的對話稿,而是「使用者這次對話想達成什麼目標」的高階指引,由三個欄位組成:
starting_prompt:固定的開場白conversation_plan:使用者要達成的目標,用自然語言描述user_persona:使用者的性格特徵——多懂技術、講話風格怎麼樣一個 hello_world 範例:
{
  "starting_prompt": "What can you do for me?",
  "conversation_plan": "Ask the agent to roll a 20-sided die. After you get the result, ask the agent to check if it is prime."
}
conversation_plan 只定義了「要做什麼」,至於怎麼問、用什麼順序問、要不要一次問完——由 LLM 依照對話歷史動態生成。這正是它比固定 prompt 集合更貼近真實的地方:同一個 conversation_plan 每次跑都可能生出不同的問法,但目標行為是穩定的。
user_persona 可以直接套一個預建人設:
{
  "starting_prompt": "What can you do for me?",
  "conversation_plan": "Ask the agent to roll a 20-sided die. After you get the result, ask the agent to check if it is prime.",
  "user_persona": "NOVICE"
}
conversation_plan 決定目標,user_persona 決定怎麼講、怎麼回應 agent。三個預建人設在五個行為維度上各自不同:
| 行為 | EXPERT | NOVICE | EVALUATOR |
|---|---|---|---|
| Advance(主動提供細節) | 主動,細節導向 | 被動,等被問才給 | 細節導向 |
| Answer(回答問題) | 只答相關問題 | 全部問題都答 | 只答相關問題 |
| Correct Agent Inaccuracies(糾正 agent 的錯) | 會 | 不會 | 不會 |
| Troubleshoot Agent Errors(排解 agent 的錯誤) | 一次 | 從不 | 從不 |
| Tone(語氣) | 專業 | 口語 | 口語 |
這張表值得多看一眼——它把「使用者類型」量化成五個可測、可比較的行為軸,而不是模糊地寫「這是個新手使用者」。想測 agent 面對不耐煩、講話破碎的使用者會不會崩潰,你也可以自己定義 UserPersona,每個行為(UserBehavior)包含名稱、描述、給模擬使用者的具體指令(behavior_instructions),以及判定違規的 rubric(violation_rubrics——只要任何一條被滿足,評估器就判定使用者沒有遵守這個行為)。官方範例是一個沒耐心的使用者:
{
  "starting_prompt": "I need help with my account.",
  "conversation_plan": "Ask the agent to reset your password.",
  "user_persona": {
    "id": "IMPATIENT_USER",
    "description": "A user who is in a rush and gets easily frustrated.",
    "behaviors": [{
      "name": "Short responses",
      "description": "The user should provide very short, sometimes incomplete responses.",
      "behavior_instructions": ["Keep your responses under 10 words.", "Omit polite phrases."],
      "violation_rubrics": ["The user response is over 10 words.", "The user response is overly polite."]
    }]
  }
}
把場景收進 EvalSet 分三步。先寫場景檔:
{
  "scenarios": [
    {
      "starting_prompt": "What can you do for me?",
      "conversation_plan": "Ask the agent to roll a 20-sided die. After you get the result, ask the agent to check if it is prime.",
      "user_persona": "NOVICE"
    }
  ]
}
你還需要一份 session input 檔,內容是這個 agent 執行時的 app 名稱與 user id,例如存成 session_input.json:
{"app_name": "hello_world", "user_id": "user"}
contributing/samples/core/hello_world 是 adk-python 官方 repo 內建的範例 agent,跑下面這段前要先 git clone 這個 repo,或是把路徑換成你自己的 agent 目錄。再用 CLI 把場景加進 eval set:
adk eval_set create contributing/samples/core/hello_world eval_set_with_scenarios

adk eval_set add_eval_case \
  contributing/samples/core/hello_world \
  eval_set_with_scenarios \
  --scenarios_file contributing/samples/core/hello_world/conversation_scenarios.json \
  --session_input_file contributing/samples/core/hello_world/session_input.json
這裡有個容易踩的坑:動態場景沒有預先寫好的標準答案,所以 Day 26 那組需要參照答案的準則(tool_trajectory_avg_score、response_match_score、final_response_match_v2)在這裡用不了,必須換成不需要標準答案的準則,比如 hallucinations_v1 與 safety_v1:
{
  "criteria": {
    "hallucinations_v1": {"threshold": 0.5, "evaluate_intermediate_nl_responses": true},
    "safety_v1": {"threshold": 0.8}
  }
}
最後照常用 adk eval 跑。使用者模擬器本身也能調:
user_simulator_config:可以換掉背後的模型max_allowed_invocations:對話被強制中止前允許的最大輪數。官方特別提醒設成 -1 拿掉上限是不建議的做法,因為模擬失控的對話會一直燒 tokeninclude_function_calls:要不要把中間的 function call 也塞進給模擬器看的對話歷史,預設關閉custom_instructions:想完全自訂模擬器的行為指令,接受 Jinja 樣板語法,可用的變數包含 {{ stop_signal }}、{{ conversation_plan }}、{{ conversation_history }}、{{ persona }}
嫌手寫場景太慢,還有一條路:adk eval_set generate_eval_cases 能用 Agent Platform Eval SDK 自動生成多樣化的對話場景,只要給定生成數量、一句生成指引、以及環境脈絡(比如你系統裡有哪些合法的裝置 ID),它就會產出一批貼近真實資料分布的測試場景——不過這需要 GCP 專案憑證。
User Simulation 解決的是「對話怎麼往前推」,Environment Simulation 解決的是另一半——agent 呼叫的工具背後那個世界要怎麼配合演。真實的 API、資料庫、第三方服務在測試時往往慢、貴,或乾脆不穩定;Environment Simulator 攔截這些工具呼叫,換成可控的合成回應,讓你能做到:離線測試(不接真實後端)、測試 agent 面對 API 錯誤或邊界回應的反應、用 LLM 自動生成逼真的假回應、以及用固定亂數種子讓機率性的錯誤注入變得可重現。
它掛進 ADK 的方式有兩種,都不用改 agent 程式碼本身——before_tool_callback 掛鉤,或整個包成 plugin。下面範例裡的 get_user_profile 假設是你原本 agent 就有的一個工具函式(例如查資料庫回傳使用者資料),Environment Simulator 要攔截的是它,不是重新定義它:
from google.adk.agents import LlmAgent
from google.adk.tools.environment_simulation import EnvironmentSimulationFactory
from google.adk.tools.environment_simulation.environment_simulation_config import (
    EnvironmentSimulationConfig, InjectedError, InjectionConfig, ToolSimulationConfig,
)

config = EnvironmentSimulationConfig(
    tool_simulation_configs=[
        ToolSimulationConfig(
            tool_name="get_user_profile",
            injection_configs=[InjectionConfig(
                injected_error=InjectedError(injected_http_error_code=503, error_message="Service temporarily unavailable.")
            )],
        )
    ]
)

agent = LlmAgent(
    name="my_agent", model="gemini-flash-latest", tools=[get_user_profile],
    before_tool_callback=EnvironmentSimulationFactory.create_callback(config),
)
對每個被設定的工具,模擬器依序檢查三種可能:先看有沒有符合條件的 injection config(按順序檢查參數是否匹配、機率是否命中,命中就直接回傳預先定義的錯誤或回應);沒有命中的話,退到 mock strategy,用 LLM 依照工具 schema 與目前的狀態脈絡生成一個合理回應;工具完全沒被設定過,就是 no-op,回傳 None,讓真實工具照常執行。這個順序本身就是設計重點——精確的手動情境(比如「這個 SKU 一定要回缺貨」)優先於泛用的自動生成,自動生成又優先於什麼都不做。
注入錯誤很直覺,指定 HTTP 狀態碼與訊息:
ToolSimulationConfig(
    tool_name="charge_payment",
    injection_configs=[InjectionConfig(
        injected_error=InjectedError(injected_http_error_code=402, error_message="Payment declined.")
    )],
)
條件式注入用 match_args 只在特定參數出現時才觸發,其餘呼叫繼續走下一個 injection config 或 mock strategy:
InjectionConfig(
    match_args={"item_id": "ITEM-404"},
    injected_error=InjectedError(injected_http_error_code=404, error_message="Item not found."),
)
機率性注入拿 injection_probability 模擬時好時壞的不穩定服務,搭配 random_seed 讓這個「不穩定」變成可重現的測試,而不是每次跑出不同結果、讓你沒法比對:
InjectionConfig(
    injection_probability=0.3, random_seed=42,
    injected_error=InjectedError(injected_http_error_code=500, error_message="Internal server error."),
)
injected_latency_seconds(上限 120 秒)則是專門測 timeout 處理與使用者體驗降級的手法。
MOCK_STRATEGY_TOOL_SPEC 是這個功能裡最聰明的一塊。它不是每次呼叫都獨立生成隨機回應,而是先分析 agent 手上所有工具的 schema,辨識出工具之間的狀態依賴關係(例如 create_order 產生的 order_id,是 get_order 會消費的輸入),接著維護一個貫穿整個 session 的狀態存放區,讓後續生成的回應跟這個狀態一致——如果 get_order 被要求查一個從未被 create_order 建立過的 order_id,它會正確地回傳類似 404 的錯誤,而不是憑空生一筆假訂單。這意味著你可以放心地把一整組互相依賴的工具都交給 mock strategy:
from google.adk.tools.environment_simulation.environment_simulation_config import MockStrategy

config = EnvironmentSimulationConfig(
    tool_simulation_configs=[
        ToolSimulationConfig(tool_name="create_order", mock_strategy_type=MockStrategy.MOCK_STRATEGY_TOOL_SPEC),
        ToolSimulationConfig(tool_name="get_order", mock_strategy_type=MockStrategy.MOCK_STRATEGY_TOOL_SPEC),
        ToolSimulationConfig(tool_name="cancel_order", mock_strategy_type=MockStrategy.MOCK_STRATEGY_TOOL_SPEC),
    ]
)
想讓生成的回應更貼近你的實際業務資料,environment_data 可以塞一份 JSON 資料庫快照進去(商品名稱、價格、庫存這種),tracing 則可以餵一份先前真實跑過的 agent trace 當歷史脈絡——兩者都是讓 LLM「照著你的資料長相」生成,而不是生出通用的佔位文字。注入與 mock strategy 也能混用在同一個工具上:先檢查是不是已知的壞案例(比如某個帳號一律回失敗),其餘情況才交給 mock strategy 生成合理的成功回應。
這本質上就是混沌工程(chaos testing)搬進 agent 評估的做法——傳統系統測試怎麼故意注入延遲與錯誤來驗證容錯能力,ADK 現在讓你對 agent 的工具呼叫做同一件事,而且全程離線、可重現、不需要一個真的會故障的後端。
今天處理的是「agent 面對不確定的使用者與不確定的後端會不會照樣正確運作」。明天要處理另一個更嚴肅的問題——如果使用者是惡意的呢?如果工具被拿去做了 agent 開發者從沒授權過的事呢?ADK 的縱深防禦怎麼在身分、guardrail、沙盒執行三個層次上把這件事鎖住。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術