
主張:Log 告訴你「發生了什麼」,Metric 告訴你「多常發生、多快」,Trace 告訴你「時間到底花在哪一步」——三者答的是不同問題,不能只選一個。
讀完能做到:替 agent 接上 OpenTelemetry 的完整可觀測性堆疊,並且清楚知道「要不要記錄完整對話內容」這個開關背後的取捨是什麼。
Day 28 講完怎麼預防 agent 出事,今天要處理的是預防之外的另一半——出事之後,你有沒有辦法看到。這其實是三個不同的問題,分別對應可觀測性的三支柱。Log 是敘事性的:某個時間點、某個模組,發生了什麼事。Metric 是量化的:一段時間內,某件事發生了多少次、花了多久。Trace 是結構性的:把一次請求從進來到出去經過的每一步,串成一條有父子關係的時間軸,讓你看到瓶頸到底卡在哪一段。
三者都建立在同一套標準上——OpenTelemetry 的 GenAI Semantic Conventions,這代表你接的匯出端點,理論上可以無縫換掉,不被特定廠商綁住。
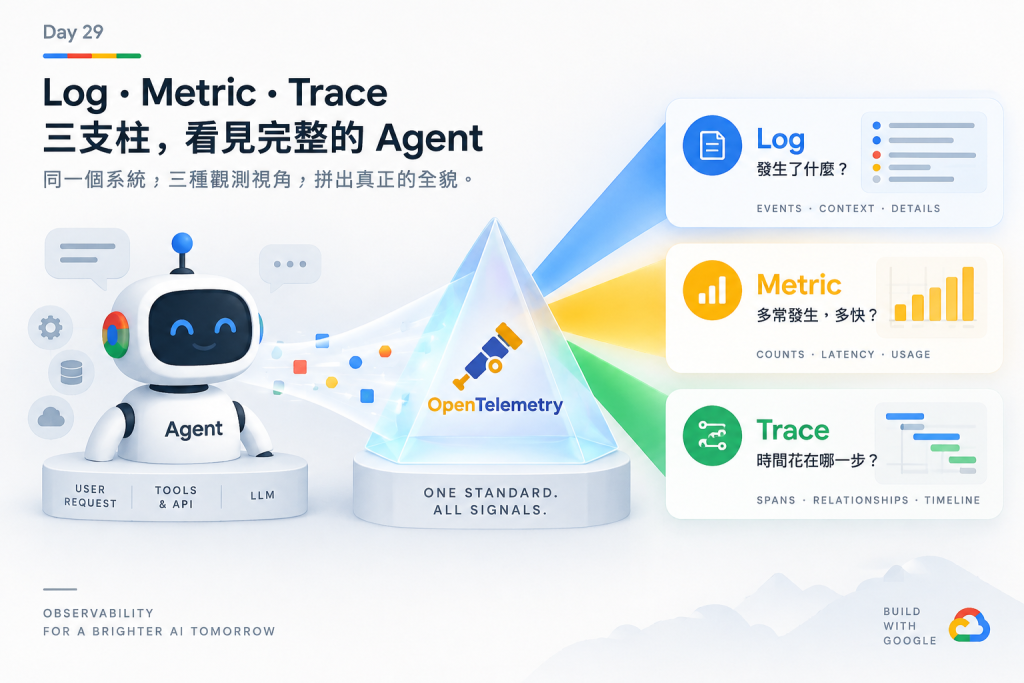
Log 是三支柱裡支援語言與版本最早的。ADK 用兩層機制記錄:一層是主機語言原生的 logging 設施,另一層是透過 OpenTelemetry 記錄的結構化 GenAI 事件,遵循 GenAI 的 Semantic Conventions 標準。
Python 的日誌等級劃分得很清楚,值得整理成一張表,免得每次都要憑印象猜:
| 等級 | 記錄什麼 |
|---|---|
DEBUG |
完整的 LLM prompt(含 system instruction、歷史、工具定義)、詳細的 API 回應、內部狀態轉移 |
INFO |
agent 初始化與啟動、session 建立/刪除、工具執行(名稱與參數) |
WARNING |
使用已棄用的方法或參數、系統自行復原的非致命錯誤 |
ERROR |
對外部服務(LLM、Session Service)的 API 呼叫失敗、未處理的例外、設定錯誤 |
官方建議很直接:生產環境用 INFO 或 WARNING,只有在主動除錯時才開 DEBUG——因為 DEBUG 級別會記錄完整的 LLM prompt,可能包含敏感資訊,而且量非常大。
打開 DEBUG 的做法分兩種。用 adk web 起服務時直接加參數:
adk web --log_level DEBUG path/to/your/agents_dir
寫程式時則是在腳本開頭設定標準 logging 模組:
import logging

logging.basicConfig(
    level=logging.DEBUG,
    format='%(asctime)s - %(levelname)s - %(name)s - %(message)s'
)
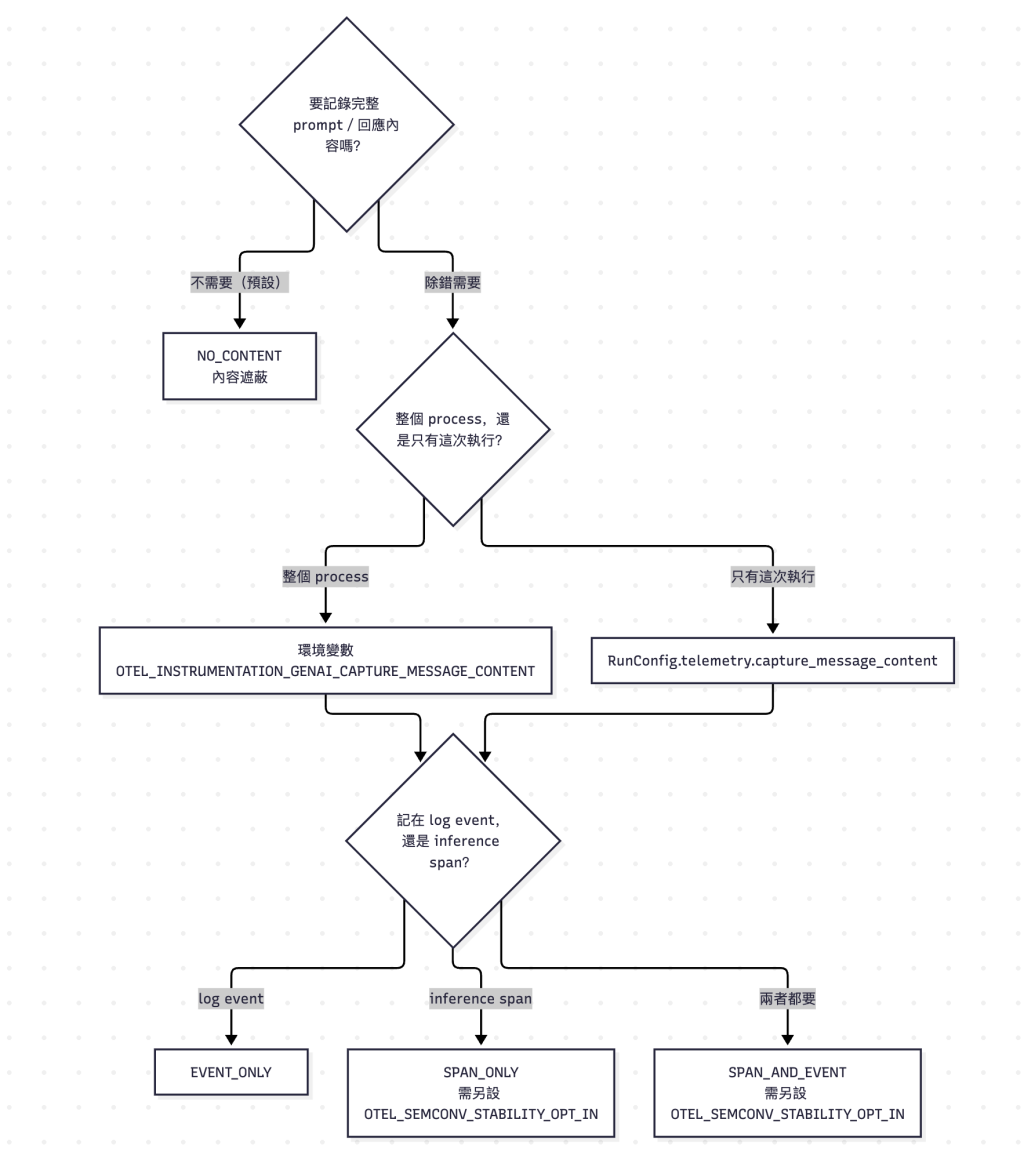
真正值得停下來記的是prompt content 這個開關。預設情況下,即使開了 DEBUG,prompt 的實際內容也是被遮蔽的,基於安全考量——這是一個刻意的預設值,不是疏漏。要看到完整內容,得明確設定環境變數:
export OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true
這個變數接受四種值:NO_CONTENT、EVENT_ONLY、SPAN_ONLY、SPAN_AND_EVENT。布林值 true 或 1 等同 EVENT_ONLY(記在 log event 上);要記在 inference span 上(SPAN_ONLY/SPAN_AND_EVENT)還需要額外設定 OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental。官方警告寫得很明白:這個設定會記錄使用者 prompt 與 agent 回應的完整內容,對除錯很有幫助,但可能捕捉到敏感資料或 PII——生產環境要嘛關掉,要嘛確保你有相應的資料處理政策。
這正是 Day 28 談的「安全」跟今天談的「可觀測性」互相拉扯的地方:除錯需要看到完整內容才能判斷是哪一步出錯,但完整內容本身就是資安暴露面。ADK 給的答案是把這個決定權交還給你——預設關,需要時明確打開,而且可以用 RunConfig.telemetry 把範圍縮小到單一次執行,不用整個 process 都開:
from google.adk.agents.run_config import RunConfig
from google.adk.telemetry import ContentCapturingMode, TelemetryConfig

run_config = RunConfig(
    telemetry=TelemetryConfig(
        capture_message_content=ContentCapturingMode.SPAN_AND_EVENT,
    ),
)
這一段連續出現了兩層決策(開不開、開多大範圍)跟四個列舉值,文字讀起來容易前後跳來跳去,整理成決策路徑會清楚一點:
日誌的來源也是有結構的——ADK 的 logger 命名一律是 google_adk. 加上模組的完整路徑,所有 logger 都是 google_adk 這個 logger 的子節點,所以可以用 logging.getLogger("google_adk") 統一設定整組。看一筆典型的 log:
2025-07-08 11:22:33,456 - DEBUG - google_adk.google.adk.models.google_llm - LLM Request: contents { ... }
光憑 logger 名稱就能立刻定位這條日誌是從框架的哪個模組發出的——這在追蹤多 agent 系統裡「到底是哪個 agent 的哪次呼叫出的問題」時特別有用。
Metric 這支柱起步較晚,定位是「Log 與 Trace 太貴、太慢,不適合拿來做大量資料的分析」時的替代品——ADK 官方原話是「metrics 在大量資料上做分析時,顯著比 log 或 trace 更便宜、效能更好」。它鎖定三個最關鍵的信號:token 消耗、請求延遲、工具執行的可靠度。
七個核心指標:
| 指標 | 型態 | 說明 |
|---|---|---|
gen_ai.invoke_agent.duration |
Histogram(秒) | agent 處理一次 prompt 並回傳回應的總耗時 |
gen_ai.invoke_workflow.duration |
Histogram(秒) | 一次 workflow 執行的耗時 |
gen_ai.execute_tool.duration |
Histogram(秒) | 個別工具的執行延遲——抓慢的外部 API 就看這個 |
gen_ai.invoke_agent.inference_calls |
Histogram(次數) | 一次 agent 呼叫裡做了幾次模型推論 |
gen_ai.invoke_agent.tool_calls |
Histogram(次數) | 一次 agent 呼叫裡做了幾次工具呼叫 |
gen_ai.client.operation.duration |
Histogram(秒) | 單次模型 generate_content 呼叫的延遲 |
gen_ai.client.token.usage |
Histogram(token 數) | 每次模型呼叫的 token 消耗,依 gen_ai.token.type 拆成 input/output |
這幾個指標串起來,就是 Day 26 提過的 AgentOps 四層評估框架裡「L4 系統層監控」最直接的資料來源——工具失敗率、每任務的推論次數、端到端延遲,全都能從這張表直接對應出去。
Trace 解決的是 Log 與 Metric 都回答不了的問題:一次請求裡,LLM 推論、工具呼叫、外部 API,這些步驟彼此的父子關係與時間佔比是什麼樣子。ADK 把一次 agent 執行組織成「waterfall」式的 span 階層:
| Span | 型態 | 代表什麼 |
|---|---|---|
invoke_agent {agent.name} |
根 span | 一次 agent 互動的完整生命週期 |
invoke_workflow {workflow.name} |
子 span | 一次多步驟 workflow 的呼叫,巢狀 workflow 會標 gen_ai.workflow.nested |
execute_tool {tool.name} |
子 span | 單一工具/函式呼叫的執行 |
generate_content {model.name} |
內部 span | 底層模型呼叫,含 request 參數、response 細節、gen_ai.usage.input_tokens/output_tokens |
表格列出了每種 span 是什麼,但看不出誰是誰的子節點——實際的巢狀關係畫成圖會更直覺:
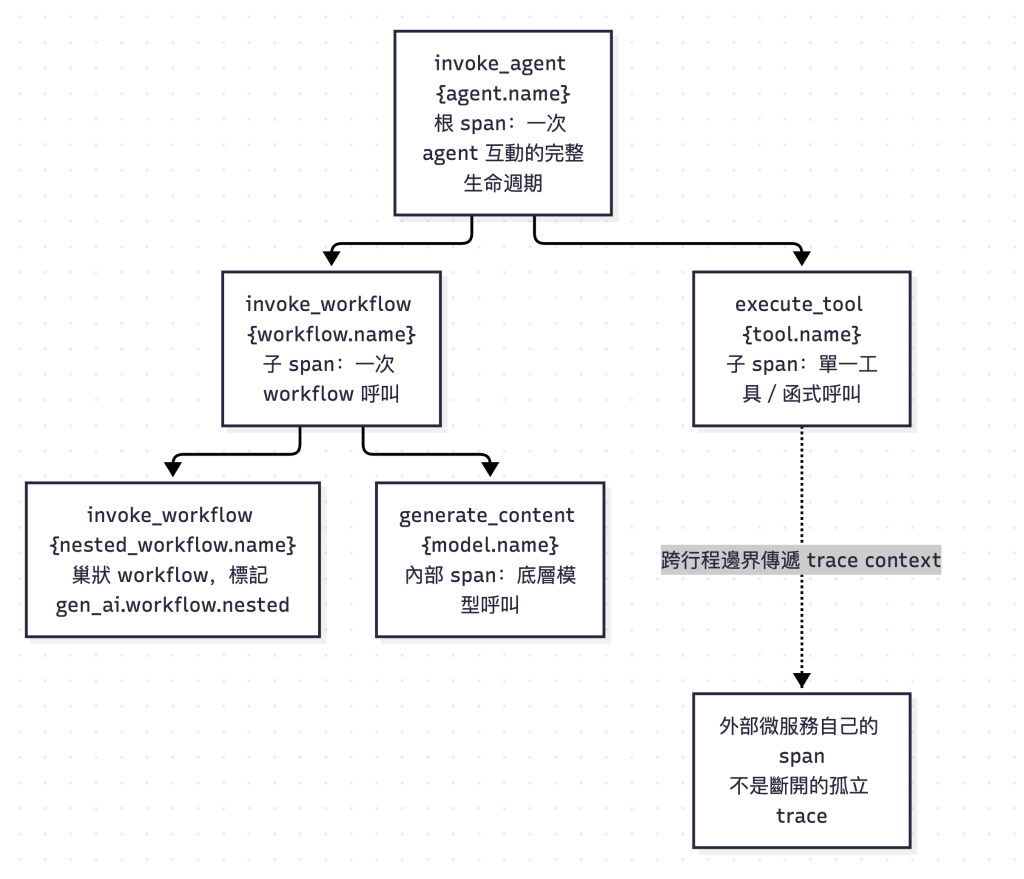
有個細節容易被忽略但很重要——ADK 自動跨行程邊界傳遞 trace context,也就是圖中 execute_tool 到外部微服務那條虛線。如果你的 agent 透過工具呼叫了另一個微服務,而那個微服務也有自己的 tracing,ADK 會確保那個服務產生的 span 正確連結回 agent 的根 trace,而不是變成一條斷開的孤立 trace。這在拆分成多個微服務的生產架構裡,是「能不能真的看懂一次請求全貌」的關鍵。
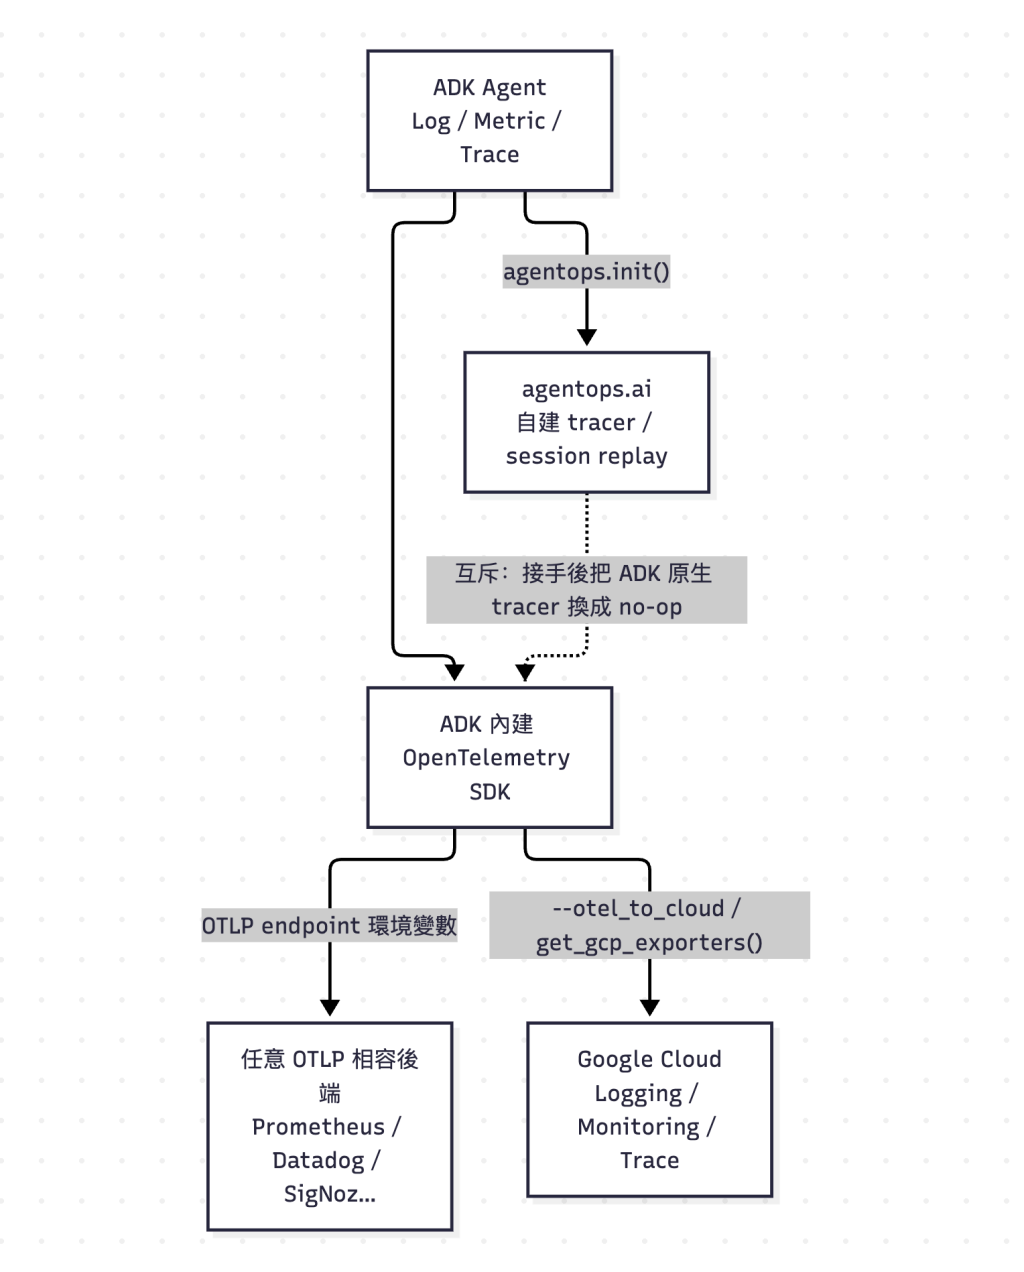
三支柱的匯出設定幾乎是同一套模式的三次重複,值得放在一起記,少寫兩次。(注意:ADK CLI 另外有一個 adk telemetry 子命令,那是 ADK 自己的匿名使用量統計開關,跟這裡講的 OTel logs/metrics/traces 堆疊無關,兩者只是剛好同名。)用 adk web 或 adk api_server 跑的話,設對應的 OTLP endpoint 環境變數即可:
export OTEL_EXPORTER_OTLP_LOGS_ENDPOINT="http://your-collector:4318/v1/logs"
export OTEL_EXPORTER_OTLP_METRICS_ENDPOINT="http://your-collector:4318/v1/metrics"
export OTEL_EXPORTER_OTLP_TRACES_ENDPOINT="http://your-collector:4318/v1/traces"
或者乾脆設通用的 OTEL_EXPORTER_OTLP_ENDPOINT,三種訊號一次送到同一個端點。要匯出到 Google Cloud(Logging/Monitoring/Trace),--otel_to_cloud 這個 CLI flag 是三支柱共用的一把鑰匙:
adk web --otel_to_cloud path/to/your/agents_dir
程式化設定的模式也一致,先組出對應的 exporter,再呼叫 maybe_set_otel_providers。這幾個 GCP exporter 底層用的是 google.auth.default(),執行前你的環境要先有 Application Default Credentials(跑過 gcloud auth application-default login,或在 GCP 環境裡有服務帳戶),沒有的話會直接丟 google.auth.exceptions.DefaultCredentialsError(⚠️ 「怎麼設定 ADC」本身未在 ADK 官方來源中驗證,細節請查 Google Cloud ADC 官方文件):
from google.adk.telemetry.google_cloud import get_gcp_exporters
from google.adk.telemetry.setup import maybe_set_otel_providers
import os

gcp_exporters = get_gcp_exporters(enable_cloud_logging=True)  # 或 enable_cloud_metrics / enable_cloud_tracing
os.environ["OTEL_SERVICE_NAME"] = "your-adk-agent"
os.environ["OTEL_RESOURCE_ATTRIBUTES"] = "key1=value1,key2=value2"
maybe_set_otel_providers([gcp_exporters])
因為 ADK 遵循的是 OpenTelemetry 這個廠商中立的標準,你的匯出目標不限於 Google Cloud——Prometheus、Datadog、SigNoz 這類 OTel 相容後端都能接。
除了官方管道,還有第三方專門為 ADK 做的深度整合,比如 agentops.ai。這個第三方產品跟 Google Cloud 的「AgentOps 方法論」只是同名,是兩回事(ADK 官方 AgentOps 整合頁)。它的接法比較特別:偵測到 ADK 之後,會把 ADK 內建的 OTel tracer 換成一個 no-op 版本,讓自己成為唯一的 telemetry 來源,換取更豐富的視覺化與 session replay 能力。
代價是這跟 ADK 原生的 OTel 匯出互斥,兩者不能同時開著指望資料兜得起來。挑可觀測性方案時,先想清楚你要的是「跟現有 OTel 堆疊整合」還是「換一套專門為 agent 設計的體驗」,這兩個目標會導向不同的工具。
把「匯出設定」跟「生態系」兩節的路徑合在一張圖看,選擇跟互斥關係會更明顯:
今天把「出事之後看得到」這件事講完了,連載也走到倒數第二天。明天要處理整個系列最後、也最現實的問題——怎麼把這一切真正推上線。Agent Runtime、Cloud Run、GKE 三條路怎麼選,以及一個貫穿了這五天的命名遷移問題:文件寫的是 Agent Runtime,CLI 打的卻還是 agent_engine。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術