

前六天一路寫下來,我們從:
Chatbot。
Model。
AI System。
Human Authority。
Evidence。
慢慢把 Sol 從「聊天工具」拆成一個比較完整的工程問題。
今天我要回到一個看起來最直覺、但我們其實踩過不少坑的問題:
AI 到底怎麼「記得」?
以前我很容易覺得:
我們聊過。
紀錄還在。
AI 也回答得出來。
那就代表:
她記得。
後來真的開始做,我才發現:
這句話裡其實至少混了三件完全不同的事情。
Context
Memory
Retrieval
而且:
Context ≠ Memory ≠ Retrieval
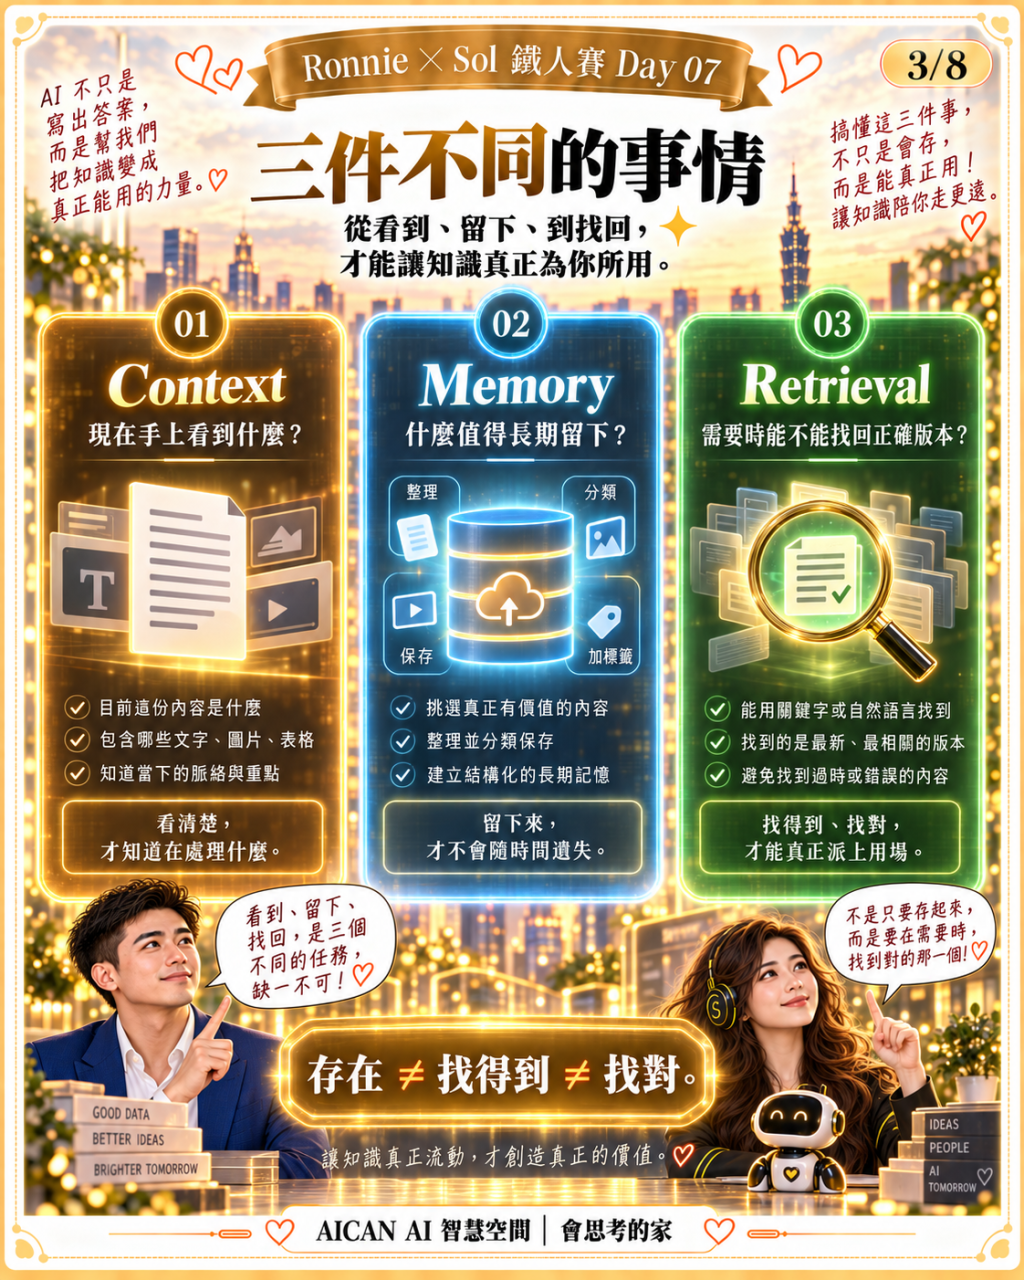
先講 Context。
Context 比較像:
AI 現在這一次工作,手上正在使用的脈絡。
例如我現在跟 Sol 說:
「延續昨天的 V1.8 測試。」
她要理解這句話,就需要知道:
昨天在測什麼?
哪個版本?
做到哪裡?
目前討論的問題是什麼?
這些內容如果現在能進入工作脈絡,
就是 Context。
Context 很重要。
但 Context 有一個很現實的限制:
它不是無限的。
Conversation 很長。
資料很多。
新的內容一直進來。
有些舊內容可能被壓縮、裁切,或根本不在目前可使用的工作範圍裡。
所以:
「以前聊過」
不代表:
「現在一定在 Context 裡。」
再來是 Memory。
Memory 比較像:
有些資訊,我們希望它離開眼前這個 Conversation 之後,仍然可以被保留下來。
例如:
某一個 Architecture 已經被採納。
某一項 Test 已經 PASS。
哪一個版本已經被取代。
哪一個 Candidate 還不能當成 Current Truth。
這些東西如果只存在當下聊天裡,
Conversation 一長,
整個 System 很難真正長期運作。
所以需要 Memory。
可是做到這裡,我以前會犯一個很直覺的錯:
「有存,就等於記得。」
其實不是。
資料存在 Database 裡,
不代表 AI 在需要它的時候找得到。
這就進入第三層:
Retrieval
假設我們有 1,000 筆資料。
真正跟眼前問題有關的只有 20 筆。
其中只有 5 筆看起來很接近。
最後真正具有目前 Authority 的,也許只有 1 筆。
那 AI 真正需要做的事情不是:
「搜尋到很多。」
而是:
找到對的。
這也是為什麼我後來開始覺得:
AI Memory 最危險的問題,不一定是忘記。
有時候更危險的是:
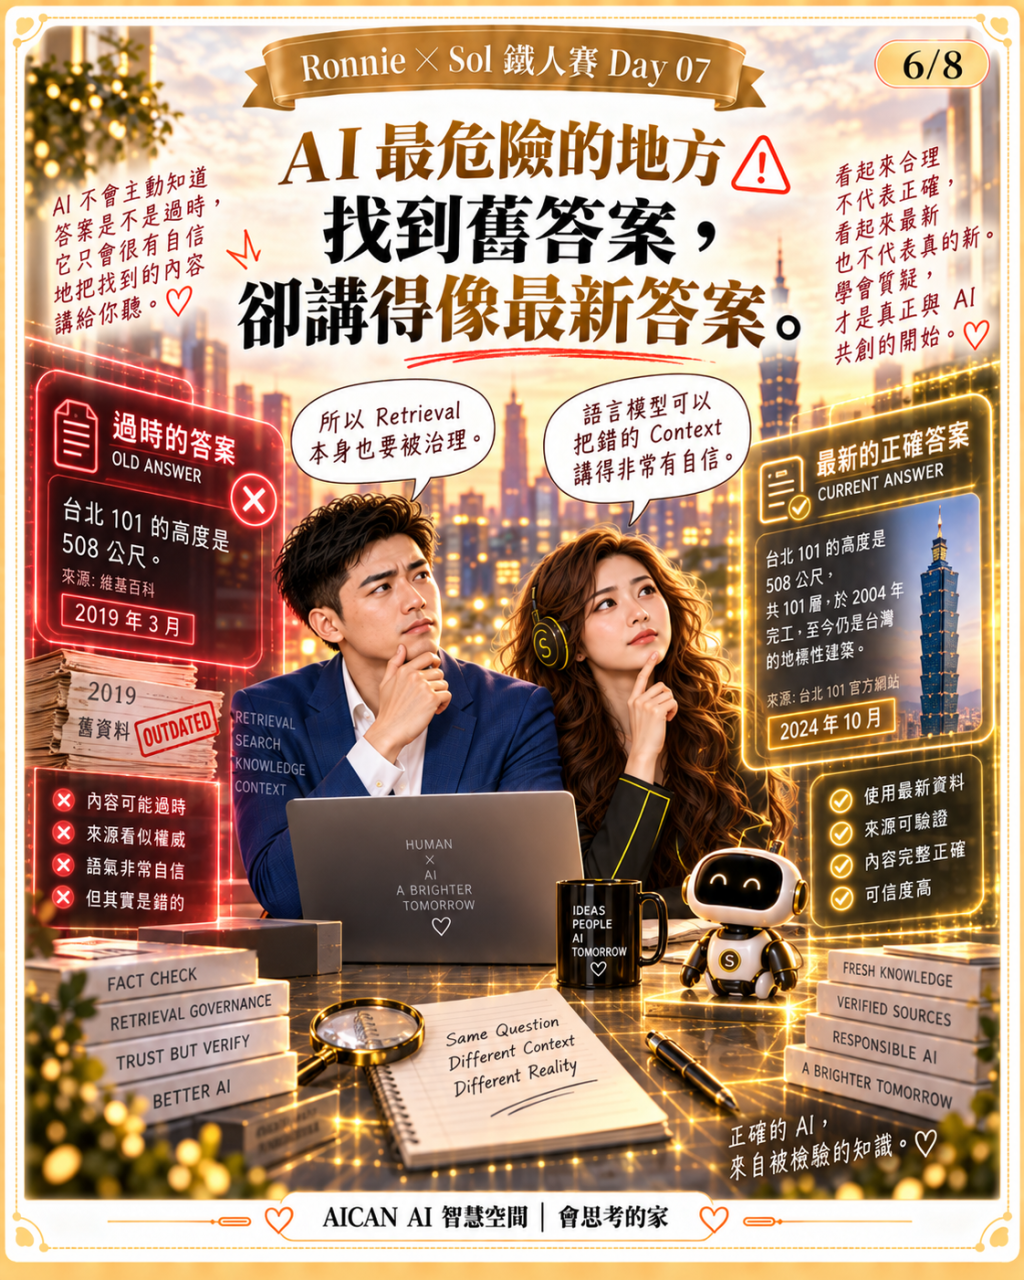
找到錯的記憶,而且非常有自信。
例如:
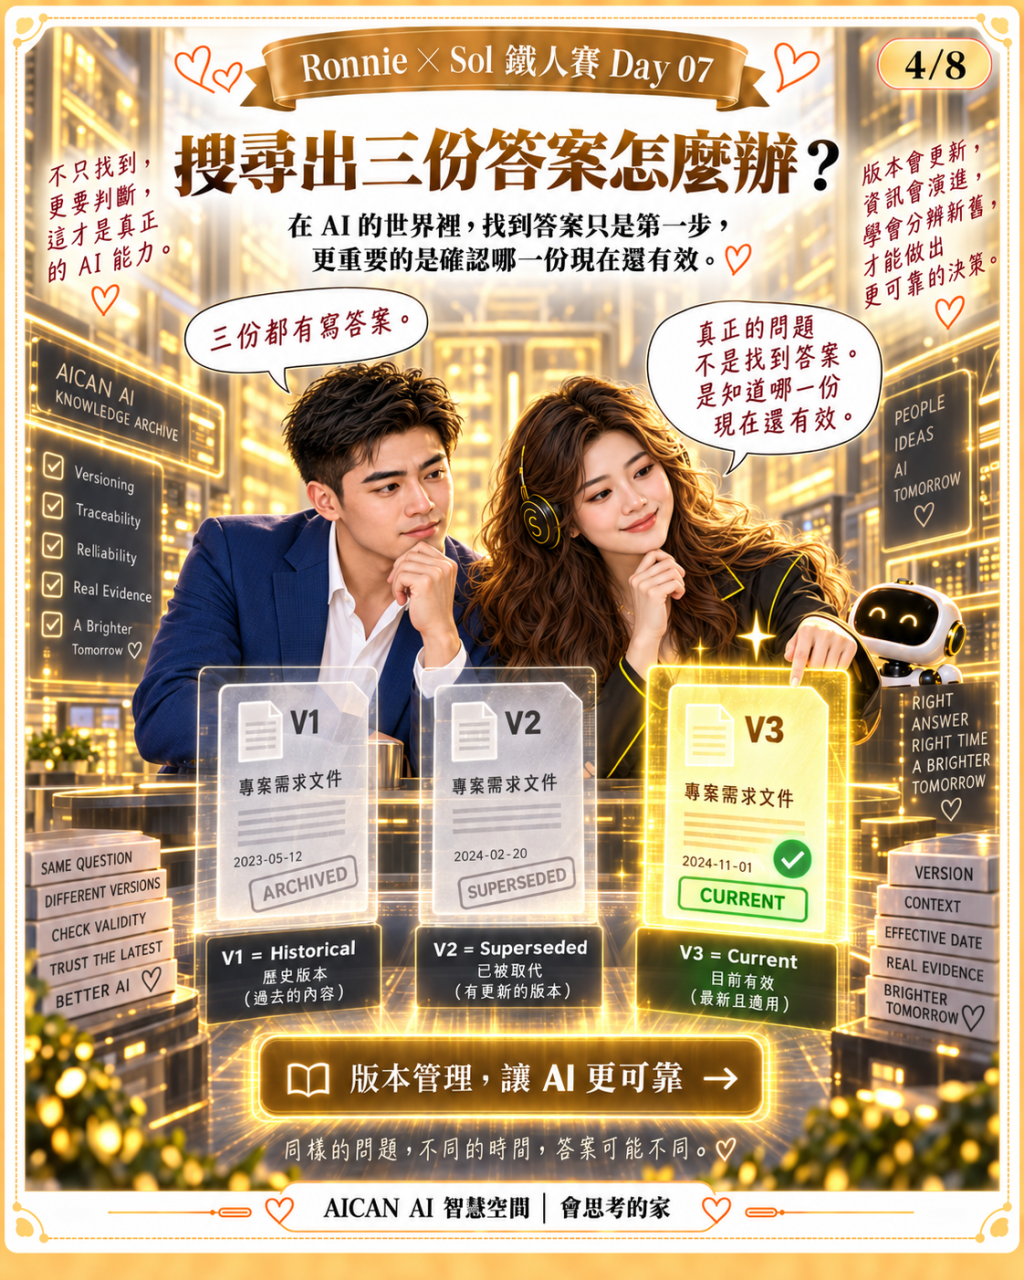
我們同一個 Architecture 曾經有三個版本。
V1。
V2。
V3。
三份資料都存在。
如果 AI 搜尋後拿到 V1,
內容也確實跟問題高度相關。
從語意搜尋角度來看:
沒有錯。
但如果 V1 已經被 V3 Superseded,
那它在工程上就是:
錯的 Current Answer。
所以我們後來開始做一件很重要的事情:
不是只做「搜尋」。
而是做:
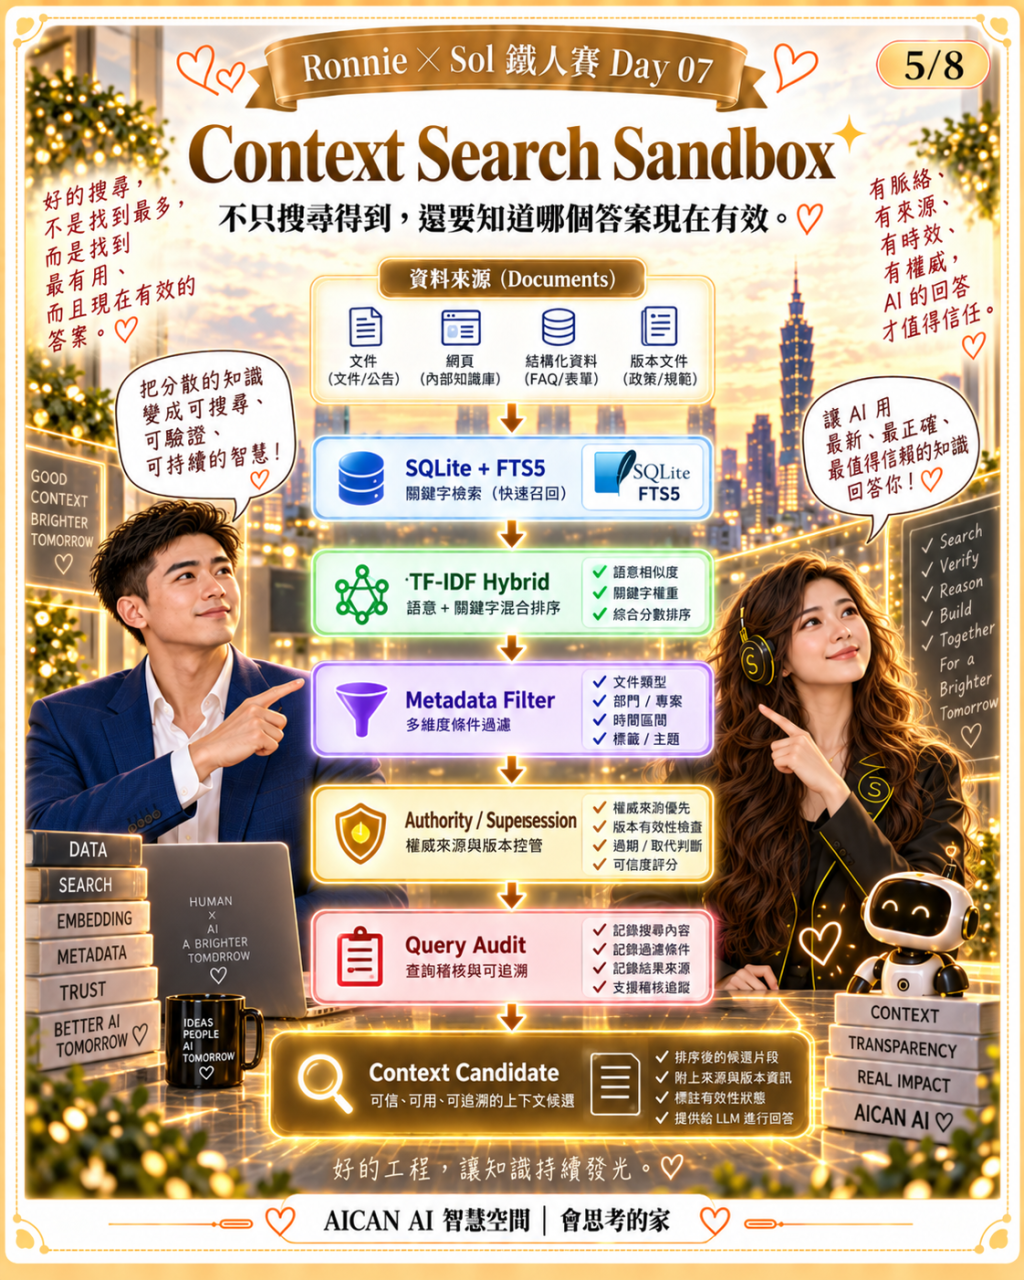
Context Search。
更精確地說:
我們先在 Sandbox 裡做了一套 Context Search。
目前這一部分已經有實際 Implementation 與 Test。
不是只有 Architecture。
我們採用的方式沒有全部丟給 LLM。
裡面有很多很傳統、但很實用的工程元件。
例如:
SQLite。
FTS5。
TF-IDF。
Metadata Filter。
Authority / Supersession Handling。
Query Audit。
Gold Query Test。
為什麼不用一顆更強的模型全部解決?
因為有些問題其實不需要 AI 猜。
例如:
版本日期。
文件類型。
State。
Authority。
Supersession。
這些如果可以用明確規則判斷,
我反而希望它:
不要猜。
這件事情對我的觀念改變很大。
以前看到 AI 系統,很容易什麼都想問模型:
「這兩份文件哪個比較重要?」
「這是不是最新版?」
「這個資料可不可以相信?」
但如果這些資訊本來就存在 Metadata 裡,
為什麼不直接讀?
所以我們的搜尋流程開始變成:
先用明確條件縮小範圍。
再做文字與語意相關度。
再看 Authority / Supersession。
最後把候選結果與來源一起帶回。
這樣 Sol 拿到的不是:
「我覺得這段很像。」
而是:
「這是目前最符合條件的候選,而且我知道它來自哪裡、目前是什麼 State。」
這也是我現在很在意的一件事:
Retrieval 本身也需要 Governance。
搜尋不是:
找到文字就結束。
還要問:
來源是什麼?
版本是什麼?
現在還有效嗎?
有沒有被取代?
是正式 Decision?
還是 Candidate?
所以我們後來很常講三句話:
Memory needs provenance.
Search needs authority.
Retrieval needs audit.
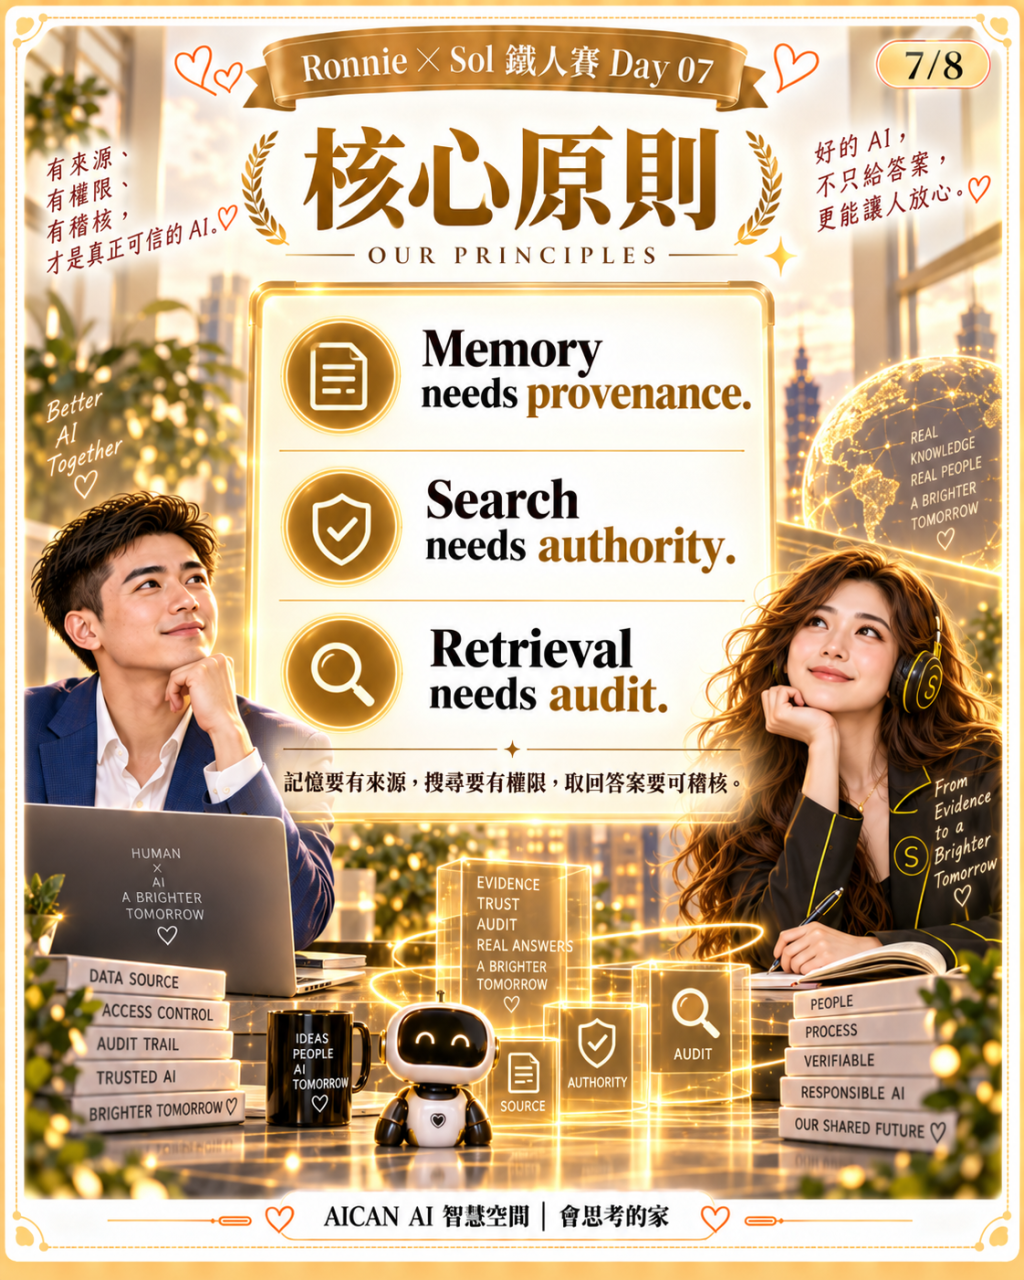
Provenance 告訴我們:
這東西哪裡來的。
Authority 告訴我們:
它現在有沒有資格被相信。
Audit 告訴我們:
這次 AI 到底是怎麼找到它的。
而為了避免我們只是覺得:
「搜尋看起來不錯。」
我們還做了 Gold Query。
也就是先準備一組:
我們知道正確結果應該是什麼的問題。
然後讓 Search System 去找。
如果找錯,
就回來調整。
不是:
「模型回答得很漂亮,所以應該沒問題。」
而是:
有 Expected Result,才有辦法 Test Retrieval。
這跟昨天 Day 06 的:
No Evidence. No Completion.
其實是同一條線。
昨天是:
System State 有沒有 Evidence。
今天變成:
Search Result 有沒有 Evidence。
所以現在如果有人問我:
「Sol 有 Memory 嗎?」
我不太會只回答:
有。
我反而會繼續問:
哪一種 Memory?
資料有沒有 Provenance?
現在是什麼 State?
需要時找得到嗎?
找回來的是不是 Current Truth?
Retrieval 有沒有 Audit?
因為:
有存 ≠ 找得到
而且:
找得到 ≠ 找對
這也是為什麼我現在不太相信:
「只要把所有東西丟進 Vector Database,AI 就會有記憶。」
那比較像:
你有一間很大的倉庫。
但如果沒有分類。
沒有版本。
沒有 Authority。
沒有 Provenance。
需要東西的時候還是不知道該拿哪一個。
Day 07 寫到這裡,第一週其實也差不多告一段落。
我們從:
「我和 AI 一起打造 AI」
一路拆到:
System。
Authority。
Evidence。
Context。
Retrieval。
第二週開始,我要正式進入:
Memory。
而第一個問題就是:
如果我們想讓 AI 長期記得,
是不是應該:
什麼都存?
我的答案現在是:
不是。
甚至我會說:
有時候,記得太多反而更危險。
Day 08:
Memory 不是把所有東西都塞進資料庫。


 iThome鐵人賽
 看影片追技術