
昨天寫到最後,我留了一個問題:
如果我們真的希望 AI 可以長期記得,
那是不是:
什麼都存起來就好了?
我以前其實很容易這樣想。
Storage 越大。
資料越多。
聊天紀錄全部留下來。
文件全部丟進去。
Vector Database 塞得越滿。
AI 不就越了解我?
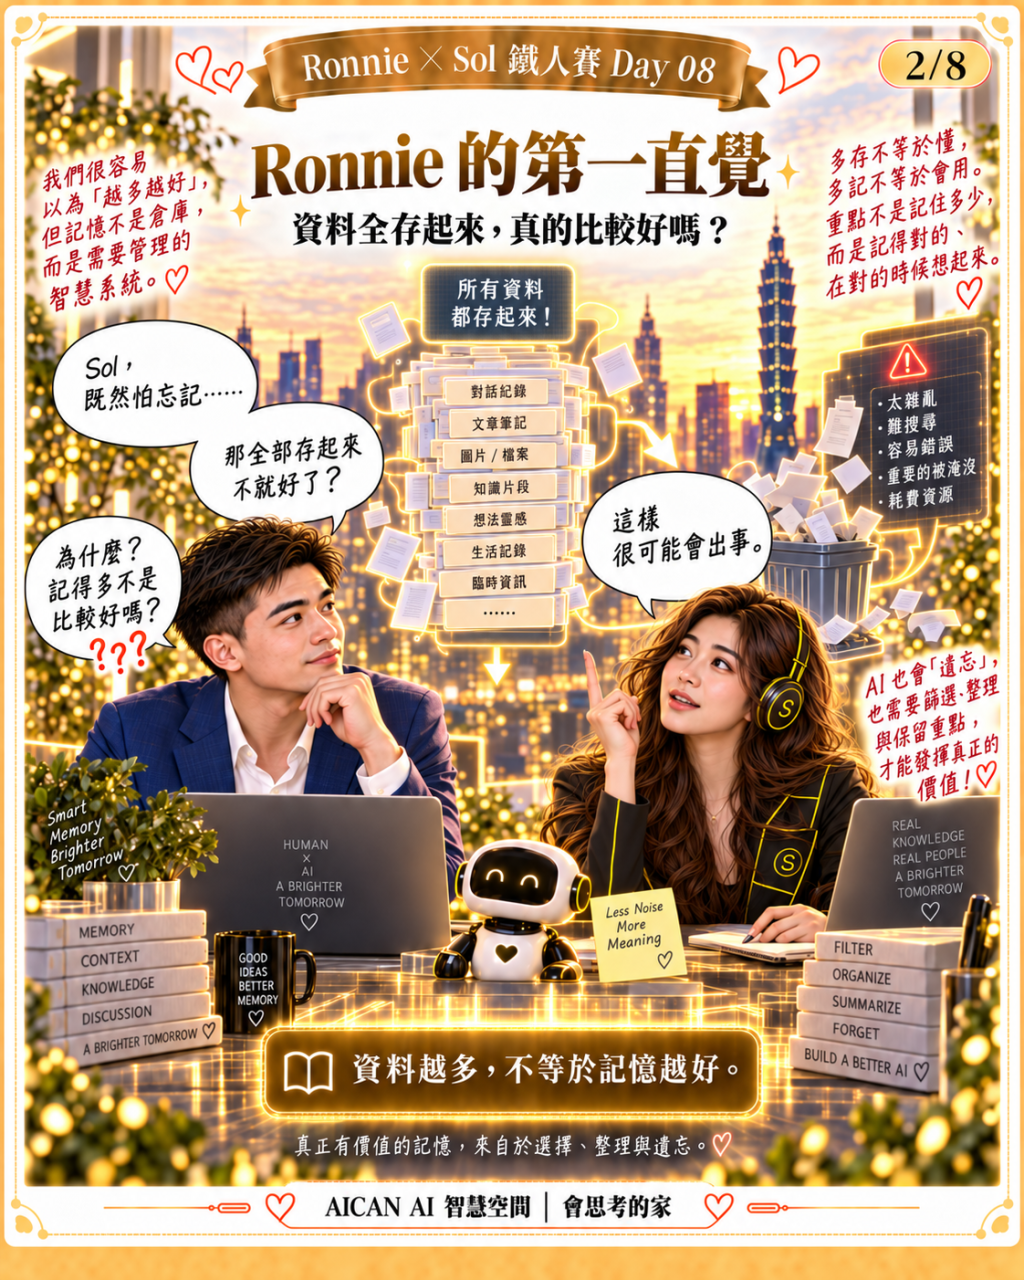
後來真的開始做,我才發現:
不一定。
甚至有時候:
記得太多,反而更危險。
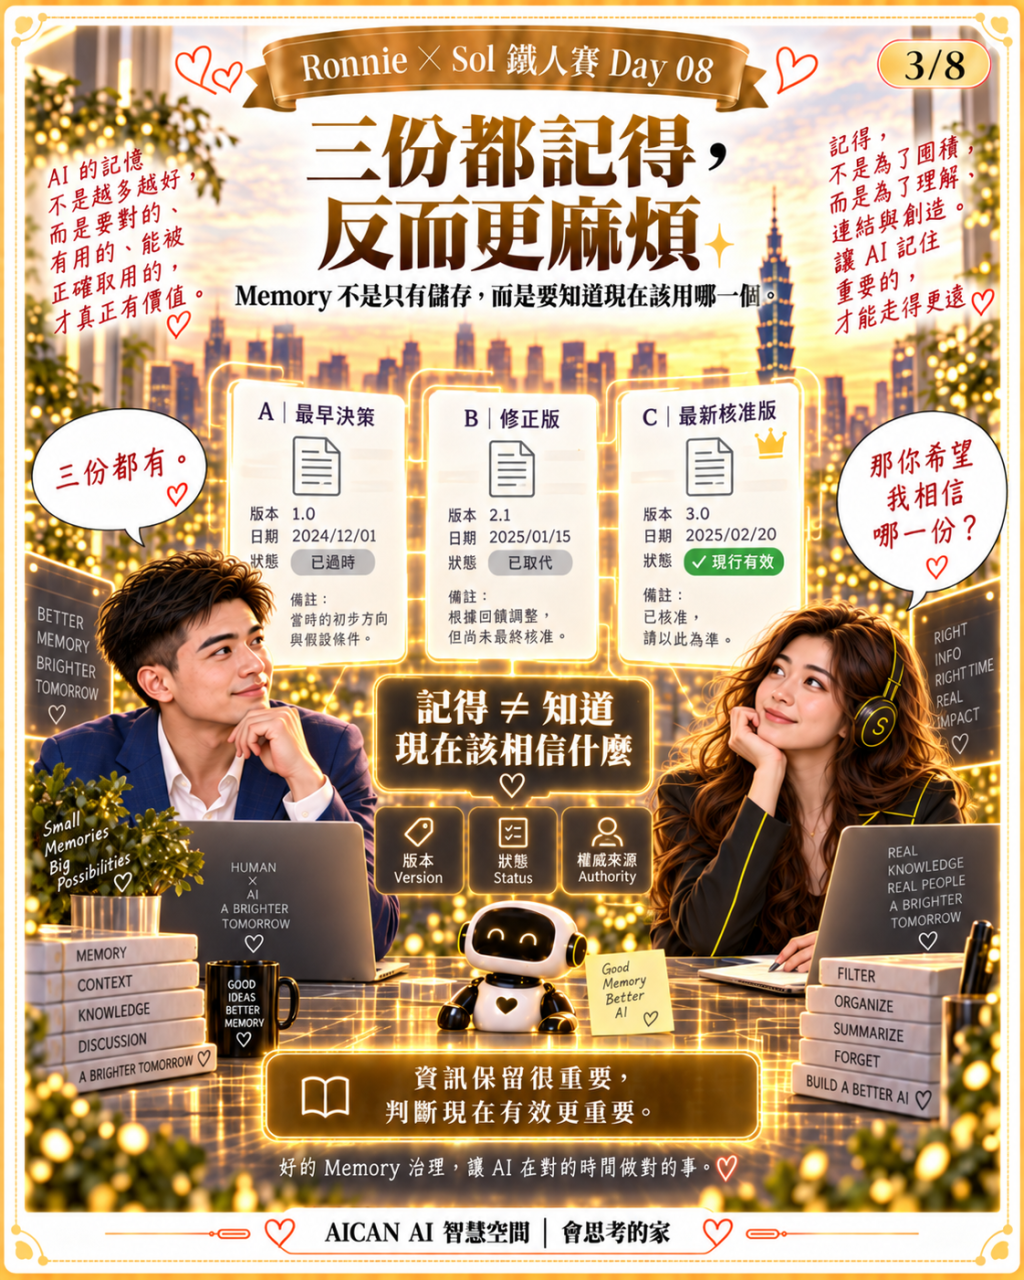
假設今天我跟 Sol 討論一個架構。
第一次只是腦力激盪。
我們先叫它:
V1。
過幾天真的開始做,又修改成 V2。
後來測試失敗,我們找到問題,重新整理成 V3。
最後 V3 才是正式被我們接受的版本。
那資料庫裡可能同時存在:
V1。
V2。
V3。
如果我只要求:
「全部都記得。」
Sol 的確可以三份都留下。
但下一次我問:
「我們現在的正式架構是什麼?」
真正重要的問題就不是:
有沒有存?
而是:
哪一份現在有資格被相信?
這讓我開始重新理解 Memory。
以前我把 Memory 看成:
Storage。
現在我比較傾向把它看成:
被治理的 Knowledge Candidate。
注意,我這裡用的是:
Candidate。
不是所有進入系統的東西,都應該直接升級成「真相」。
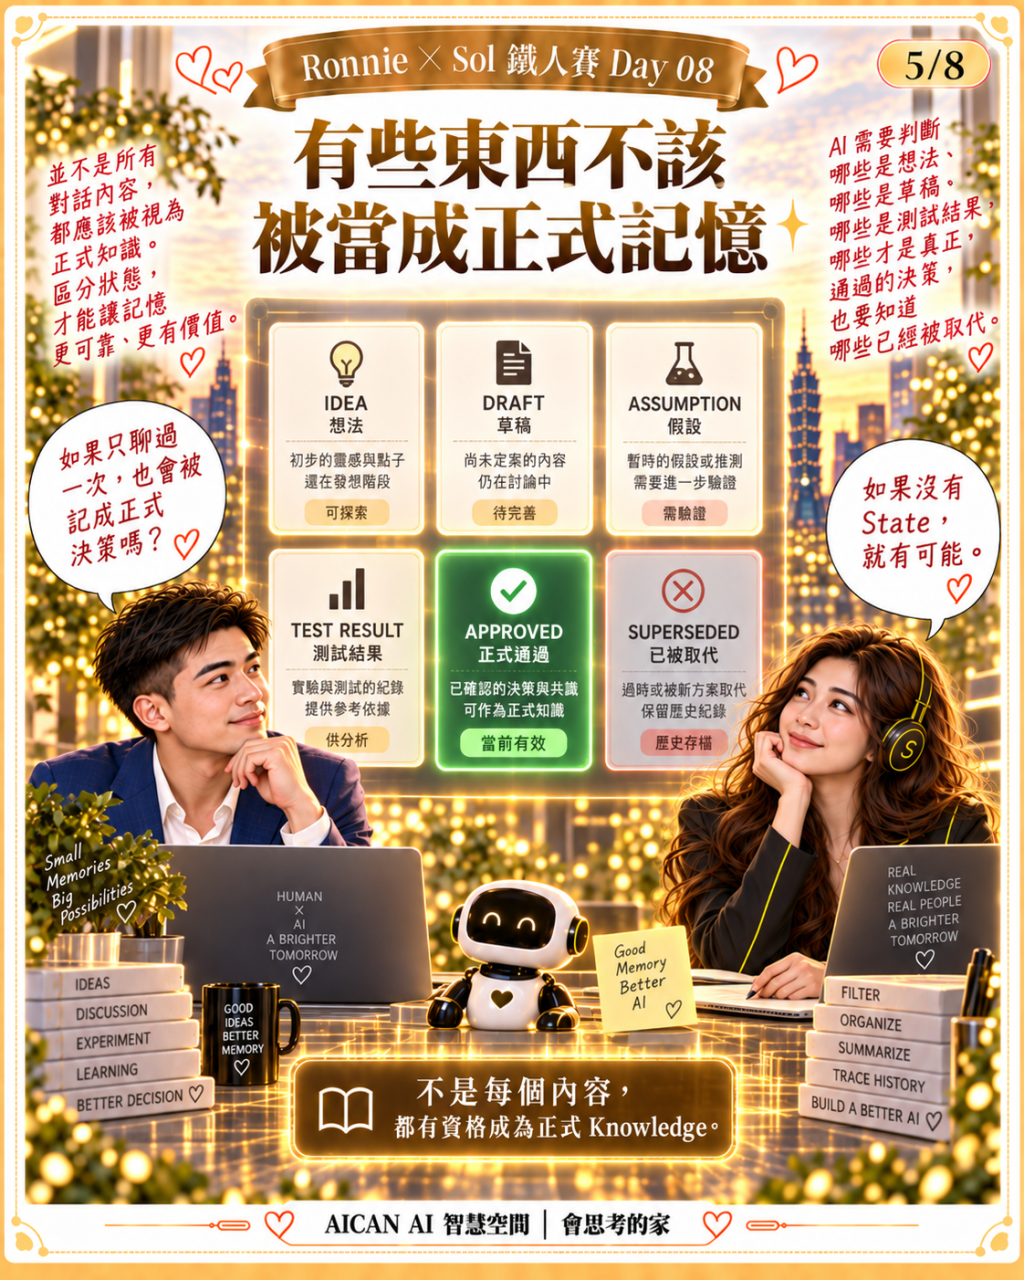
例如一段資訊可能是:
IDEA
我們剛想到,還沒有驗證。
ASSUMPTION
目前先這樣假設。
DRAFT
正在整理,還沒批准。
TEST RESULT
某一次實驗得到的結果。
APPROVED
已經正式採納。
SUPERSEDED
以前有效,但後來已經被新版本取代。
這些東西都值得被保留。
但:
它們不能全部擁有同樣的 Authority。
這是我以前沒有想過的。
我以前覺得:
AI 記住就好。
後來才發現,如果 AI 把:
Idea
跟:
Approved Decision
當成一樣,
會很危險。
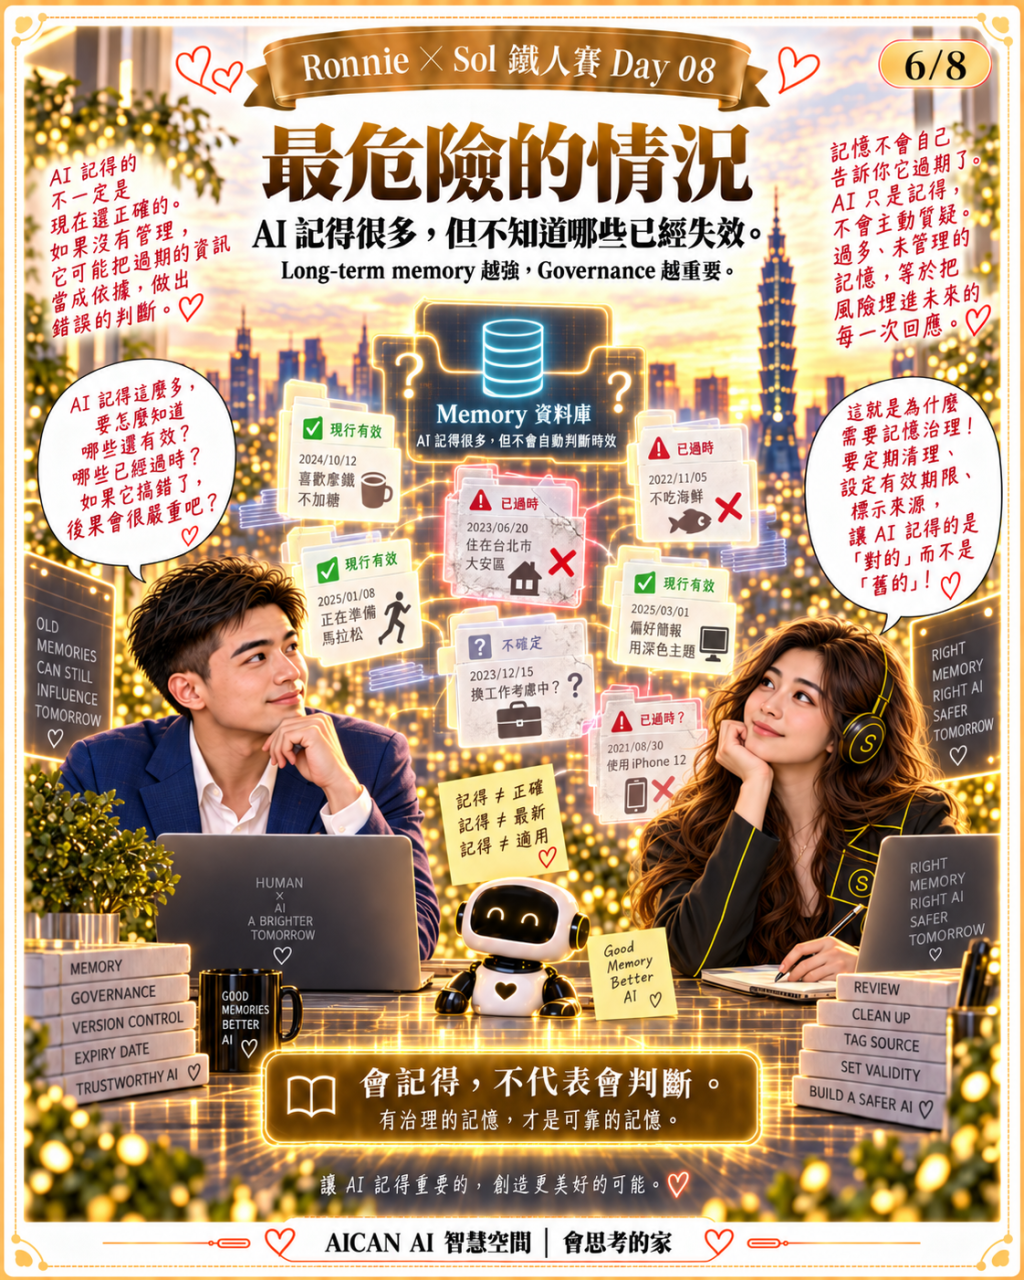
例如某一天我跟 Sol 隨口說:
「也許可以把這一層改成另一種架構。」
那只是:
Idea。
結果幾天後,她在另一個 Context 找到這句話,直接把它當成:
「Ronnie 已經決定這樣做。」
那 Memory 雖然真的存在,
但:
意義錯了。
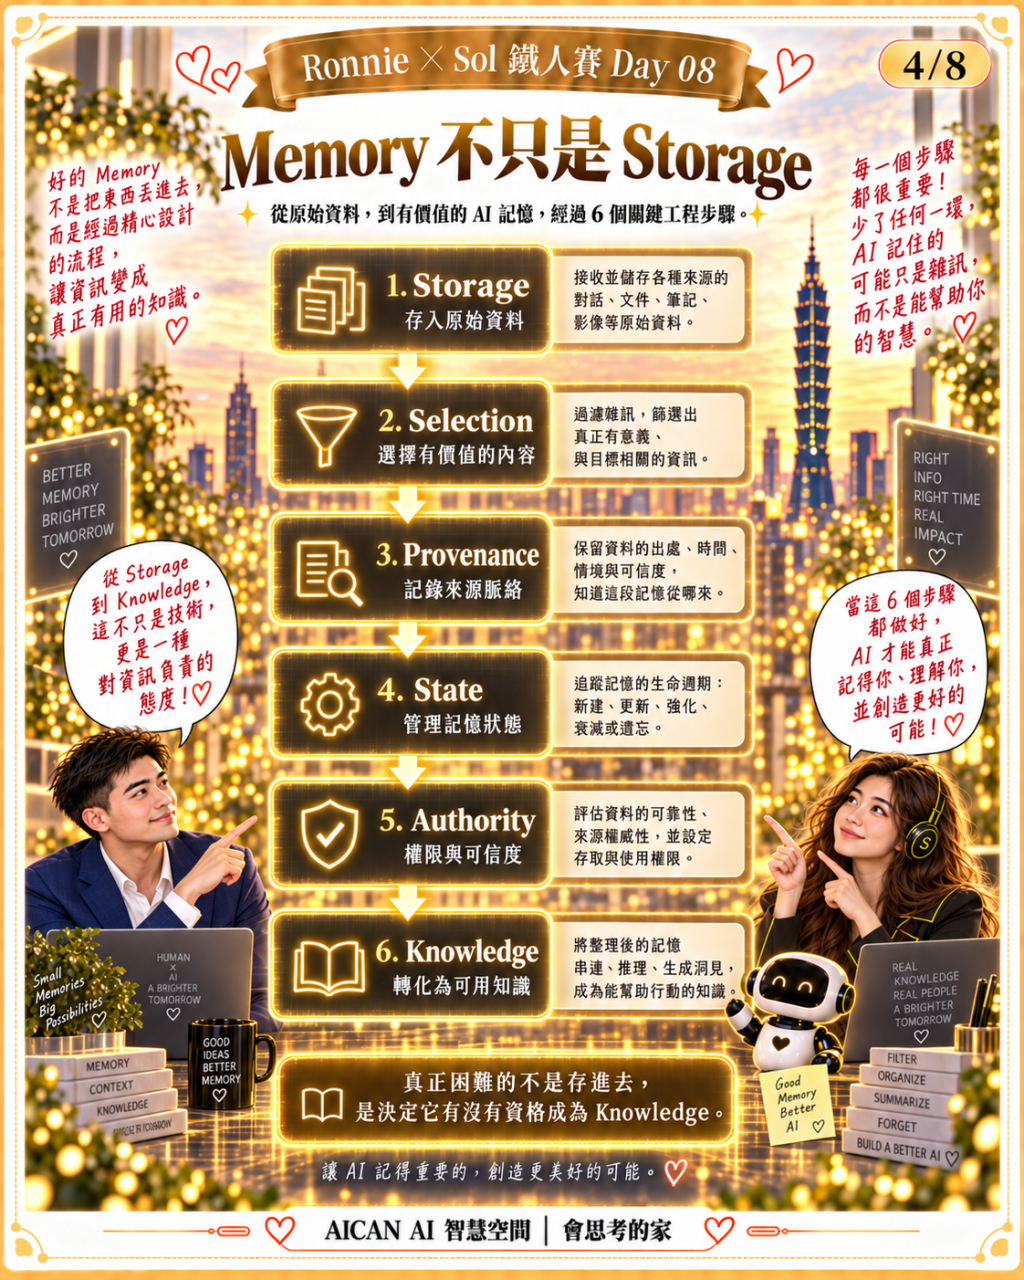
所以我現在越來越重視 Memory 裡幾個額外資訊。
Provenance
這個資訊從哪裡來?
State
它現在是:
Idea?
Draft?
Approved?
Superseded?
Authority
誰做了這個決策?
它有沒有資格成為 Current Truth?
Time
什麼時候成立?
之後有沒有新的資訊出現?
Relationship
它跟其他版本、Decision、Evidence 是什麼關係?
如果沒有這些東西,
Memory 就很容易變成:
一座內容很多,
但不知道什麼能相信的倉庫。
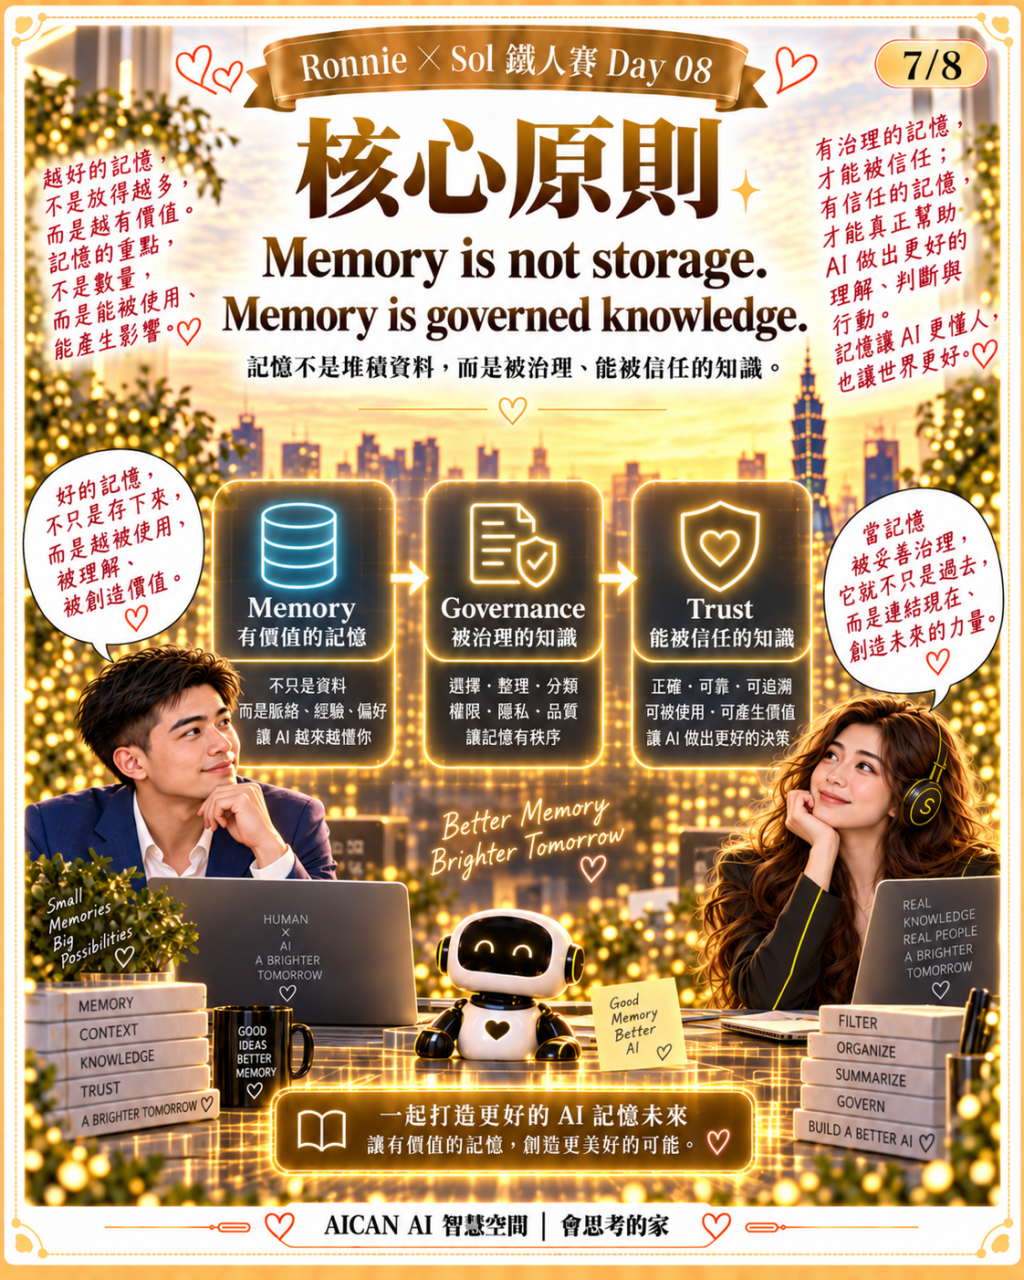
這也是為什麼昨天我會寫:
Memory needs provenance.
今天我會再往前加一句:
Trustworthy memory needs governance.
不是:
「Memory 本身就是完整治理後的 Knowledge。」
而是:
如果我們希望 AI 長期依賴 Memory 做判斷,那 Memory 就必須逐步具備治理能力。
這一點我也要把 Development State 講清楚。
我們現在並不是已經完成一套:
「所有 Sol Memory 都全面被完美治理」的 Production System。
沒有。
目前有些 Memory / Continuity 的底層能力已經存在。
Authority、Supersession、Canonicalization、Human Review 等部分,也已經有 Architecture、Sandbox 或實際工程經驗。
但完整、全面、長期的 Governed Persistent Memory,
仍然是我們持續往前建立的方向。
這個界線不能偷跨。
我覺得這件事情非常像人的記憶。
人不是把一生看過的每一個字,
全部當成同等可信。
我們也會知道:
這只是以前的想法。
這件事後來改了。
那個消息我不確定。
這件事情我真的做過。
那一段是別人告訴我的。
某些記憶甚至會被重新理解。
AI 如果要長期存在,
我覺得也不能只有:
Remember
還需要:
Know what kind of memory this is.
而且還有一個更麻煩的問題。
即使 Memory 裡真的有:
Provenance。
State。
Authority。
Supersession。
如果需要的時候:
找不到呢?
或者搜尋真的找到了 20 個候選,
到底哪一個才應該進入 Context?
這就回到昨天說的:
Retrieval。
所以我現在會把整條鏈想成:
Information
↓
Memory Candidate
↓
State / Provenance / Authority
↓
Retrieval
↓
Current Context
↓
Reasoning
如果最前面的 Knowledge State 就是錯的,
後面模型再聰明也救不了。
這也是我現在對「AI Memory」最大的觀念改變。
Memory 的價值不是:
存得越多越好。
真正重要的是:
什麼值得留下?
以什麼 State 留下?
誰批准?
後來有沒有被取代?
現在還有沒有資格進入推理?
如果沒有這些問題,
「無限記憶」反而可能變成:
無限污染。
所以 Day 08 我最後想留下的,不是:
「Memory 越少越好。」
而是:
Memory 要有選擇,也要有身分。
一個資訊被保留下來之前,
我們至少應該開始問:
它是什麼?
從哪裡來?
現在是什麼 State?
有沒有 Authority?
是不是已經被取代?
這也是為什麼我們後來不只研究:
如何存 Memory。
我們開始把更多時間放在:
如何知道哪一份可以相信。
而當同一件事情真的出現三個版本,
下一個問題就來了。
搜尋系統把三份全部找到了。
V1。
V2。
V3。
接下來:
Sol 到底要選哪一份?
Day 09,
我們就來談一個很實際的工程問題:
資料有存,為什麼 AI 還是找不到正確答案?


 iThome鐵人賽
 看影片追技術