
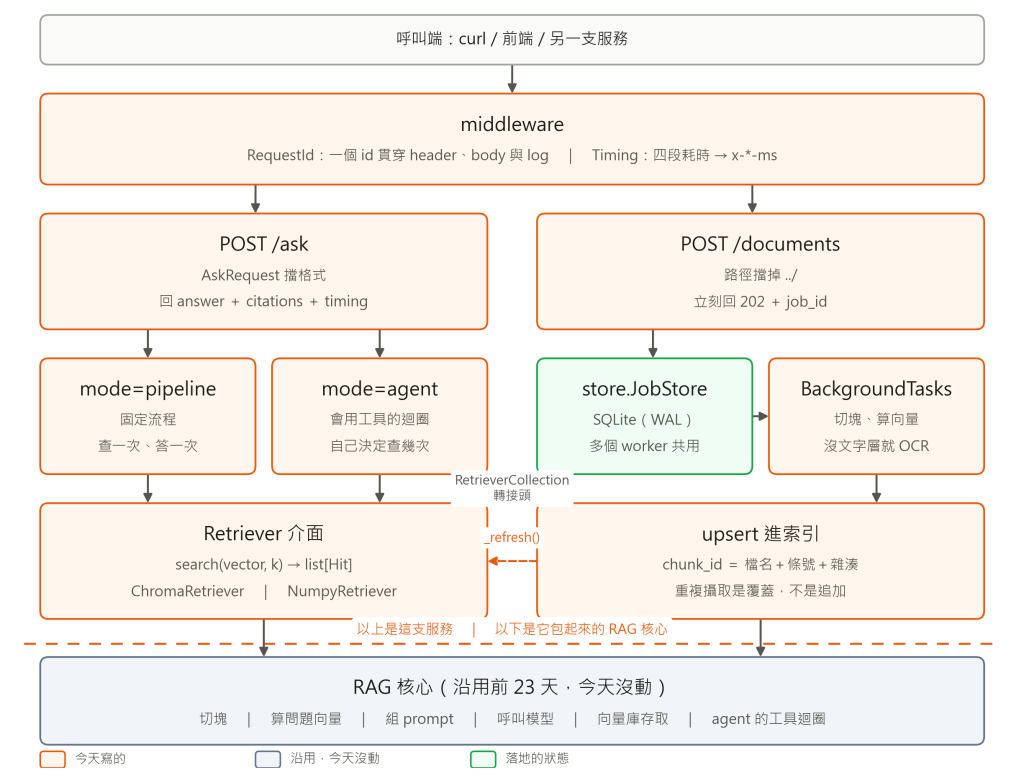
Day 24 服務架構圖:最上面是呼叫端,往下經過 middleware(RequestId 與 Timing),分成 POST /ask 與 POST /documents 兩條路。/ask 再分成 mode=pipeline 與 mode=agent,兩條都從同一個 Retriever 介面出去,介面底下是 ChromaRetriever 與 NumpyRetriever。/documents 立刻回 202,job 狀態存在 SQLite,慢的攝取在 BackgroundTasks 裡做,做完 upsert 進索引並回呼 _refresh() 重建 retriever。中間一條橘色虛線把圖切成兩半,虛線以下是被這支服務包起來的 RAG 核心:切塊、算問題向量、組 prompt、呼叫模型、向量庫存取、agent 的工具迴圈
端點:
| 方法 | 路徑 | 做什麼 | 回什麼 |
|---|---|---|---|
| POST | /ask |
問一題,mode 選固定流程或 agent |
answer、citations、usage、timing |
| POST | /documents |
收一份文件,攝取丟背景 | 202 + job_id |
| GET | /documents/{id} |
查攝取進度 | queued/running/done/failed |
| GET | /documents |
最近的攝取紀錄 | job 列表 |
| GET | /healthz |
行程活著嗎 | 永遠 200,附索引塊數與快取狀態 |
| GET | /readyz |
可以收流量了嗎 | 索引建好回 204,沒好回 503 |
模組:
| 檔案 | 行數 | 做什麼 | 在哪篇 |
|---|---|---|---|
contracts.py |
140 | 請求與回應的 Pydantic 模型 | 這篇 |
config.py |
65 | 設定,全部吃 DAY24_* 環境變數 |
這篇 |
errors.py |
117 | 統一的錯誤形狀 + request id | 這篇 |
retrievers.py |
110 | Retriever 介面與兩個實作 |
這篇 |
embedder.py |
50 | 算問題向量,走快取或真的打 API | 這篇 |
agents.py |
130 | 把會用工具的 agent 接進來 | 這篇 |
main.py |
284 | app、lifespan、六個端點 | 兩篇 |
ingest.py |
85 | 攝取的讀檔、切塊、狀態機 | 下篇 |
store.py |
135 | 攝取 job 的狀態,存 SQLite | 下篇 |
cache.py |
81 | 把 rag_core 的檔案快取換成常駐版 |
下篇 |
timing.py |
131 | 把一次請求拆成四段計時 | 下篇 |
contracts.py:請求與回應長什麼樣唯一一個別人需要讀的檔案。前 23 天的「契約」是一個 dict,加上我自己記得欄位叫什麼。
class AskRequest(BaseModel):
    question: str = Field(min_length=1, max_length=500)
    k: int = Field(default=3, ge=1, le=15)
    use_cache: bool = Field(default=True)
    mode: Literal["pipeline", "agent"] = "pipeline"
    self_check: bool = False          # 只對 agent 有效


class AskResponse(BaseModel):
    answer: str | None                # 檢索沒撈到就是 null,不用空字串假裝
    citations: list[Citation]         # 檢索撈到的原文,不是模型講的條號
    usage: Usage                      # embedding/輸入/輸出 token,有沒有命中快取
    timing: Timing                    # embed/retrieve/llm/serialize/total/overhead
    retriever: str
    mode: Literal["pipeline", "agent"] = "pipeline"
    agent: AgentTrace | None = None   # 只有 mode=agent 才有
AgentTrace 裡是 steps、searches、llm_calls、queries、hit_cap、n_checks。
固定流程的 searches 與 llm_calls 永遠是 1,agent 不是,而那個數字直接對應帳單。
config.py:所有可調的東西@dataclass(frozen=True)
class Settings:
default_retriever: str = os.getenv("DAY24_RETRIEVER", "chroma")
default_k: int = _int("DAY24_K", 3)
documents_root: Path = Path(os.getenv("DAY24_DOCUMENTS_ROOT", str(BASE_DIR)))
job_db: Path = Path(os.getenv("DAY24_JOB_DB", str(BASE_DIR / "day24_jobs.sqlite3")))
resident_cache: bool = _bool("DAY24_RESIDENT_CACHE", True)
agent_max_concurrency: int = _int("DAY24_AGENT_CONCURRENCY", 1)
預設值就是原本寫在腳本裡的那些常數,所以什麼環境變數都不設的時候,行為跟以前一樣。
還有一個方法 resolve_document(raw):把路徑解到 documents_root 底下,
解出去就丟 ValueError。../../etc/passwd 不該因為「反正是內部服務」就放過去。
errors.py:錯誤長同一個樣子腳本出錯就是一個 traceback 印在我的終端機。服務的錯誤要給三種人看:
呼叫端要知道能不能重試、我要能在 log 裡找到同一次請求、三個月後的我要知道當時發生什麼事。
{"error": {"code": "document_not_found",
           "message": "找不到這份文件:foo.pdf",
           "request_id": "8f1c2b7e"}}
四個 handler 把所有出口收斂成這個形狀:ServiceError(服務自己丟的,帶狀態碼與代號)、HTTPException、RequestValidationError(Pydantic 擋下來的,訊息要指出是哪個欄位)、
還有兜底的 Exception(log 留完整 traceback,回給呼叫端的只有一句話)。
RequestIdMiddleware 發一個 id 放進 contextvars,同時寫進回應 header。
呼叫端已經帶了 x-request-id 就沿用它,跨服務才追得下去。
retrievers.py:把檢索隔成一層/ask 對檢索的需求只有一句話:給它一個問題向量,還它 k 條原文。以前這一步是直接呼叫 chroma_store.retrieve(collection, ...),所以 /ask 裡面就寫死了 Chroma。現在中間隔一層,介面只有一個方法:
@runtime_checkable
class Retriever(Protocol):
    name: str
    def search(self, query_vector: np.ndarray, k: int) -> list[Hit]: ...
實作要回的是 Hit:article_no、title、text、similarity,外加整包 meta。meta 要整包帶著走,因為下一步組 prompt 會用到裡面的章別;少帶一個欄位 prompt 就差一個字,而生成快取的 key 是整串 prompt 算出來的,既有的快取會整批失效。
隔這一層,今天就回本了兩次。
一、Chroma 出問題的時候,只有一個檔案要改。 開三個 worker 跑攝取的時候,有幾個請求死在這裡:
NotFoundError: Error getting collection:
  Collection [003716ce-0e9a-4bca-a9d2-e8ca641c5417] does not exist.
Chroma 內嵌模式下,另一個行程把 collection 砍掉重建之後,我手上那個 handle 就指向一個已經不存在的 UUID。修法是不要把 collection 抓在手上:ChromaRetriever 改成收一個「去把 collection 拿來」的函式,撞到 NotFoundError 就重拿一次再試。這些全部發生在 retrievers.py 裡面,/ask 一行都沒動。
二、第二個實作寫得出來。 NumpyRetriever 是 59 條的暴力解:
一個 (59, 1536) 的矩陣乘一個向量,向量都正規化過所以內積就是餘弦相似度。它不是要取代 Chroma,是要證明這個介面真的是介面:28 題打下去兩邊的 top-3與答案完全相同,而呼叫端只差一個 ?retriever=numpy。
embedder.py:兩種算向量的方式CachedEmbedder 走 rag_core.get_embeddings(),先查快取;DirectEmbedder 每次都真的打一次 API,不讀也不寫快取。get(use_cache) 選一個。
要有這兩個,是因為快取命中的時候量到的延遲不是真的:上線之後每一個新問題都沒進過快取。要看真實的延遲,就得有一條不走快取的路。
agents.py:把凍結的 agent 接進來這支 agent 手上有 search/check/answer 三個工具,自己決定要查幾次、什麼時候交卷,前幾天就寫好了,但一直只能用腳本跑。接進服務時有兩個限制:agent_day21.py 是那幾篇文章的證據,一行都不能動;而它直接吃 Chroma 的 collection。
chroma_store.retrieve() 只用到 collection.query() 這一個方法,所以做一個轉接頭:
class RetrieverCollection:
    def query(self, query_embeddings, n_results, include=None) -> dict:
        vector = np.asarray(query_embeddings[0], dtype=np.float32)
        with timing.stage("retrieve"):
            hits = self._retriever.search(vector, n_results)
        return {"documents": [[h.text for h in hits]],
                "metadatas": [[h.meta for h in hits]],
                "distances": [[1.0 - h.similarity for h in hits]]}
它不認識 Chroma,只認識上一節那個 search(),所以凍結的 agent 照樣跑在 numpy 上,28 題的答案與它自己下的查詢關鍵字都完全相同。這是隔那一層的第三次回報。
計時是靠替換 agent_day21 模組上的函式名做的,那是行程層級的,第二個請求走進來兩邊會互相污染。所以用一把信號量把 agent 請求序列化(DAY24_AGENT_CONCURRENCY,預設 1)。正解是把 retriever 與 embedder 注入 agent,但那要改那支凍結的檔案。
main.py:/ask 的 handler@app.post("/ask")
def ask(req: AskRequest, retriever: str | None = None) -> Response:
_require_ready()
engine = _retriever(retriever)
with _INDEX_LOCK:
if req.mode == "agent":
text, citations, usage, trace = _run_agent(req, engine)
else:
text, citations, usage, trace = _run_pipeline(req, engine)
寫成同步 def 不是 async def:底下那些 OpenAI 呼叫是會阻塞的 sdk,寫成 async 會把整個 event loop 卡住,同步的會被 Starlette 丟進執行緒池。
_require_ready() 在索引還沒建好的時候丟 503,不要讓第一個使用者撞到半成品。_retriever(name) 查不到就回 404 附代號 unknown_retriever,順便把有哪些列出來;打錯字的人看到的不該是 500。
兩種答法的差別只在引用怎麼組:固定流程回檢索給的那 k 條;agent 查了好幾輪,所以回它查過的條號去重之後的結果,順序照它讀到的順序。
那個 _INDEX_LOCK 為什麼要存在,下篇講。
這條路只讀索引,沒有人在寫它。下篇是另外半支服務:/documents 收文件、攝取丟背景、job 狀態放哪裡、一次請求的四段耗時怎麼量,還有 24 個測試各自在擋什麼。
《30 天打造 AI 後端:從 LLM、RAG 到 AI Agent》第 24 篇
day24_rag/)


 iThome鐵人賽
 看影片追技術