

Stream 的 API 看起來很多,但其實圍著兩個字打轉——chunk(流過的一筆資料)和 controller(你把資料交出去的窗口);看懂這兩個,ReadableStream、TransformStream、WritableStream 就都是同一套東西。
前置知識:Day 13 介紹過三種端點角色,忘了也沒關係,今天會從最小的例子重新帶。只要會寫 JavaScript 函式就能讀。
學習路線:先跑一個最小的管線,再拆開它問「這些函式是誰在呼叫」,把 chunk 和 controller 講清楚,最後看常用的 Stream API 怎麼用 pipe 接起來。
標籤:Web Streams API chunk controller ReadableStream WritableStream getReader() getWriter() pull Hono
用過 fetch 的 streaming、SSE、或某個 AI SDK 的串流回應之後,你可能會有一個共同的感覺:資料是「流」進來的,而不是一次到齊。
再往下翻這些套件的原始碼,會發現它們的本體多半是用最原始的 ReadableStream、TransformStream、WritableStream 幾個介面拼出來的。套件把細節都幫我們包好了,平常不用碰 —— 但也正因為包好了,一直沒機會看清楚: 這些 Stream API 到底是怎麼操作資料流動的?
今天就從最小的一條 Stream 流開始,親手把資料推進去、接出來,順便認識 chunk、controller、writer、reader 這些內部介面。
希望親手把這些介面都摸過一遍 —— 逐段讀懂它是怎麼用這幾個介面,理解一個 server handler 的怎麼輸出變成 HTTP 的串流回應。
說出 chunk(流過的一筆資料)與 controller(交出資料的窗口)分別是什麼,以及為什麼三種 stream 都有 controller。
分辨 Stream API 的兩側:用 getWriter() 拿到的 writer 往裡寫、用 getReader() 拿到的 reader 往外讀,以及各自的 lock。
說明 new ReadableStream({ pull }) 的 pull 型來源和 start 型「一次推完」的差別——為什麼 pull 是「consumer 要才給」。
. 判斷什麼時候你會真的自己寫 new ReadableStream(多半在 server handler),什麼時候只是消費現成的(多半在前端)。
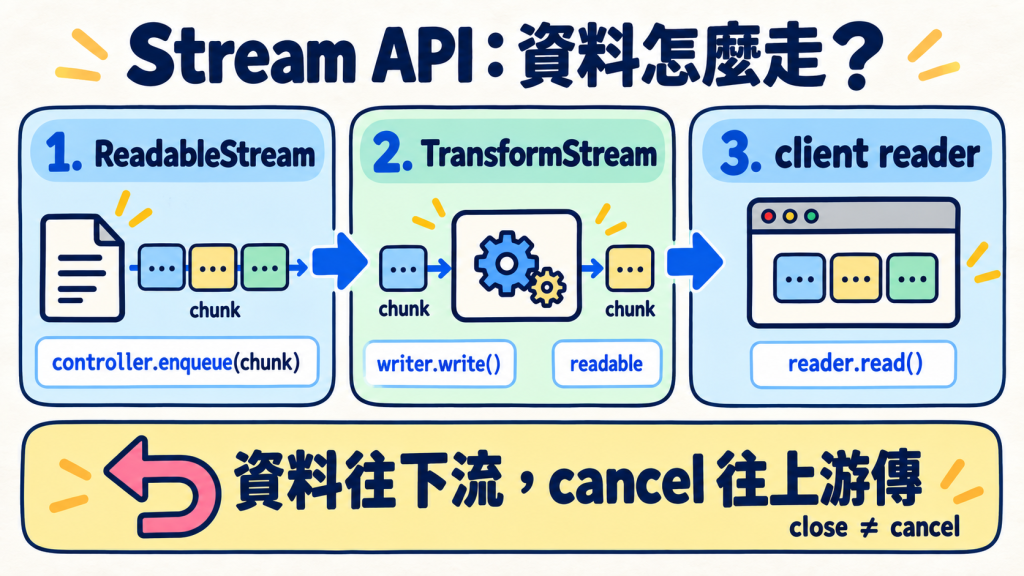
ReadableStream資料流動要從源頭看起。在 Web Streams 裡,源頭就是 ReadableStream——一個「可以被讀出資料的來源」。
平常你拿到的 ReadableStream 多半是別人給的(fetch 的 response.body、file.stream()),但今天要看清楚它裡面怎麼運作,所以我們自己造一個最小的:
const source = new ReadableStream({
  start(controller) {
    controller.enqueue('apple');
    controller.enqueue('banana');
    controller.enqueue('cherry');
    controller.close();
  },
});
new ReadableStream() 收一個物件,裡面的 start 是「這條流建立時要做什麼」。這裡出現了兩個今天的主角:
controller:stream 建立時遞給你的物件,是你把資料「放進這條流」的窗口。enqueue:把一筆資料放進流裡。en-queue 就是「排進佇列」的意思——資料在流裡是排隊等著被讀走的。close: 關閉不再塞入資料。你放進去的每一個東西('apple'、'banana'…),就叫一個 chunk:流裡的「一筆資料」。最後的 controller.close() 表示「送完了,沒有下一筆」。
要注意 close() 關的是入口,不是出口:它只是宣告「不再 enqueue 新資料」,佇列裡已經放進去的 'apple'、'banana'、'cherry' 讀取方一筆都還讀得到,等這些讀乾淨了,read() 才會回報結束。
所以 close() 和讀取方看到的「結束」不是同一刻。(也因為入口關了,close() 之後再 enqueue() 會拋錯。)
TypeError: ReadableStreamDefaultController.enqueue: Cannot enqueue into a stream that has already been requested to close.
start 是「一次推完」,但資料多的時候呢?上面的 start 在建構時就把三筆全推進去。資料少沒問題,但如果有一百萬筆、或資料是「有人要才生」(例如逐筆去資料庫撈),一次推完就不合理了。
這時改用 pull。它和 start 的差別,跑一次就看得很清楚(這裡先用 getReader() 把資料讀出來觸發它,讀取的細節下一節再說):
let n = 0;
const onDemand = new ReadableStream({
  pull(controller) {
    n++;
    console.log(`pull 第 ${n} 次被呼叫 → 產生 ${n}`);
    controller.enqueue(n);
    if (n === 3) controller.close();
  },
});

console.log('建構後 n =', n);          // 0:pull 一次都還沒被呼叫

const reader = onDemand.getReader();
// 資料開始 pull
await reader.read();                    // 讀第一筆
await reader.read();                    // 讀第二筆
輸出:
建構後 n = 0
pull 第 1 次被呼叫 → 產生 1
pull 第 2 次被呼叫 → 產生 2
這裡的 pull 啟動並不是你呼叫的,是 stream 在「內部佇列空了、有人要下一筆」時才呼叫它。 你只讀了兩筆,pull 就只被呼叫兩次,第三筆根本還沒生出來。 跟先前提過的Iterator lazy pull model 模式一樣——資料是被需求「拉」出來的,不是一次「推」完的。
start(controller) |
pull(controller) |
cancel(reason) |
|
|---|---|---|---|
| 何時被呼叫 | 建構時,一次 | 佇列空、有人要下一筆時,反覆 | 讀取方喊停時(reader.cancel() 或下游取消) |
| 用途 | 一次備齊資料 | 資料多、或要才生 | 收尾清理:釋放資源、停止跟上游要資料 |
前兩個負責「產生」資料,cancel 則是反方向的訊號——讀的人不要了,stream 就呼叫它,讓你有機會關檔案、斷連線、停止上游。
close 和 cancel:一條流的兩種結束,資料方 vs 使用者一條流會結束,只有兩種可能,方向剛好相反:
controller.close() |
cancel(reason) |
|
|---|---|---|
| 誰發起 | 生產方(你):資料送完了 | 讀取方:不想再讀了(reader.cancel()) |
| 屬於誰 | controller 的方法,你主動呼叫 | 來源的方法,stream 呼叫你(你只負責定義) |
| 剩下的資料 | 佇列裡的照樣讀完,才 done |
直接不要了,後面的收不到 |
| 意義 | 正常結束 | 提前中止 |
close 是「資料端我資料送完了」(從上游往下),
cancel 是「用戶端資料夠了我不看了」(從下游往上)。
pull 這個機制很重要,因為它讓來源可以接著另一個來源:每次有人要下一筆,我才去跟上游要一筆,把 handler 寫入的資料,一筆一筆拉成 HTTP 的 response body。
在
ReadableStream不管start還是pull,這段程式碼都只是「定義」了來源,資料還沒真的流動。要有人去讀,資料才會走。
reader定義好來源之後,資料還沒真的流動——要有人去讀才會走。讀取這一側 Day 14-怎麼讀一條 ReadableStream?從 getReader、read 到 for await...of 有提及 Stream 資料讀取需要獲得存取權:
const reader = source.getReader();
const { done, value } = await reader.read();   // value 是一筆 chunk,done 在流結束時為 true
不過除了獲得資料流存取權外,
getReader()會把整條流「鎖住」(exclusive lock),同一時間只能有一個 reader。不讀了要releaseLock()放鎖,才能換另一個接手,這個狀態對 同一時間Stream 資料流做轉換滿重要的,畢竟大家都在轉換資料怎確保不會轉到舊的。
source.getReader();
console.log(source.locked);   // true,此時再 getReader() 會丟 TypeError
chunk 與 controller 貫穿 Stream 主體到這裡 Stream 資料流最基本的心法其實已經差不多:controller.enqueue() 放進去、reader.read() 讀出來。趁這個機會把這兩個字釘死,因為整個 Stream API 都圍著它們轉。
chunk就是「一筆資料」。 它不限型別,你 enqueue 什麼它就是什麼:
controller.enqueue('字串');
controller.enqueue(42);
controller.enqueue({ hi: true });
// 讀出來分別是 string、number、object
controller是你跟 stream 溝通的窗口。 你寫的start、待會的transform、pull這些函式都不是你呼叫的,是 stream 在對的時機呼叫它們,並把controller當參數遞給你。你不能用return交出資料,只能透過controller:
controller.enqueue(value);   // 送出一筆
controller.close();          // 收工,沒有下一筆
controller.error(err);       // 這條流壞了,讓它進入 error 狀態
三種 stream 都有自己的
controller,因為它們都面對同一個問題:「你的函式被 stream 呼叫,那你怎麼回頭跟它互動?」只是能做的事不同:
| 你在寫哪種 stream | controller 上有什麼 | 為什麼是這些 |
|---|---|---|
來源 ReadableStream |
enqueue close error |
你在生產:能送出、能收工、能報錯 |
加工站 TransformStream |
enqueue error terminate |
你在中轉:能送出、能報錯、能提前收掉 |
目的地 WritableStream |
error signal |
你在接收:沒有下游可送,所以沒有 enqueue |
看最後一列:目的地是終點,沒有下一站,所以它的 controller 沒有 enqueue。這反過來確認了 enqueue 的意義——它就是「往下游送一筆」。
WritableStream 與加工站 TransformStream來源會生資料、reader 能讀資料,管線還缺兩個角色:資料最後要去的目的地,以及中間的加工站。先看目的地,因為加工站其實是用它拼出來的。
目的地 WritableStream:資料的終點。它是單向的——你只能把資料送進去,不能從它讀出來(讀是 ReadableStream 的事)。
const sink = new WritableStream({
  write(chunk) {                    // 每送進一筆,這裡就自動跑一次
    console.log('目的地收到:', chunk);
  },
});

const writer = sink.getWriter();
await writer.write('hello');        // 你送一筆進去
await writer.close();              // 沒有要送了,關閉
執行印出 目的地收到: hello。只有兩件事要記:
writer.write('hello') = 你動手送一筆進去。write(chunk){} = 送進去之後 stream 自動幫你跑一次,chunk 就是你剛送的那筆。你只會呼叫 writer.write(),另一個 stream 會自己叫。
令人容易搞混的 write,聽起來很像寫入的動作,不過實際上沒有做資料寫入🤣🤣:
這裡的
write(chunk){}雖然叫「write」,但它不是「把資料寫到哪裡」的動作,而是每筆資料到站時自動觸發的處理函式——你在裡面決定拿這筆 chunk 幹嘛(印出來、存資料庫、更新畫面)。它有點像「攔到每一筆」,但要注意:WritableStream是終點、沒有下游,所以你在這裡是把資料處理掉,沒辦法把結果再往下送。
真正「加工後繼續往下傳」的是等一下的 TransformStream(它有出口,能 enqueue 給下一站);WritableStream 的 write 則是「資料到站了,消化掉它」。
這樣就補齊了對稱的兩側:ReadableStream 用 getReader() 拿 reader 把資料讀出來,WritableStream 用 getWriter() 拿 writer 把資料送進去。
TransformStream:其實就是前兩種黏起來第一次讀到 TransformStream,我很容易搞混它的定位:它既能像 ReadableStream 那樣被讀出資料,入口又能像 WritableStream 那樣被寫入——為什麼要多發明一個,把另外兩種流的能力綜合在一起?
後來把它想成「一個綜合性的轉換工具」就好懂了:資料從一端寫進去、加工、從另一端讀出來。它其實沒有新東西,就是剛才的 WritableStream(入口)+ ReadableStream(出口)黏成一組。你要自己把這兩種流手動串起來也不是不行——但每次都要接兩端、處理關閉,很煩又容易錯,所以平台直接給你一個現成的,中間留一個 transform(chunk, controller) 讓你插加工邏輯:
const upper = new TransformStream({
  transform(chunk, controller) {
    controller.enqueue(chunk.toUpperCase());   // 收一筆、改一筆、送一筆
  },
});
把上面建立好的 ReadableStream 資料來源接上這個加工站,再讀出來,就看得到它真的在中間改資料:
const reader = source.pipeThrough(upper).getReader();
console.log((await reader.read()).value);   // 'APPLE'
console.log((await reader.read()).value);   // 'BANANA'
transform 每流過一筆就被呼叫一次,跟第一節的 start、pull 一樣——你寫函式,stream 在對的時機呼叫它、並遞給你 chunk 和 controller。
黏成一組」不只是比喻——TransformStream 建出來的實例,身上真的有這兩個屬性:
const t = new TransformStream({ transform(chunk, c) { c.enqueue(chunk.toUpperCase()); } });

t.writable   // → WritableStream(入口,資料從這寫進去)
t.readable   // → ReadableStream(出口,加工後從這流出來)
所以你能用解構把兩端分開拿出來:const { readable, writable } = t。pipeThrough(t) 之所以收得下 t,正是因為它有這兩個屬性
那資料怎麼從入口跑到出口?其實步驟很單純:
writable)transform(chunk, controller) 就被叫一次controller.enqueue(結果)
readable),被下游讀到也就是說,把資料從入口「送到」出口的動作,就是你呼叫的那句 controller.enqueue()。controller 你可以想成一個投遞口:你把加工好的每一筆丟進去,它就送到出口那端。
當然實務上我們很少手動 getReader / getWriter 再自己搬資料,多半用 pipeThrough()(經過加工站)和 pipeTo()(送到目的地)讓它們自動流動:
await source.pipeThrough(upper).pipeTo(sink);
// 目的地收到: APPLE / BANANA / CHERRY
這兩個方法收什麼、回傳什麼,其實看「它把資料交去哪」就懂了:
pipeThrough(加工站) |
pipeTo(終點) |
|
|---|---|---|
| 收什麼 | { readable, writable }(加工站,有入口也有出口) |
WritableStream(終點,只有入口) |
| 回傳什麼 | 加工站的 readable(出口)→ 可以再接下一段 |
Promise<void>(完成收據)→ 要 await |
pipeThrough() 的參數只要是「有 readable 和 writable 兩個屬性」的物件就行,不必真的是 TransformStream——這也是為什麼內建加工站和你自己寫的能混著用。
它內部大約等於「把來源灌進加工站的
writable,再把加工站的readable回傳給你」,所以我們能夠從ReadableStream一段接一段.pipeThrough().pipeThrough()。
pipeTo() 收的是終點,終點沒有出口可還你,所以改回傳一個 Promise:來源送完、全部寫入、終點關閉後才 resolve,中途出錯就 reject。一句話:pipeThrough 回傳「另一端」讓你接下去,pipeTo 回傳「一張完成收據」讓你等結束。 這就是為什麼一條管線總是 .pipeThrough()….pipeThrough().pipeTo()。
不過今天的重點是看清楚手動那一層(getReader/getWriter/enqueue),因為套件本體就是在那一層做事。
終於耐著性子練習到這裡😅,來源、加工站、目的地三種角色都認識過了,start、pull、transform、write、flush 也都出現過。退一步看,它們其實是同一套生命週期(開場 → 每筆 → 收尾 → 出事),三種角色各自填上符合職責的名字:
| 時機 | 來源 ReadableStream |
目的地 WritableStream |
加工站 TransformStream |
|---|---|---|---|
| 建立時一次 | start(controller) |
start(controller) |
start(controller) |
| 每筆資料 | pull(controller) 有人要才叫 |
write(chunk, controller) |
transform(chunk, controller) |
| 正常結束 | (在 pull 裡自己 close()) |
close() |
flush(controller) |
| 被取消/中止 | cancel(reason) |
abort(reason) |
— |
名字反映角色:來源要生資料所以是 pull(被拉才生)、目的地要收所以是 write、加工站要轉所以是 transform。這些函式都不是你呼叫的,是 stream 在對的時機按名字呼叫,並把對應的 controller 遞給你。
不過因為 pull、start 這些介面是開發者自己定義得,我想知道會不會有一種的坑是:名字是固定的寫錯會不會有錯誤訊息?,還是只會被靜默忽略?。 實測幾種常見錯誤:
// 把 pull 拼成 pul
new ReadableStream({
  pul(controller) { controller.enqueue(1); },   // 永遠不會被呼叫
});
// → reader.read() 永遠卡住(等一個不會到的資料),不拋錯

// 把 transform 拼成 transfrom
source.pipeThrough(new TransformStream({
  transfrom(chunk, c) { c.enqueue(chunk.toUpperCase()); },   // 被忽略
}));
// → 加工站變成「什麼都不做」,資料原樣通過,不拋錯

// WritableStream 沒寫 write(或拼錯)
new WritableStream({});
// → writer.write('x') 不報錯,資料被默默接受並丟棄
因為 stream 是「有這個名字的方法就叫、沒有就跳過」,拼錯等於「沒定義」,於是行為悄悄退化:該生資料的不生、該加工的不加工、該收的默默丟掉——全都不會拋錯。所以串流程式最難抓的 bug 往往是這種:沒有錯誤訊息,只是資料莫名其妙不見或卡住。寫這些方法時,第一件事就是確認名字拼對了。
StreamingApi終於把 Stream API 的基礎知識備齊了🥰!:controller、chunk、getReader/reader、getWriter/writer、pull、lock,現在來讀一份真的在用這些的原始碼。
當在 Hono 寫串流回應時,程式大概長這樣:
app.get('/sse', (c) => {
  return stream(c, async (stream) => {
    await stream.write('data: 1\n\n');
    await stream.write('data: 2\n\n');
  });
});
那個 stream 物件就是 StreamingApi 的實例。它是這樣被建立的(Hono src/helper/streaming/stream.ts):
const { readable, writable } = new TransformStream();
const stream = new StreamingApi(writable, readable);
先記住這行:Hono 開了一個 identity TransformStream(不改資料,只當管子),把它的兩端 writable、readable 交給 StreamingApi。你的 handler 往 writable 寫,資料原封不動從 readable 流出。
以下是 StreamingApi 的建構式(Hono v4.13.8,src/utils/stream.ts):
constructor(writable, _readable) {
  this.writable = writable
  this.writer = writable.getWriter()          // ① 寫入側:拿 writer
  this.encoder = new TextEncoder()

  const reader = _readable.getReader()         // ② 讀取側:拿 reader

  this.abortSubscribers.push(async () => {
    await reader.cancel()                       // ④ 斷線時,取消上游
  })

  this.responseReadable = new ReadableStream({ // ③ 對外的 body
    async pull(controller) {
      const { done, value } = await reader.read()
      done ? controller.close() : controller.enqueue(value)
    },
    cancel: () => {
      if (!this.closed) {
        this.abort()
      }
    },
  })
}
一段一段拆:
① this.writer = writable.getWriter() —— 這就是第四節的「寫入側」。之後 stream.write() 全都是往這個 writer 寫。
② const reader = _readable.getReader() —— 這是「讀取側」,從 identity transform 的另一端把資料讀出來。到這裡,資料流的骨架已經成形:handler → writer → (管子)→ reader。
③ this.responseReadable = new ReadableStream({ pull }) —— 這是真正回傳給瀏覽器當 response body 的那條流。它是 pull 型的:每當 HTTP 層要送下一段給客戶端,就呼叫一次 pull,pull 去 reader.read() 拉一筆,有資料就 enqueue、沒了就 close。第一節的 pull 在這裡真實上場——它把 reader 一筆一筆「轉接」成 response body。
於是完整的資料流是:
你的 handler
  → stream.write()        (寫進 writer)
  → writable ── 管子 ── readable
  → reader.read()         (responseReadable 的 pull 去拉)
  → responseReadable      (這條就是 HTTP response body)
  → 瀏覽器
④ 為什麼要多包一層 responseReadable,不直接把 readable 當 body? 就為了那個 cancel。當客戶端關掉分頁,瀏覽器會 cancel response body,於是 responseReadable 的 cancel 被呼叫 → 觸發 this.abort() → 執行 abortSubscribers 裡那個 reader.cancel() → 取消訊號沿著流往上游傳,讓還在跑的 handler 停下來。這就是第二節那個「reader」和 Day 14 的 cancel 在真實情境的用途。
再看 write():
async write(input) {
  try {
    if (typeof input === 'string') {
      input = this.encoder.encode(input)
    }
    await this.writer.write(input)
  } catch {
    // Do nothing. If you want to handle errors, create a stream by yourself.
  }
  return this
}
兩個細節值得停下來:
await this.writer.write(input)? 因為 writer.write() 回傳的 Promise 代表「這一筆收下了、可以給下一筆」。await 它,handler 的寫入速度才會跟著下游走,而不是把資料一股腦塞爆記憶體。try/catch 又什麼都不做? 這正是 ④ 的後續:客戶端斷線後,上游被 cancel,這時還在跑的 writer.write() 會 reject。Hono 選擇把這個錯誤吞掉——因為斷線不是 handler 的錯,不該讓它崩潰。(註解也老實說了:想自己處理錯誤,就別用這個 helper。)最後看 pipe(),第二節的「換手」在這裡:
async pipe(body) {
  this.writer.releaseLock()                    // 先放掉 writer 的鎖
  try {
    await body.pipeTo(this.writable, { preventClose: true, preventAbort: true })
  } finally {
    this.writer = this.writable.getWriter()    // 用完再拿回來
  }
}
pipeTo() 需要獨占 writable,但 writable 已經被建構式裡的 this.writer 鎖住了。所以要先 releaseLock() 放鎖、讓 pipeTo 接手,結束後再 getWriter() 拿回來——就是第二節那個「放鎖 / 換手」。而 preventClose: true 是因為 pipe 完之後 handler 可能還要繼續 write,不能讓這條 writable 被自動關掉。
讀到這裡也許會覺得這些介面很碎——生資料、讀、轉、收、上鎖各管一件事。但回頭看 Hono 就會發現,它其實是把這些小積木照職責擺好:
對外的資料集中在一個
ReadableStream(responseReadable),response body 就從這一端接出去;
中間拿一個
TransformStream當「連接管」,把 handler 寫入的writable和對外的readable接成一對(注意它傳的是空的TransformStream,只借端點、不做加工,真正的字串轉 bytes 是在write()裡用TextEncoder做的);
而
pipe()前後那組releaseLock()/getWriter(),則是處理「同一條writable不能同時被兩個 writer 佔用」的非同步細節。
所以「碎片化」正是這套 API 的設計:每塊只做一件事,威力在於能照需求拼。看懂積木,你再打開任何一個串流套件的原始碼,都會認得它把哪塊擺在哪裡🤠。
繞了一圈,回到最初的動機:這些介面我到底什麼時候會碰到?
多半不用自己寫的情況(前端消費):你拿到的是現成的 ReadableStream——response.body、file.stream()。你要做的是「讀」和「加工」,用 for await...of、pipeThrough()、pipeTo() 就夠,幾乎不需要 new ReadableStream。
會真的自己寫的情況(多半在 server 或函式庫):當你要產生一條流——把一個非串流的來源(資料庫游標、LLM token、外部事件)包裝成 ReadableStream 送出去。這時 pull、controller、writer/reader 換手就全用上了,Hono StreamingApi 就是最典型的例子。
所以回到那個感覺:套件幫你把這些包好了,是因為手動操作這幾個介面確實繁瑣。 但看懂它們之後,你再讀任何一個串流套件的原始碼——不管是 Hono、AI SDK、還是 Node 的 stream 橋接——都會認得那個骨架:
一側 writer 寫、一側 reader 讀、中間用
pull一筆一筆拉,斷線時用cancel往上游傳。
今天從資料的源頭 ReadableStream 出發,一路認識了 chunk(流過的一筆)、controller(交出資料的窗口),最後用這些介面讀懂了 Hono StreamingApi 怎麼把 handler 的輸出變成 HTTP response body,雖然一開始打開 MDN 很煩沒太多耐心看完,不過花了個週末倒是收穫滿滿最重要~希望大家也能夠體驗程式的樂趣就於此😍😍😍。
WHATWG Streams Standard — Readable streams
underlying source 的 start/pull/cancel,以及 ReadableStreamDefaultController 的 enqueue/close/error。
WHATWG Streams Standard — Writable streams
underlying sink 的 write/close/abort,以及 WritableStreamDefaultController 只有 signal/error、沒有 enqueue。
WHATWG Streams Standard — Transform streams
transformer 的 transform/flush/start,以及實例的 readable/writable 兩端。
WHATWG Streams Standard — pipeThrough() 與 ReadableWritablePairpipeThrough 接收 { readable, writable }、pipeTo 接收 WritableStream 並回傳 Promise 的定義。
MDN — Using readable streams
push 與 pull source 的差別、getReader()/read()/lock 的實務說明。
Hono StreamingApi 原始碼(v4.13.8)
本文第六節逐段解析的對象:getWriter/getReader/pull/cancel 如何組成串流回應。
Hono — Streaming Helperstream()/streamSSE() 的用法,以及自動關閉與 abort 通知。


 iThome鐵人賽
 看影片追技術