
Day 27 的引擎算出年化 36%,Day 15 的尺量出 IC 0.13。這兩個數字在說話之前,要先確認說話的人沒問題。
一個回測會騙人的方式其實不多,大致四種:引擎本身算錯(成本漏扣、持有期算錯、報酬重複計)、資料裡混進了未來、訊號其實是運氣、母體只剩活下來的公司。這篇一個一個做,每個都設計成「如果引擎有問題,這個檢查會爆」的形式。
最直接的做法是餵一份自己造的資料,答案事先就知道。
合成 500 檔股票、2,500 個交易日:每天的報酬是市場加上個股雜訊,然後每五天種一個訊號 x 進去,讓 x 跟之後 20 天的報酬有固定的橫斷面相關。引擎不知道 x 是怎麼來的,只拿它當排名,每週買前 10、隔日開盤、持有 15 日、來回 0.471%。
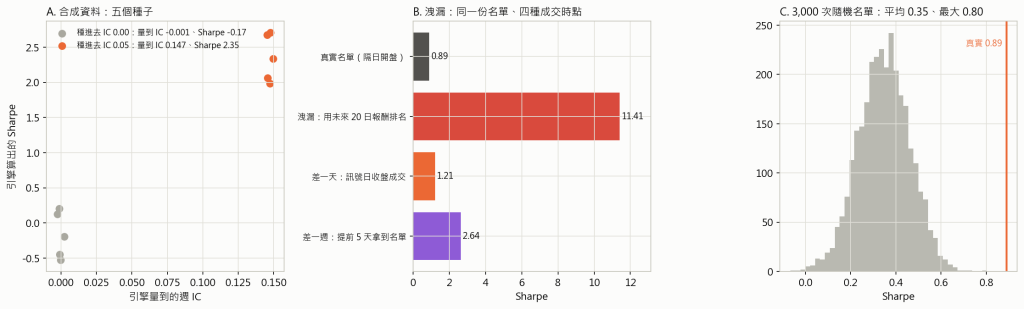
                  引擎量到的週 IC   年化     Sharpe   (五個種子的平均 ± 標準差)
種進去的訊號      0.147 ± 0.002    +50.5%   2.35 ± 0.34
沒有訊號          −0.001 ± 0.002   −4.4%    −0.17 ± 0.33
有訊號時量得到、五個種子量出來幾乎一樣,沒訊號時量到零。這是最低標準。
上面那張表有個問題:我設的強度是 0.05,引擎量到 0.147,差了三倍。原本的說法是「我的係數換算錯了」,但這句話在只種一個強度的情況下沒辦法驗證。量到 0.147 也可能是引擎在放大訊號,而放大訊號的引擎會把任何研究結果都變好看。
要分辨,得把強度當旋鈕轉一圈。種 0、0.02、0.05、0.10、0.15 五個強度,每個五個種子:
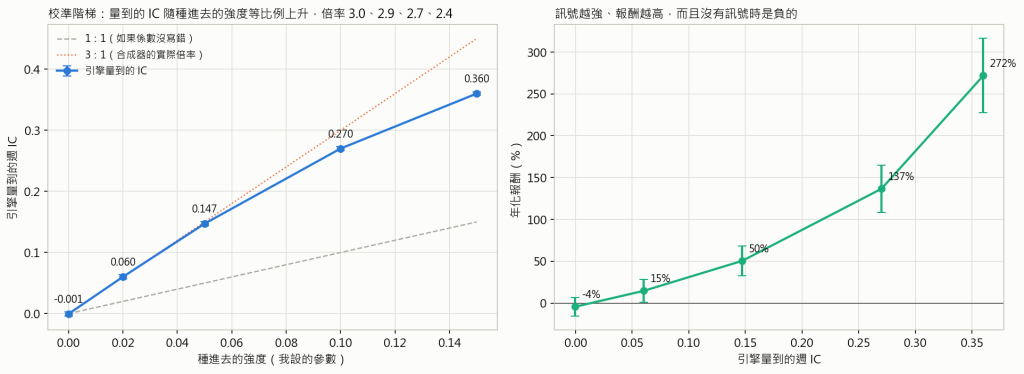
種進去   量到的 IC   倍率    年化       無成本年化
0.00    −0.001      —      −4.4%      +3.4%
0.02    +0.060     3.01    +14.6%     +23.9%
0.05    +0.147     2.94    +50.5%     +62.6%
0.10    +0.270     2.70   +136.6%    +155.7%
0.15    +0.360     2.40   +271.7%    +301.6%
倍率穩定在 3 附近,高強度時略微往下掉,那是等級相關本身的飽和:報酬被訊號主導之後,再加強也擠不出更高的 Spearman。這才證明錯的是合成器的係數,不是引擎。引擎的工作是「種多少量多少、種越多量越多」,它做到了,而且量到的 IC 跟年化報酬單調對應。
順帶一提,右圖那條曲線也是一張有用的對照表:IC 0.15 對應年化 50%,IC 0.27 對應 137%。真實世界的 IC 是 0.13,而真實回測的年化是 30% 上下,比合成世界低得多。合成資料沒有產業群聚、沒有流動性限制、沒有漲跌停,它是引擎的體檢儀器,不是報酬的預測器。
「沒訊號時年化 −4.4%」這個數字值得拆開,因為它同時驗證兩件事:成本有沒有真的扣、扣得對不對。
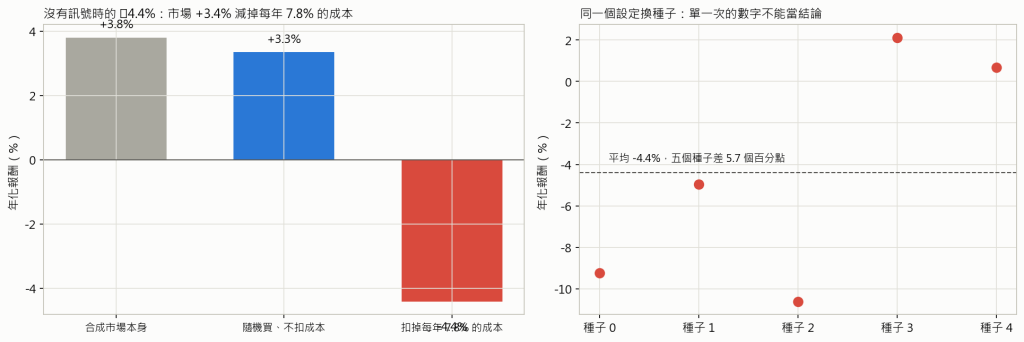
合成市場本身                 +3.8%
隨機買、不扣成本             +3.4%     跟市場差不多,選股沒有 alpha
扣掉成本                     −4.4%     成本每年 7.8%
每年 7.8% 的成本是這樣來的:名單每五個交易日一份,一年 50 份,每份十檔,每檔的部位是三分之一批乘十分之一,來回 0.471%,乘起來就是 7.8%。這個數字跟 Day 3 的門檻表對得上,那裡算過一年換手 12 次是 5.7%、24 次是 11.3%。
右邊那張圖是同一個設定換五個種子的結果:−10.6%、−9.2%、−5.0%、+0.7%、+2.1%,標準差 5.7 個百分點。這也是為什麼前面每個數字都要跑五個種子,單一次的 −4.4% 本身沒有意義。
引擎算得準之後,下一個問題是資料的時間有沒有對齊。做法是故意製造洩漏,看引擎會不會忠實地把它放大。
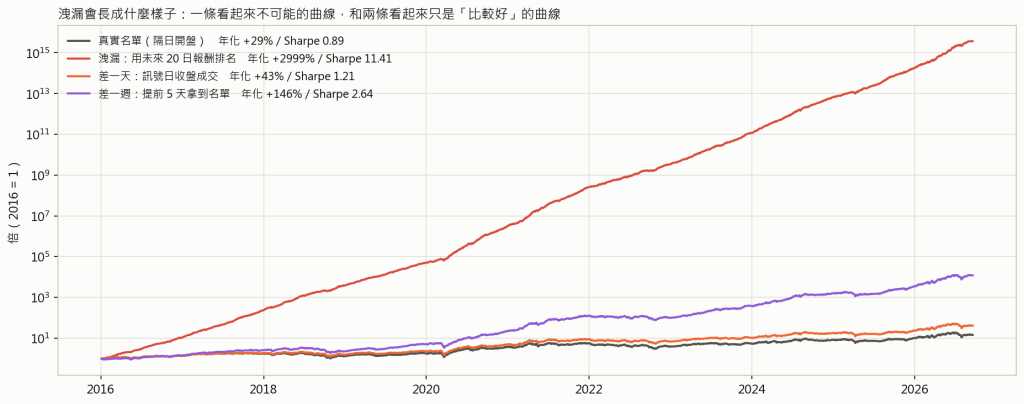
                              年化       Sharpe   最大回檔
真實名單,隔日開盤             +29.1%    0.89     −50%
洩漏:用未來 20 日報酬排名     +2,999%   11.41    −17%
差一天:訊號日收盤成交         +42.8%    1.21     −43%
差一週:提前 5 天拿到名單      +146%     2.64     −46%
第一列是這篇用的簡單引擎(每週前 10、等權、固定 15 日,不是 Day 27 那條規則)的正常成績。
第二列是把「之後 20 天的報酬」直接當排名,Sharpe 11.4、一年三十倍。這是引擎沒問題的證據:它把洩漏誠實地放大成不可能的數字,沒有任何平滑或截尾把它藏起來。看圖上那條紅線就知道,真正的洩漏長得不像「比較好的策略」,它是一條幾乎垂直的線。
真正危險的是第三列和第四列,它們只是「看起來比較好」。差一天:訊號用 t 日收盤的資料算,卻在 t 日收盤成交,Sharpe 從 0.89 變 1.21,年化多 14 個百分點。這個錯誤在程式裡只有一個索引的差別,在圖上也只是一條稍微高一點的線,沒有任何地方會跳出來警告你。這個系列從 Day 12 起所有回測都是隔日開盤,Day 19 起的擇時是 t+2 生效,就是為了這一列。
第四列是提前一週拿到名單,年化 146%。任何看起來太好的結果,先查這兩件事:成交時點、名單可得日。
引擎沒問題、時間對齊了,還有一種可能:訊號本身沒內容,是這十年剛好這樣。
同一批候選(過了量比與產業篩選的那幾百檔),每週隨機挑 10 檔取代分類器的前 10,重複 3,000 次:
隨機名單的 Sharpe    平均 0.35、標準差 0.11、95% 分位 0.53、3,000 次裡的最大值 0.80
真實名單             0.89,z = 4.8
3,000 次運氣裡沒有一次到 0.89。
這裡的 0.35 不是零,這件事比檢定結果更重要:候選母體本身在這十年是漲的,隨機買也有 0.35。如果拿真實的 0.89 去跟零比,會以為分類器的貢獻是全部;實際上它多出來的是 0.54。跟運氣比,不要跟零比,這是 Day 22 對擇時做隨機開關時學到的同一件事,差別在那次真實的規則落在隨機分布裡面,這次選股落在外面。
最後一種騙法最安靜:用今天還在的股票回測過去十年,輸家早就被名單剔除了,回測自然好看。
資料是逐日抓整個市場,不是從今天的成分股往回找,所以下市的公司在它還活著的日子裡都在:
2015 年起出現過的股票    2,145 檔
2026 年 6 月前就消失的     154 檔(下市、合併、停止交易)
名單買過的                1,018 檔,其中 42 檔後來消失
2016 年後才上市的          533 檔
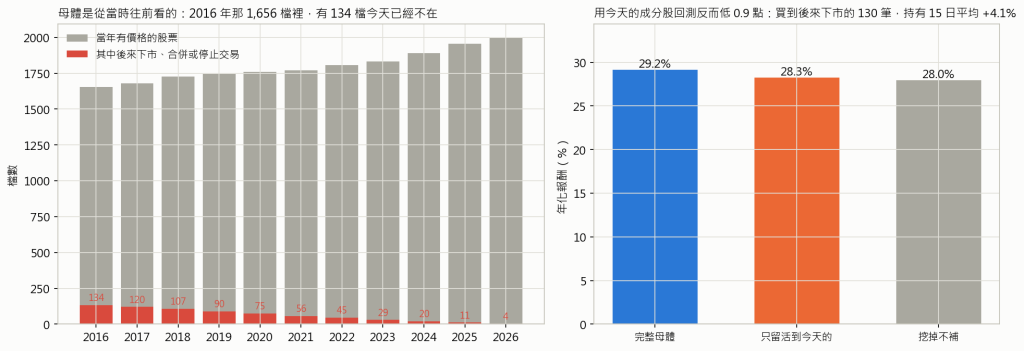
左圖是逐年的母體:2016 年有 1,656 檔,其中 134 檔今天已經不在;到 2025 年只剩 11 檔會在之後消失。這個遞減的形狀就是存活者偏誤的來源,如果用今天的名單往回跑,2016 年那一格會少掉 134 檔。
偏誤有多大?我把母體限制成「2026 年還活著的股票」,重新選滿十檔再跑一次:
完整母體          年化 29.2%   Sharpe 0.89
只留活到今天的     年化 28.3%   Sharpe 0.87
死掉的挖掉不補     年化 28.0%   Sharpe 0.87
偏誤是 −0.9 個百分點,而且方向是反的:用今天的成分股回測反而比較差。原因在那 130 筆買到後來下市公司的交易,持有 15 日平均賺 4.1%,比買到活下來的公司(2.7%)還高。這些公司下市前通常經歷過劇烈的價格變動,而這套規則挑的就是劇烈變動。它們在名單裡的那段是賺的,死是後來的事。
這不表示存活者偏誤不重要,而是說偏誤的方向取決於策略。持有 15 天的動能策略,下市那天早就出場了;長期持有的價值策略就完全不同。要知道方向,只能實際量一次。
A 合成資料     引擎的算術:成本、持有期、批次、報酬的複利
A2 校準階梯    引擎有沒有放大訊號:種多少量多少
B 洩漏         資料的時間對齊:成交時點、名單可得日
C 打亂         訊號有沒有內容:對比同一母體的運氣
D 存活者       母體有沒有偏:從今天往回看 vs 從當時往前看
它們擋不了的是 Day 22 那種:規則在真實資料上真的有效,但只在幾個樣本點上有效。那個要靠刀切和兩段驗證,不是引擎的事。也擋不了「我試了兩百種參數挑最好的那個」,那要靠先寫下規則再跑。
**先給引擎一個知道答案的題。**種進去的訊號量得到、五個種子一致、沒訊號時是負的成本,三件事都成立引擎才能用。
**只種一個強度不算校準。**五個強度掃下來,倍率穩定在 3 附近,證明差三倍的是合成器的係數不是引擎;沒有這張階梯,「量到 0.147 但我設 0.05」這句話等於沒交代。
**沒訊號時的 −4.4% 要拆得開。**市場 +3.4% 減掉每年 7.8% 的成本,跟 Day 3 的門檻表對得上;而五個種子的標準差是 5.7 個百分點,單一次的數字不能當結論。
**故意洩漏是最便宜的檢查。**未來報酬當排名 Sharpe 11.4,一眼就知道不對;真正危險的是差一天的 1.21 和差一週的 2.64,它們只是「看起來比較好」。
**跟運氣比,不跟零比。**同一批候選隨機挑 3,000 次,Sharpe 平均 0.35、最大 0.80,真實 0.89。分類器的貢獻是超過母體運氣的那 0.54。
**存活者偏誤的方向要自己量。**這套規則是 −0.9 個百分點,因為買到後來下市的 130 筆在持有的 15 天裡平均賺 4.1%,比其餘的還高。


 iThome鐵人賽
 看影片追技術