
文字特徵四個,來源是 Day 24 的 embedding 語氣軸,因為它 2013 年起全覆蓋、沒有前視:
has_note     取樣日往前 45 天內有沒有備註(1/0)
tone         最近一則備註的語氣軸分數(沒有備註 = 缺值)
tone_resid   tone 扣掉營收 yoy 線性能解釋的部分(係數只用 2013~2019 擬合)
tone_chg     tone 減該公司上一則備註的 tone
結果:
                         留出期 IC   ICIR    十分位多空差   IC(只算有備註的股票)
48 特徵                  0.1314     1.17    1.72%         0.1291
48 + 文字                0.1318     1.17    1.75%         0.1296
文字 only                0.0182     0.46    0.07%         0.0176
48 + 文字(不含 has_note)0.1311     1.16    1.70%         0.1295
每週的 IC 差平均 +0.0004,t 值 1.1。下面五節就是在問這個 0.0004 能不能信。
如果語氣這個數字對報酬根本沒話說,那零是特徵的問題,不是模型的問題,後面的檢查都不用做。
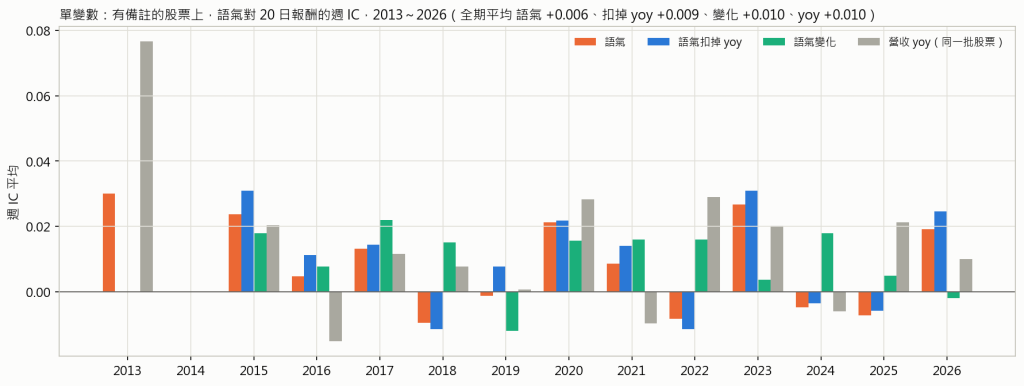
只看有備註的股票,語氣對之後 20 日報酬排名的週 IC:
                     週 IC 平均   ICIR    IC > 0 的週
語氣 tone            +0.006      0.09    43%
語氣扣掉 yoy         +0.009      0.13    44%
語氣變化             +0.010      0.20    45%
營收 yoy(同一批股票)+0.010     0.12    45%
有沒有備註(全體)   −0.016     −0.35    37%
有訊號,0.006 到 0.010,跟同一批股票上營收 yoy 這個數字一樣大。「有沒有備註」還是最強的一個,而且是負的:有寫備註代表這個月變動大,之後 20 天平均是輸的,這是 Day 13 講過的大變動之後均值回歸,跟文字內容無關。
這個假零關掉了。特徵不是死的。
樹模型有可能因為缺值、尺度、或分裂順序而看不見一個特徵。檢查方式是讓它單獨上場。
文字 only 的模型留出期 IC 0.0182、ICIR 0.46,自己站得住。所以模型讀得到。
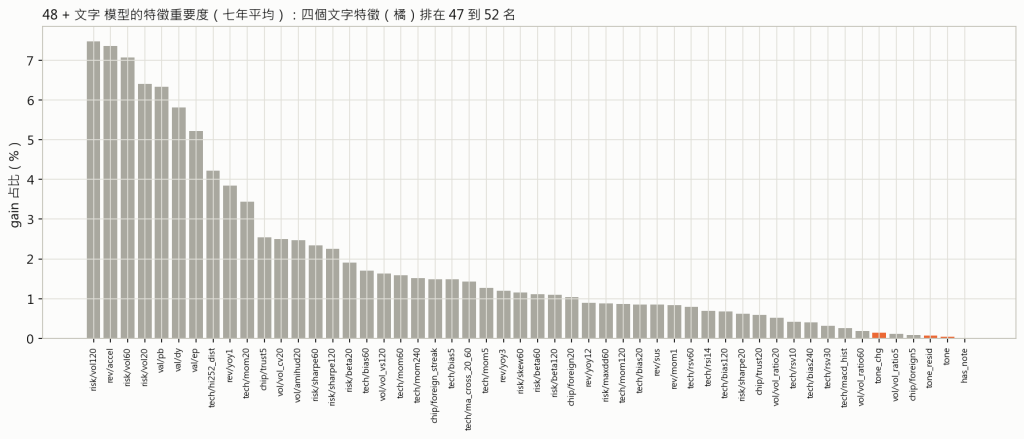
但四個文字特徵在 52 個特徵裡的 gain 排名是 47、50、51、52,占比合計 0.26%。模型讀得到,只是幾乎不用。has_note 在單變數裡最強,進了模型排最後,因為它的資訊就是 rev/yoy1 和 rev/accel 的絕對值。
順帶解釋一個會看錯的數字:文字 only 的前 5% 命中率是 5.91%,比 48 特徵的 2.55% 高,看起來像是文字模型比較強。這裡的命中率基準不是 5%:報酬排名在全母體算,而模型樣本剔掉了特徵缺太多的小型股,極端報酬正好集中在被剔掉的那些股票,所以基準本來就低於 5%。文字 only 有八成股票是缺值、預測值相同,選出來的其實是「有寫備註」的那兩成,那是波動大的股票,兩邊尾巴都厚。同一列的十分位多空差只有 0.07%,對照 48 特徵的 1.72%,就知道那不是本事。
覆蓋率是這批特徵的第一個現實:所有取樣日裡只有 17.5% 的股票在 45 天內有備註(2016 年起 21.0%),因為 Day 24 講過,只有大變動才會寫。八成股票是缺值,全體 IC 被沒備註的那群拉平,是合理的懷疑。
只算有備註的股票重算一次:每週 IC 差 +0.0005,t 0.95。跟全體的 +0.0004 一樣。
這個假零也關掉了。
t 值 1.1 跟兩件事相容:增量真的是零,或者增量存在但這把尺看不到。要分辨,得先知道這把尺能看到多小。
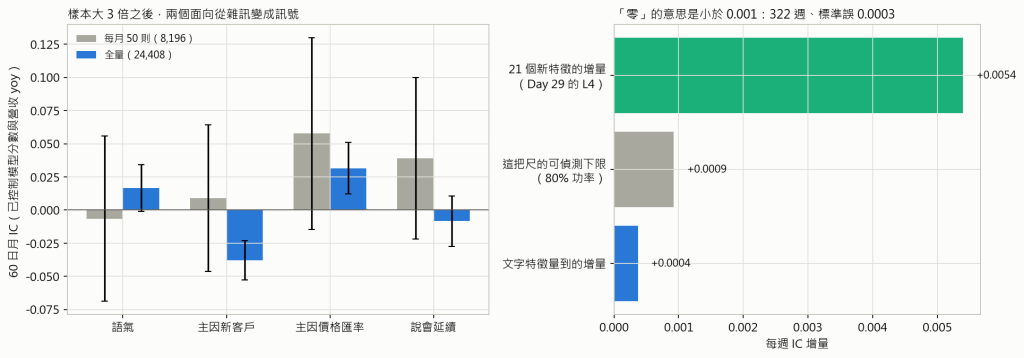
留出期有 322 週,每週 IC 差的標準誤 0.0003。要在 5% 顯著水準下有 80% 的機會抓到,增量至少要 0.0009。實際量到 0.0004,是門檻的一半以下。
所以「零」在這篇是有定義的:小於 0.001。對照 Day 29 疊層時那 21 個新特徵,它們的增量是 0.0054,六倍於這個門檻,一量就跳出來。這把尺看得到該看到的東西。
這是最有可能的一種。訊號存在,但跟已經在模型裡的特徵講同一件事。
Day 25 用 Gemini 對每個月 50 則去識別化的備註標了語氣,2013 年起共 7,760 則。這批股票月份同時有 embedding 分數,可以在同一批樣本上比兩條路。
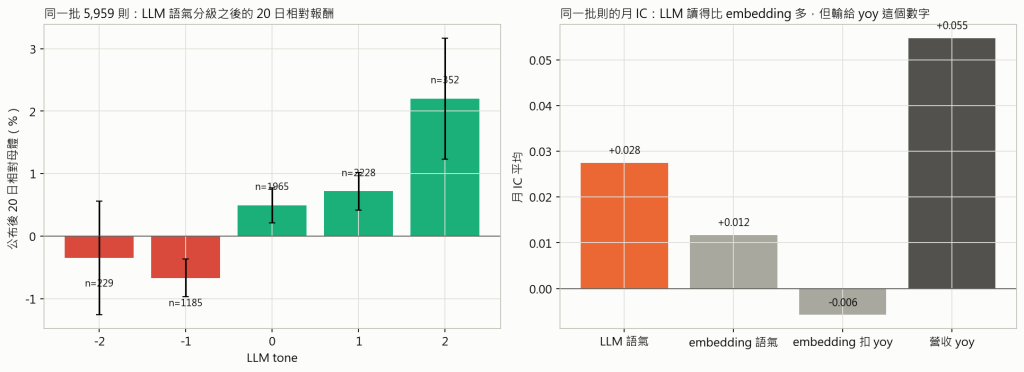
同一批 5,959 則,155 個月       月 IC 平均   ICIR    IC > 0 的月
LLM 語氣                       +0.028      0.15    57%
embedding 語氣                 +0.012      0.07    53%
營收 yoy                       +0.055      0.30    62%
LLM 讀出來的東西比 embedding 軸多一倍。分級之後的報酬除了最負面那一級以外單調遞增:−2 那組公布後 20 日相對母體 −0.35%、−1 −0.67%、0 +0.49%、+1 +0.72%、+2 +2.20%。
但控制掉營收 yoy 再算:LLM 語氣的月 IC 變成 −0.012,embedding −0.013;反過來把 LLM 語氣控制掉,yoy 還有 +0.054。語氣跟 yoy 的 Spearman,embedding 是 0.44、LLM 是 0.68。
它讀懂的那件事,就是這個月營收比去年多還是少,而那個數字在 Day 9 就進系統了。文字是數字的翻譯:公司寫「需求增加」的時候營收 yoy 就是正的;只有大變動才寫備註,那些月份的報酬行為已經被 rev 家族的特徵抓走;Day 24 還算過,出現十次以上的句子占 29%,這些句子兩條路都只能給同一個分數。
這個假零關不掉。它就是零的原因。
前面五個檢查都指向同一件事:語氣這個單一分數是 yoy 的翻譯。但語氣是我挑的題目,不是 LLM 的上限。同一段文字還可以問別的:這個月營收為什麼變?公司說會不會延續?講得具體嗎?
所以我重標了一次。2016 年起、有模型分數的月營收備註共 24,431 則,全部丟給 Gemini,每則標五個欄位:主因(新客戶/既有需求/產能/價格匯率/一次性/沒說明)、會不會延續、展望、具體度、語氣。有效率 99.9%。
第一次做這件事的時候,我只標了 Day 25 那批每月 50 則、共 8,196 則,結果是 26 次檢定裡沒有一個在兩個期間都站得住,看起來又是零。那批樣本的可偵測下限是 0.037,比真實效果還大,等於拿公分尺量公釐。最清楚的例子是「主因新客戶」的 60 日 IC:小樣本估到 +0.009,標準誤 0.028;全量估到 −0.038,標準誤 0.008。兩個估計值差 1.7 個標準誤,完全相容,小樣本那次只是連正負號都沒定下來。樣本補到三倍之後,答案才看得出來:
控制 48 特徵模型分數與營收 yoy 之後的月 IC(24,408 則、125 個月)
                       20 日      60 日     120 日
語氣                  +0.011    +0.017    +0.021(t 2.43)
主因是新客戶或新產品   −0.021    −0.038    −0.049(t −6.87)
主因是價格或匯率      +0.022    +0.032    +0.023(t  2.13)
沒有說明原因          +0.012    +0.027    +0.045(t  6.80)
26 次檢定裡,設計期 t 超過 2 的 8 個,確認期同號的 6 個,同號又顯著的 2 個,都是「新客戶」那一家族。方向合理:新客戶帶來的營收最不容易延續,而市場當下給了它溢價;反過來,說不出原因的那些反而後面比較好。
所以 Day 26 原本的結論要修一半:**embedding 的語氣軸是零,LLM 的結構化標註不是零。**差別在 LLM 能區分「為什麼成長」,一個語氣分數做不到。
有增量 IC 之後,下一個問題是能不能接到組合層。規則照 Day 20 的:30 個位子、全體排名掉出前 20 就賣、只買排名 ≤ 20 的建議、風險平價、不擇時。做六種接法,全部設計期 2016 到 2021 年 5 月、確認期 2021 年 6 月到 2026 年分開看。
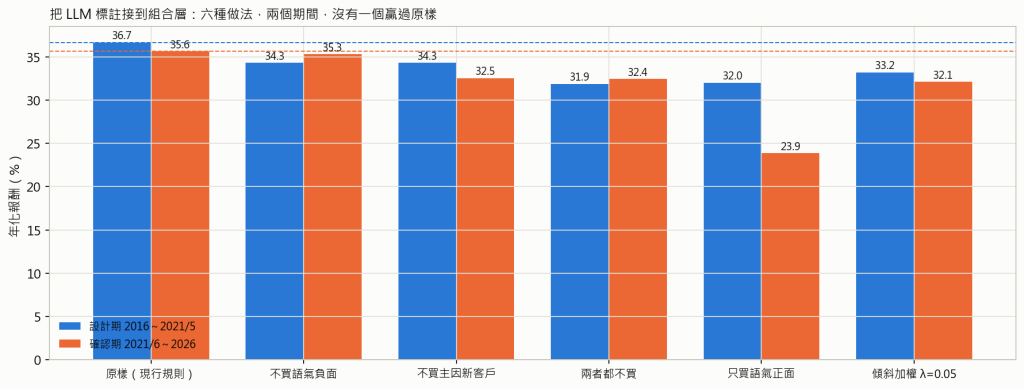
                  設計期年化   確認期年化
原樣(現行規則)    36.7%       35.6%
不買語氣負面        34.3%       35.3%
不買主因新客戶      34.3%       32.5%
兩者都不買          31.9%       32.4%
只買語氣正面        32.0%       23.9%
傾斜加權 λ=0.05     33.2%       32.1%
沒有一個贏。這裡有個技術細節值得講:第一版我是把被排除的股票 prob 壓到最低,結果連帶把其他股票的排名往前推,出場規則跟著變,比較就不乾淨了。改成只擋新買、不動排名之後重跑,結論一樣。
為什麼會這樣?
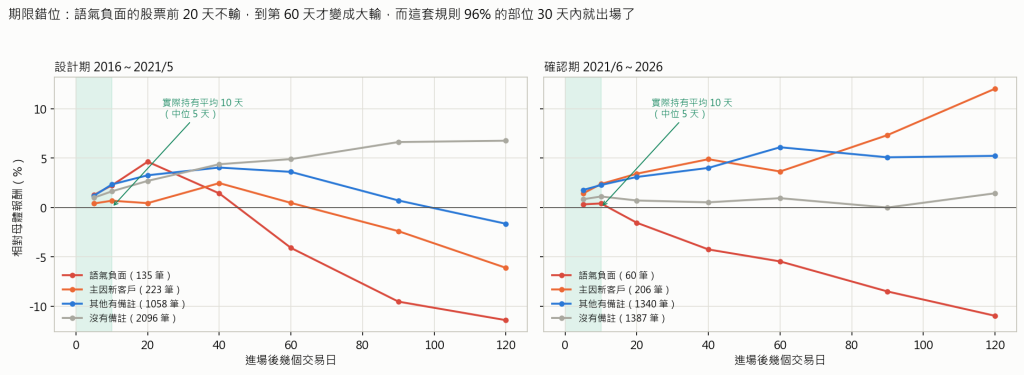
把全量標註貼回「排名 ≤ 20 且是建議」的那 6,505 筆候選,看進場後各天數的相對母體報酬。語氣負面那組在前 20 天完全不輸,設計期第 20 天是 +4.6%,要到第 60 天才變成 −4.1%,第 120 天 −11.4%。確認期形狀一樣,前 10 天 +0.4%,第 60 天 −5.5%,第 120 天 −11.0%。
而這套規則實際平均只持有 10 天,中位數 5 天,96% 的部位在 30 天內就因為排名掉出而賣掉。訊號在第 60 天才發作,那時股票早就不在手上了。擋掉這些股票,等於在它們表現最好的那 20 天把它們讓給別人。
主因是新客戶那一組更明顯:全體備註上兩個期間都是負的,但在排名前 20 的候選裡,設計期 120 日 −6.1%、確認期 +12.0%,方向都反了。在模型已經挑過一輪的池子裡,這個訊號不成立。
**「零」要有定義才算數。**這把尺 322 週、標準誤 0.0003,80% 功率的可偵測下限是 0.0009。文字特徵量到 0.0004,所以它是零,意思是小於 0.001;對照 21 個新特徵的 0.0054,同一把尺一量就跳出來。
**五個假零關掉四個,剩下的那個是答案。**特徵有訊號、模型讀得到、只看有備註的股票也一樣、尺夠細;關不掉的是重複:語氣跟營收 yoy 的 Spearman 0.44 到 0.68,控制之後歸零。文字是數字的翻譯。
**問錯問題也會製造假零。**把題目從「語氣幾分」換成「為什麼成長」,樣本從 8,196 則補到 24,408 則,控制模型與 yoy 之後,「主因是新客戶」的 60 日 IC −0.038,兩個期間都站得住。小樣本測不出來是功率問題,不是它不存在。
**有增量,不等於能用。**六種接法在兩個期間全輸。原因是期限:訊號在第 60 到 120 天發作,而這套規則平均持有 10 天。要用它,得換一個持有 60 天以上的沙拉盤,那是另一個系統,不是在現在這套上面加一層。


 iThome鐵人賽
 看影片追技術