
Day 1 的問題只有一句:今天收盤了,明天開盤要不要買某一檔股票。三十天後,這個問題每天 18:40 有一份答案,長這樣:
2026-09-21 收盤 → 9/23 開盤買(本金 100 萬,週二收盤重算後才是正式單)
排名  代號   名稱    收盤     不追上限   金額     機率 0.20~0.25 這一格的歷史:進前 5% 15.8%、漲逾 20% 19.1%、跌逾 15% 18.4%
 1    2221   大甲    140.0    147.0     30,000
 3    6218   豪勉    67.7     71.1      38,000
 5    6168   宏齊    42.7     44.8      37,000
 ...  共 10 檔,合計 326,000 元(33%),零股
出場:每週二收盤,全體排名掉出前 20 → 週三開盤賣;持有滿 60 日賣;不停損、不停利
這篇講三件事:這份答案是怎麼被產出來的、三十天裡每一個方向量到了什麼、還有我不信它的地方。
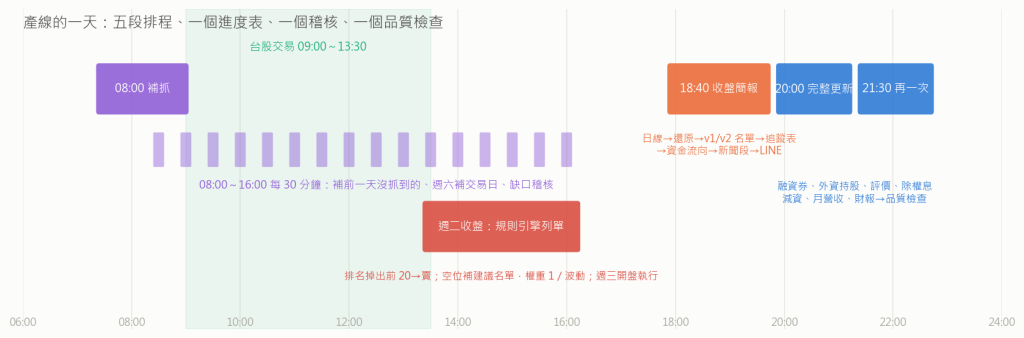
08:00 與每 30 分鐘(8~16 點)  補跑:前一天沒抓到的資料、週六補交易日、缺口稽核
18:40(平日)                  收盤簡報:日線、指數、法人、美股 → 還原股價 → v1 與 v2 名單 → 追蹤表 → 資金流向 → 新聞段 → LINE
20:00、21:30                  完整更新:融資融券、外資持股、評價、除權息、減資、面額變更、月營收、財報 → 品質檢查
每週二收盤                    規則引擎列單:持股排名掉出前 20 → 賣;空位補排名 ≤ 20 的建議名單,權重 1/波動,週三開盤執行
三個部分保證它不會默默壞掉。進度表:每個來源每一天記 done/empty/failed,資料落地之後才記,重跑冪等。稽核:以上市日線為交易日基準,比對其他來源有沒有缺天,缺了寫進補抓計畫。品質檢查:每輪結束印失敗數與一致性缺口,非零就在 log 最前面標紅。
兩條名單並行。v1 是正式的,48 個特徵加大盤狀態;v2 多 21 個新特徵,Day 29 量到年化多 2.5 個百分點,但它從 9/16 才開始留紀錄,追蹤表兩邊都記,滿十份、命中率不輸再換正式。改產線的規矩是不覆蓋,另外寫一支並行跑,因為正式名單是實際在用的,任何沒比較過的改動都會讓紙上帳斷掉。
三十天裡這條線抓到自己三次錯:Day 13 之前的普通股分割沒還原(世紀鋼 1 拆 20 變成 −95%)、日線少了 23 個週六補交易日(爬蟲只產生週一到週五)、收盤前太早抓到的「沒有資料」被存進快取讓那天永遠變成空的。三個都是列交易明細的時候看出來的,不是檢查程式抓的。明細比檢查程式誠實。
上一節說「三個部分保證它不會默默壞掉」。9/21 收盤後它壞了,而且不是默默,是連續八次。
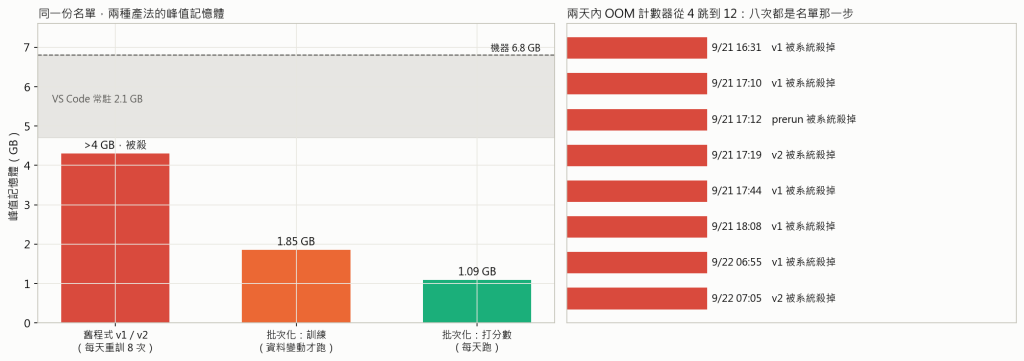
收盤後照常抓資料、跑名單,名單那一步被系統殺掉。重跑,又被殺。從 9/21 16:31 到 9/22 07:05,v1 死了五次、v2 死了兩次、盤前篩選死了一次,OOM 計數器從 4 跳到 12。資料本身一筆都沒少,卡住的只有「用模型替今天打分數」這一步。
**死因有三層。**最外層是機器:6.8 GB,VS Code 常駐吃掉 2.1 GB,剩 4 GB 出頭。中間層是我:同一時間排了兩支選股程式,第二支起來的時候第一支還在跑,兩支各要 3 到 4 GB。最裡層才是程式:它每天做三件根本不需要每天做的事。
每天做的事                                  其實需要的頻率
走動式訓練 7 個年度模型、印留出期成績        訓練資料是 9/6 建的靜態快取,答案每天一樣:一次
用全部資料重訓最終模型                      同上:訓練資料沒變就不用重訓
為了拿股票名稱和收盤價,把 2004 年起 920 萬列日線全部載入   只需要當天那一天:一個分區
第三件是壓垮的那根稻草,多吃 1 到 2 GB,前幾天記憶體夠所以沒事。
**改法是把它拆成兩段,各自一個行程。**訓練那段只在訓練資料變動時跑,模型存成檔案;打分數那段每天跑,只讀最近四年的分區。外面包一層驅動器:同一把鎖讓重工作一次只跑一支,每段開跑前先等可用記憶體夠,失敗自動重試一次。
                              峰值記憶體    耗時       頻率
舊程式 v1/v2                  > 4 GB       3~5 分   每天,被殺 8 次
批次化:訓練                    1.85 GB      22 秒     訓練資料變動時
批次化:打分數                  1.09 GB      20 秒     每天
**換產線之前要證明它產的東西一樣。**拿 9/21 的名單逐檔比:批次模型配全歷史特徵,1,012 檔的機率跟舊程式差到小數第六位都是零,前 20 名順序完全相同,所以模型那段是對的。配只讀四年的特徵,前 20 名重疊 19 檔、機率平均差 0.002。差的那一點來自舊程式的一個習慣:已經下市多年的股票,月營收和評價被往前填到今天,還留在百分位的母體裡。批次版把它們拿掉了,這是比較對的行為,但它跟回測時的行為有一檔的差,寫在這裡。
Day 28 說產線有進度表、稽核、品質檢查三道保險。這次它們一道都沒響,因為資料層完全正常,壞的是計算層,而計算層沒有任何一個檢查在看記憶體。第四道保險是這次加的:驅動器每段開跑前看一次可用記憶體,跑完把 OOM 計數器寫進 log。
用途                       模型                    頻率        成本              延遲
月營收備註語氣(特徵)     bge-small-zh 本機        每月一次    0                 3 分鐘
市場情緒指數(第五家族)   Gemini 2.5 Flash         每月一次    免費額度 1 請求    30 秒
月營收備註結構化標註       Gemini 2.5 Flash         回填一次,之後每月  每 50 則 1 請求    2 分鐘
收盤簡報的新聞段           Gemini 2.5 Flash + 搜尋  每天一次    免費額度 1 請求    20 秒
探針(Day 23)             任何新模型進場前         換模型時    160 請求          10 分鐘
規矩三條:提示詞進版本控制、每次呼叫快取、回測只讀快取。Day 24 量過,換一種問法語氣只有 33% 一致,所以提示詞改一個字就是新版本。Day 23 量過,模型讀過 2025 年以前的報紙,所以歷史文字一律去識別化才給它。LLM 在這條線上不做決定、不碰價格,它只把文字變成數字,數字再過 Day 15 的尺。
全量標註那條是 Day 26 改寫時加的:24,431 則備註、548 個請求、兩個半小時,中間卡過一次要加逾時。它量到「主因是新客戶」在 60 到 120 天有訊號,但這套規則平均持有 10 天,吃不到。
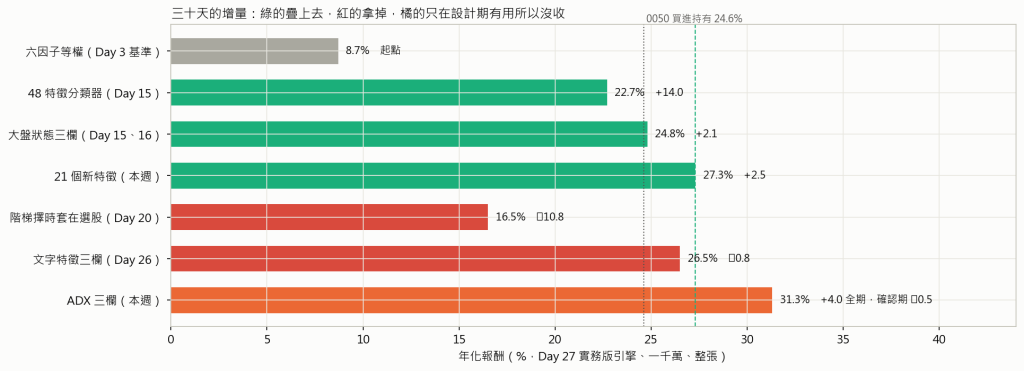
每一項都用同一把尺(走動式、每年重訓、清 4 週、留出期),沒有增量就寫沒有。
方向                                   量到的東西                                              結論
月營收特徵(Day 9、12)                rev/accel 是 48 個特徵裡重要度第二                         有
48 個特徵 + LightGBM(Day 15)         IC 0.131,等權六因子 0.098                                 有,+0.033
九模型集成(Day 15)                   0.130 對單一 LightGBM 0.131                                沒有
大盤狀態三欄(Day 15、16)             IC 0.140,+0.009;分層回測 +2.1 個百分點                    有
擇時套在 0050(Day 19~22)            報酬不加,回檔 −56% → −25%                                 有,但只有六個樣本點
擇時套在選股(Day 20、29)             年化 27.3% → 16.5%,設計期砍一半                            沒有,負的
換手緩衝(Day 21)                     成本從 1.2% 降到 0.4%,Sharpe 不變                          有
LLM 市場情緒(Day 25)                 負面比例規則 Sharpe 1.16 對 1.08,四關過                   有一點
文字特徵進選股(Day 26)               IC +0.0004,可偵測下限 0.0009                               沒有
LLM 結構化標註(Day 26)               主因新客戶 60 日 IC −0.038 兩段都過;接組合層六種全輸        有訊號,用不到
別人的 21 個特徵(Day 29)             IC 0.1314 → 0.1367;分層回測 24.8% → 27.3%,確認期加更多     有,+2.5
ADX 三欄(Day 29)                     設計期 +7.9 個百分點,確認期 −0.5                           沒有
排名出場取代固定天數(Day 29)         Sharpe 1.52 → 1.91、回檔 −39% → −24%                       有
風險平價加權(Day 29)                 設計期 +0.3 Sharpe,確認期 +0.06                            有一點
實務摩擦(Day 27)                     理想 36.2% → 100 萬零股 33.7%、1,000 萬整張 31.0%           成本 3 到 5 個百分點
停損、停利、移動停利(九種)           全部輸不設;停利 20% 把最大單筆從 +576% 剪到 +45%           沒有,負的
開高不追(三種門檻)                   門檻越嚴年化越低;開高 5~10% 那群 15 日 +8.3% 最好         沒有,負的
提高勝率的十種濾網                     勝率最多 +2 個百分點,確認期年化少 2 到 11 個百分點            沒有,用報酬換的
威科夫規則化(三種訊號)               同一模擬器年化 −4% 到 +5%,對照現行 13%                     沒有
把有的疊起來(Day 29):六因子等權年化 8.7%,加分類器 22.7%,加大盤狀態 24.8%,加新特徵 27.3%;0050 同期 24.6%。選股那一層貢獻最大,後面每層各加 2 到 3 個百分點,其他全部加不了。
三十天裡試過的方向大約四十個,過兩段驗證的六個。
最後一週我把所有「看起來會更好」的改法全部丟進同一個引擎跑:三種停損、兩種停利、兩種移動停利、進場日低點防線、三種開高門檻、放寬出場、縮短持有、雙動能濾網、機率門檻、元標籤三種、共形門檻、品質濾網、LLM 的五種接法。三十種。
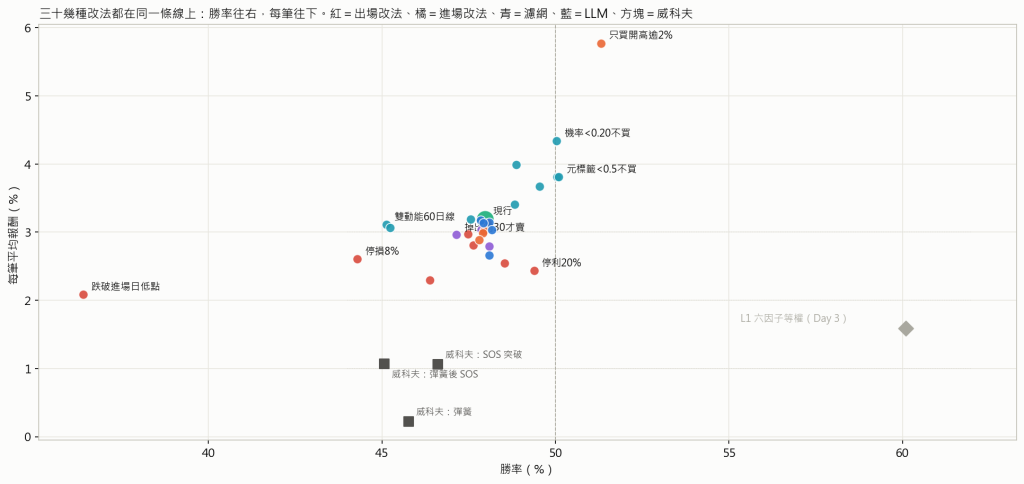
把每一種的勝率和每筆平均報酬畫在同一張圖上,它們排成一條斜線:勝率往右一格,每筆平均就往下一格。停利把勝率拉到 49%,代價是最大單筆從 +576% 變成 +45%。元標籤把勝率拉到 50%,代價是確認期年化少 8 個百分點。威科夫三種訊號在左下角,勝率 45% 到 47%、每筆 1% 以下。Day 3 的六因子在最右邊,勝率 60%、每筆 1.6%、年化 8.7%。
這條規則的體質是低勝率高賠率:48% 的勝率、中位數是負的、錢在右尾。每一種「提高勝率」的改法都是在把右尾剪掉換左邊好看。
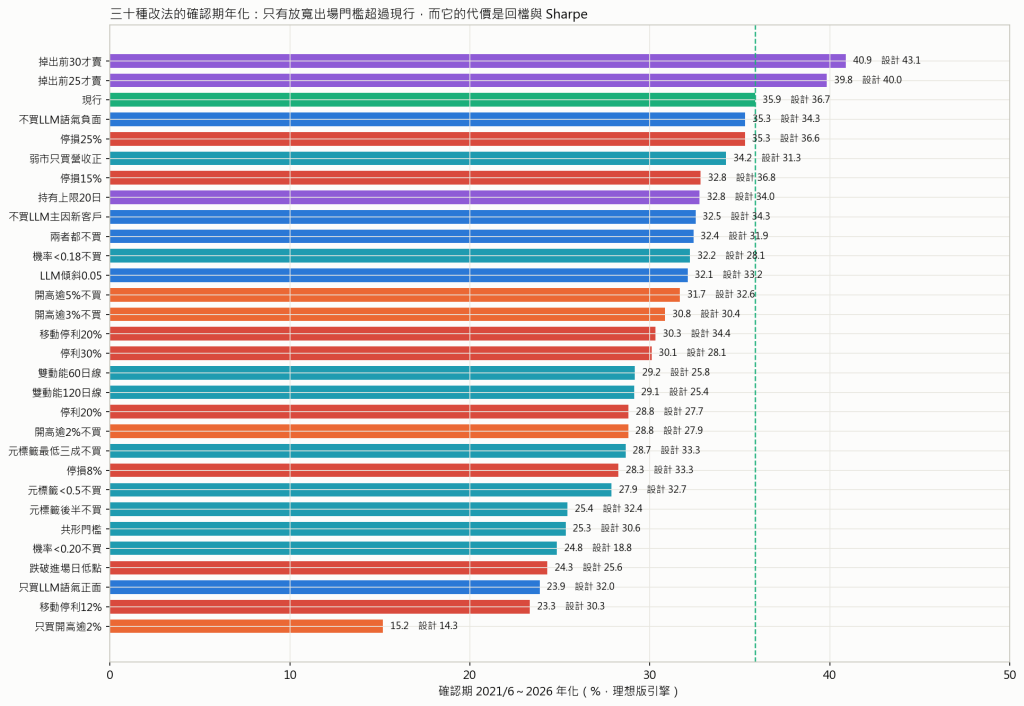
三十種裡只有一種確認期年化超過現行:把出場門檻從前 20 放寬到前 30,年化 43.1% 對 36.7%,但回檔 −27% 對 −22%、Sharpe 1.45 對 1.67。那不是改善,是換一個風險偏好。
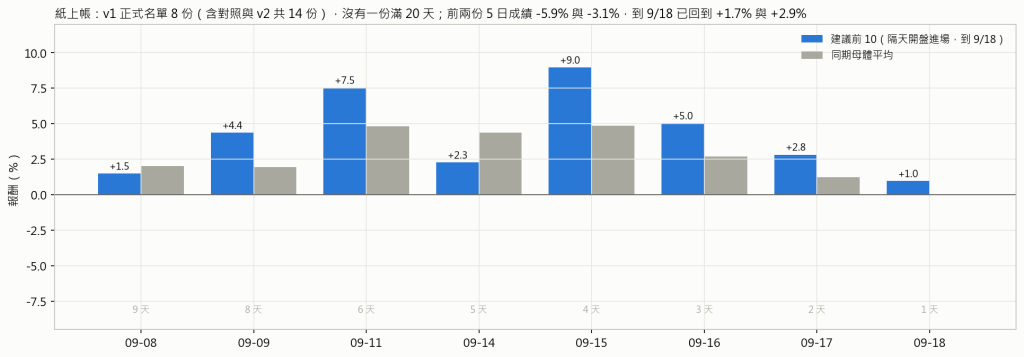
規則的交易明細有 5,178 筆,紙上帳從 9/8 開始,到 9/21 有 17 份名單(v1、對照、v2 合計),沒有一份滿 20 個交易日。前兩份 5 日成績是 −5.9% 和 −3.1%,母體同期 −1.5%;之後每一份到 9/21 都是正的,9/11 那份 +7.5%、9/15 那份 +9.0%,母體同期 +4.8% 和 +4.9%。
一份名單只有 10 檔,命中率的雜訊是 ±12 個百分點,現在任何一個數字都不能當結論。回測期望是 20 日命中 17.5%、平均 +4.9%,要累積 10 份滿 20 天的名單之後才有資格說「跟回測像不像」。
**重訓差 ±1,資料差 ±5。**同一個分類器換三個隨機種子,前 20 名的名單只有 68% 重疊,年化在 24.7% 到 26.5% 之間;但修資料前的快取跑同一條規則是 31.0%。回測數字裡有 5 個百分點是資料細節給的,個位數不該被當真。
**十年裡九年是多頭。**2016 到 2026 加權指數漲了五倍,這條規則在 2018 和 2022 是負的,其他年份都在吃多頭。2025 年它只有 +8.7% 而 0050 有 +36.9%,那種年份它看起來完全失效。它在 2008 那種年份會怎樣,資料裡沒有答案。
**擇時是六個事件。**0050 的階梯規則過了四道門,但那四道門是六個空頭年給的;刀切拿掉 2008 差就少一半。它現在給的曝險 1.0 是對的,但它沒有能力告訴你下一次崩跌前要不要減。
**容量在一千萬附近。**Day 27 量過,一百萬整張有 58% 的買單湊不到一張,三億有 68% 的買單被當日量限縮。這條線的適用區間是一百萬零股到一千萬整張,出了這個區間,數字都要重算。
**訊號的期限跟規則不一樣長。**LLM 讀出來的「新客戶」在第 60 天才發作,規則第 10 天就出場。同樣的錯位在停損上也看到:進場後第一根黑 K 平均只是震盪,防線會在最差的時間點把你洗出去。任何新訊號進來之前,先問它的期限跟規則合不合。
**機器只有 6.8 GB。**產線設計的時候沒把記憶體當成資源,直到它連死八次。批次化之後每天那段只吃 1.1 GB,但這代表這條線的每一個新東西進來之前,都要先量它吃多少。
**紙上帳兩週。**回測跟實盤之間隔著整張、滑價、我自己會不會照做。第三件這條產線量不到,這三十天我已經違反過一次:我給過一條「跌破進場日低點就出」的口頭建議,回測之後發現它砍掉 11 個百分點。規則寫在程式裡才算數,寫在對話裡的都不算。
**資料錯誤是列明細才發現的。**三個資料問題都影響了 Day 12 到 16 的數字,量級很小,但它們在那裡放了兩週沒被檢查程式抓到。下一個沒抓到的,我不知道是什麼。
**產線是五段排程、一張進度表、一個稽核、一個品質檢查,加上這週才補的記憶體閘門。**每天 18:40 出簡報和名單,每週二出進出單,資料錯了會標紅;三道保險都沒攔到的那次,是計算層在 6.8 GB 的機器上連死八次,改成訓練一次、每天只打分數之後峰值從 4 GB 以上降到 1.1 GB。
**四十個方向,六個過兩段驗證。**選股、大盤狀態、換手緩衝、排名出場、新特徵、風險平價。集成、擇時套選股、文字進選股、ADX、九種停損停利、三種開高門檻、十種濾網、威科夫,全部沒有。疊起來年化從 8.7% 到 27.3%。
**勝率是用報酬買的。**三十種改法排成一條線,勝率往右每筆往下;這條規則 48% 的勝率、中位數為負、錢在右尾,不要去改它的體質。
**LLM 只做文字變數字。**去識別化、快取、提示詞當程式碼。它在大盤層有一點,在個股層有訊號但期限對不上。
**不信的地方寫在上面。**重訓誤差 ±5、十年多頭、擇時六個樣本、容量一千萬、期限錯位、紙上帳兩週、資料錯誤靠明細才發現。這條產線我知道它哪裡不可信,這比它可信的地方更有用。


 iThome鐵人賽
 看影片追技術