
Day4 建立了兩個量子位元的貝爾態。現在,如果想改成三個、四個位元,還想選擇是否連接它們、是否翻轉最後一位,需要為每種情況各寫一份程式嗎?
我們可以把操作寫成一個接受設定的函式:傳入位元數量、角度與開關,再由同一份程式安排電路。今天會從最小的一個位元開始,逐步加入參數、迴圈與分支,讓每行程式都能對照到實際操作。
Day6 已確認工具與執行環境的分工。本章進一步區分:一般程式決定這次要執行什麼電路,量子控制閘則在電路內作用於量子狀態。 兩者看起來都有「條件」,但條件的來源與作用方式不同。
Day7 turns a fixed circuit into a reusable program with configurable qubit counts, angles, and switches. A three-qubit example shows how each loop iteration changes the state and why a Boolean branch differs from a quantum-controlled gate. Host-side validation, boundary cases, asymmetric bit strings, and a NumPy reference connect the code to verifiable results. The parameters specify experiments; no model training is performed.
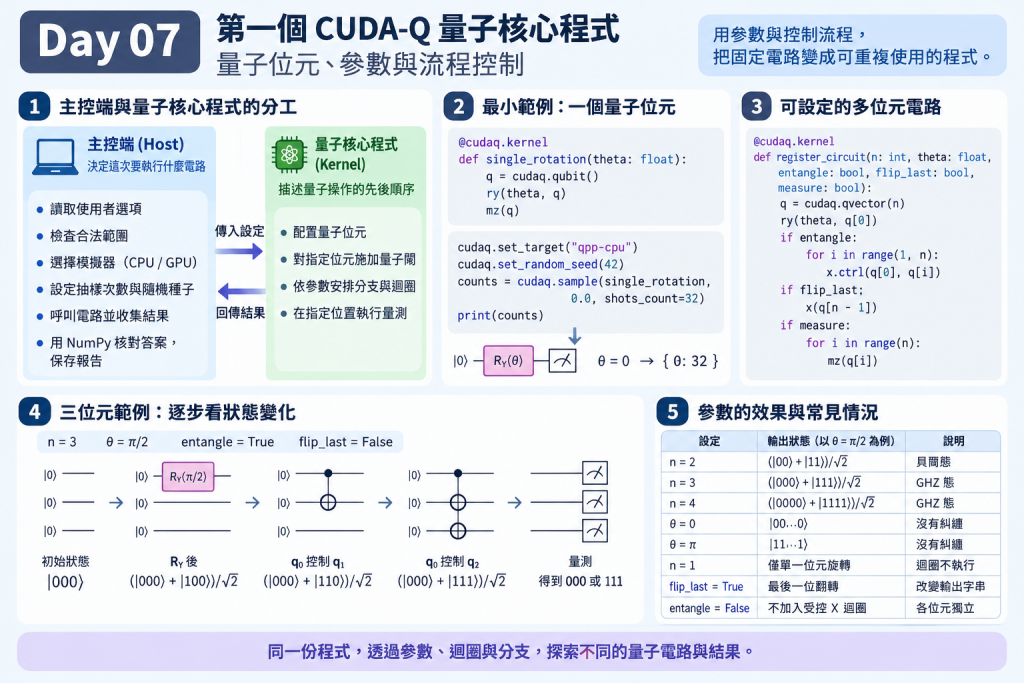
想像一次實驗有兩份清單。第一份寫「使用三個位元、角度 π/2、在 CPU 模擬、結果存檔」;第二份寫「準備位元、旋轉第一位、施加受控操作、依序量測」。
第一份由一般 Python 程式處理,稱為主控端(host)。第二份寫在 **量子核心程式(quantum kernel)**中,以 @cudaq.kernel 標記。
| 主控端負責 | 本日量子核心程式負責 |
|---|---|
| 讀取使用者選項,檢查合法範圍 | 配置這次電路使用的量子位元 |
| 選擇 CPU 或 GPU 模擬器 | 對指定的位元施加量子閘 |
| 指定抽樣次數與隨機種子 | 依傳入的設定安排分支與迴圈 |
| 呼叫電路並收集結果 | 在指定位置執行量測 |
| 用 NumPy 核對答案,保存報告 | 描述量子操作的先後順序 |
@cudaq.kernel 告訴 CUDA-Q,這個函式要交給編譯器處理,轉成後端可執行的形式。它沿用部分 Python 語法,但不能把任意 Python 套件功能、檔案讀寫或資料分析直接搬進去;可用的型別與控制流程由工具規格定義。CUDA-Q 量子核心程式規格
本章把電路放在 kernels.py,驗證與結果處理放在 experiment.py。這種分工的用處很具體:若輸入範圍不合法,在開始量子運算前就能回報;若結果不符,則能分別查電路與後處理。
以下程式可存成 Python 檔案,在專案環境執行:
import cudaq


@cudaq.kernel
def single_rotation(theta: float):
    q = cudaq.qubit()
    ry(theta, q)
    mz(q)


cudaq.set_target("qpp-cpu")
cudaq.set_random_seed(42)
counts = cudaq.sample(single_rotation, 0.0, shots_count=32)
print(counts)
先看函式內的三步。cudaq.qubit() 配置一個初始為 |0⟩ 的量子位元;ry(theta, q) 做 Day3 的 RY 旋轉;mz(q) 在區分 0、1 的 Z 基底下量測。
theta: float 表示這個設定是一個浮點數,也就是程式用來表示角度等數值的資料型別。角度以弧度表示,π 是半圈,π/2 是四分之一圈。它決定 RY 如何改變振幅。
接著看函式外:qpp-cpu 選擇一般電腦上的 CPU 模擬器,種子 42 控制抽樣的隨機序列。這一行呼叫可以分成三個角色:
cudaq.sample(single_rotation, 0.0, shots_count=32)
             要執行哪個函式   傳入θ   取得多少次量測
這裡 theta = 0,RY 不改變初始狀態,所以 32 次都應得到 0,輸出為 { 0:32 }。如果傳入 π,理想上就全部得到 1;傳入 π/2,則量到 0、1 的機率各半。
定義函式與執行函式是不同步驟。主控端可以多次呼叫同一個電路,每次傳入不同角度。角度可以調整,不代表它已經透過訓練學會某項任務。 本日設定來自我們選擇的實驗條件,沒有最佳化器更新權重。
如果需要三個位元,可以使用 cudaq.qvector(3)。若希望數量由呼叫時決定,就改成 cudaq.qvector(n)。
這一組位元也稱為量子暫存器(register)。它提供按編號操作量子位元的方式,不是一份直接保存所有振幅的 NumPy 陣列。
n = 3 時:q[0]、q[1]、q[2]
第一位:q[0]
最後一位:q[n − 1],也就是 q[2]
索引從 0 開始,q[3] 已超出三個位元的合法範圍。q[i] 代表可施加操作的量子位元,並不是讀取後得到的 0 或 1;要取得一般數值結果,需要量測。
本日主要電路有五個參數:
| 參數 | 可傳入的資料 | 它控制什麼? |
|---|---|---|
n |
整數 int |
配置幾個量子位元 |
theta |
浮點數 float |
第一個位元的 RY 角度 |
entangle |
真/假 bool |
是否加入受控 X 迴圈 |
flip_last |
真/假 bool |
是否翻轉最後一位 |
measure |
真/假 bool |
是否執行末端量測 |
布林值 bool 只有 True、False,像開啟或關閉一個選項。名稱 entangle 表示要求那組受控操作,並不是已經檢查過「輸出必定糾纏」;後面會看到反例。
以下定義與 kernels.py 的主要電路一致:
import cudaq


@cudaq.kernel
def register_circuit(n: int, theta: float, entangle: bool,
                     flip_last: bool, measure: bool):
    q = cudaq.qvector(n)
    ry(theta, q[0])
    if entangle:
        for i in range(1, n):
            x.ctrl(q[0], q[i])
    if flip_last:
        x(q[n - 1])
    if measure:
        for i in range(n):
            mz(q[i])
縮排表示哪些操作屬於哪個區塊。例如 for 縮排在 if entangle 之下,所以只有 entangle 為真時,才會執行這個迴圈。
先用這一組設定手動走一次:
n = 3
θ = π/2
entangle = True
flip_last = False
measure = True
初始是 |000⟩。RY 作用在第一位後,得到:
(|000⟩ + |100⟩)/√2
現在 range(1, 3) 會依序給出 1、2,不包含 3。把迴圈展開,就是:
i = 1:x.ctrl(q[0], q[1])
i = 2:x.ctrl(q[0], q[2])
每一步的狀態變化是:
RY 後:       (|000⟩ + |100⟩)/√2
q0 控制 q1: (|000⟩ + |110⟩)/√2
q0 控制 q2: (|000⟩ + |111⟩)/√2
每次的控制位元都還是 q0。這種以同一個位元連接其他位元的排列稱為星狀結構;如果改成 q0 控制 q1、q1 再控制 q2,才是另一種鏈狀排列。
本次 flip_last 為假,所以略過額外 X。最後的 range(3) 依序提供 0、1、2,將三個位元量測並組成結果字串。
for 在這裡是依序描述要做的操作,並不表示所有閘自動同時執行。實際電路深度與硬體上的操作安排,還要考慮共用位元與裝置限制。
前面的三位元狀態稱為 GHZ 態,名稱來自 Greenberger、Horne 與 Zeilinger。它是 Day4 貝爾態的一種多位元延伸:
| 位元數 | θ = π/2,加入受控迴圈、不翻最後一位 |
|---|---|
| 2 | (|00⟩ + |11⟩)/√2,貝爾態 |
| 3 | (|000⟩ + |111⟩)/√2,GHZ 態 |
| 4 | (|0000⟩ + |1111⟩)/√2,GHZ 態 |
一般角度則得到:
cos(θ/2)|00…0⟩ + sin(θ/2)|11…1⟩
θ 決定兩項振幅,迴圈把第一位為 1 的那一項,依序延伸到其他位元。當 n 至少為 2、兩項振幅都不為零時,這個共同純態無法寫成各位元獨立純態的乘積,具有糾纏。
但 theta = 0 時只剩全 0,theta = π 時只剩全 1,兩者都沒有糾纏。因此 entangle=True 是操作選項,不是狀態性質的保證。
還有一個重要邊界:n = 1 時,range(1, 1) 是空的,不執行任何受控 X,只留下單一 RY。如果 flip_last 為真,最後一位就是唯一的 q0,會對它再做 X。把這些情況寫清楚,能避免只在三位元示範上正常的程式,在最小輸入時失敗。
迴圈讓原始程式不用重寫,但不會讓運算成本消失。增加 n,受控閘數量由 1、2、3 持續增加,完整狀態向量的大小也隨之成長。
看起來兩者都像「符合條件就做 X」,但先問條件從哪裡來,差異就清楚了。
if entangle 使用的是主控端傳入的一般布林值。開始執行前,這個設定已是 True 或 False,表示這次是否包含整組受控操作。
x.ctrl(q[0], q[i]) 則是受控 X,也稱 CNOT。它直接作用在共同量子狀態上,對不同基底分量依規則轉換,並保留相位關係,不會先讀出 q0 的數值。
| 寫法或操作 | 條件來源 | 本章的角色 |
|---|---|---|
if entangle |
呼叫端給的真/假設定 | 決定是否加入整組操作 |
x.ctrl(q[0], q[i]) |
控制位元的量子狀態 | 對疊加中的各分量做受控轉換 |
| 先量測,再依結果分支 | 執行途中取得的 0/1 | 本日未實作的量測回饋 |
Day4 已經看過,先量測再依一般結果操作,可能失去原本保留的相干關係。因此不能把受控閘替換成「先讀 q0,再寫一個普通 if」,並假設兩者等效。
本日只測以輸入設定決定的分支;這不表示所有後端都支援任意中途量測與回饋流程。
對 n = 3、θ = π/2,我們可以在執行前列出四種選項的理想結果:
| entangle | flip_last | 可能結果,各占一半機率 | 原因 |
|---|---|---|---|
| False | False | 000、100 | 只有第一位經過 RY |
| False | True | 001、101 | 將前一列的最後一位翻轉 |
| True | False | 000、111 | 受控迴圈把 1 延伸到其他位元 |
| True | True | 001、110 | 將 GHZ 狀態的最後一位翻轉 |
例如最後一列不是 000、111 的機率變了,而是非零振幅移到 001、110。讀結果時,要同時檢查字串與次數。
沿用 Day6 的環境,在專案根目錄先執行:
source .venv/bin/activate
python -m pip check
本日沒有新增套件。新副本可先建立 .venv,再安裝 requirements-day07.txt,沿用已記錄的 CUDA-Q 0.15.1 與 NumPy 2.2.6 組合。
接著使用 demo.py 的命令列選項:
OMP_NUM_THREADS=1 python articles/day07/demo.py
OMP_NUM_THREADS=1 python articles/day07/demo.py --no-entangle
OMP_NUM_THREADS=1 python articles/day07/demo.py --flip-last
OMP_NUM_THREADS=1 python articles/day07/demo.py --no-entangle --flip-last
四個指令分別對應表格中的 True/False、False/False、True/True、False/True 組合。程式會印出後端、電路圖、計數與檢查結果,先比對理論允許的字串,再看抽樣次數。
OMP_NUM_THREADS=1 是這個命令的 CPU 執行緒設定,用來減少小型示範不必要的平行工作負擔,不是量子位元數量。
要觀察確定結果,可使用 --theta 0;未開啟最後翻轉時全部為 0,開啟後只有最後一位為 1。在可用的 GPU 環境,也可以切換後端與數量:
OMP_NUM_THREADS=1 python articles/day07/demo.py --backend nvidia --qubits 4
GPU 在這裡仍模擬量子電路,沒有使用真實量子處理器。
n: int 表示這個值用作整數,但仍需要規定哪些整數合理。n = 0 無法提供 q[0],負數也沒有本章需要的意義。
主控端的 validate 會要求位元數是 1 到 8 的整數、角度是有限數值、開關是布林值、shots 是正整數,種子則是非負的 32 位元整數。1–8 是這個教學程式的範圍,不是 CUDA-Q 的硬體或軟體上限。
這也說明型別提示與輸入檢查的不同:前者描述資料種類,後者限制這個實驗願意接受的值。Python 中 True 在某些數值操作可被當成 1,但本日位元數檢查刻意拒絕它,避免把開關誤傳成數量。
先在主控端檢查,能以清楚訊息指出錯在哪個輸入;若一路傳到電路編譯或裝置執行才出錯,通常更難回查。
GHZ 只出現 000、111,即使把左右順序反過來,字串仍然相同。所以 GHZ 分布看起來正確,不能證明 q0 放在最左邊。
把 θ 改成 π,就能得到不必抽樣猜測的對照:
| entangle | flip_last | n = 3 時的確定結果 |
|---|---|---|
| False | False | 100 |
| False | True | 101 |
| True | False | 111 |
| True | True | 110 |
100 反過來是 001,110 反過來是 011,這些非對稱情況能揭露順序錯誤。並非表內每一列單獨都能抓出錯誤,重點是整組測試包含足以區分的輸入。
本日明確依 q0、q1、q2 的順序量測,並使用 explicit_measurements=True 解讀輸出。NumPy 參考向量則固定 q0 為最左側,順序從 000、001 一直到 111,所以 100 對應索引 4。
取得 CUDA-Q 模擬狀態後,程式使用 state.amplitude(bitstring) 按 000、100 等標籤查詢振幅,而不是直接猜測底層向量的排列。標籤與計數的對照,也由這些非對稱測試核對。
measure=False 供完整模擬狀態驗證,正式抽樣則用 True。這個分支是為了分別取得兩種檢查資料,不表示硬體可以直接回傳所有振幅。
單一示範成功後,下一步是系統地改變設定,而不是只手動試幾個看起來有趣的值。本日每個後端掃描:
| 設定 | 選取值 | 數量 |
|---|---|---|
| 位元數 n | 2、3、4 | 3 |
| 角度 θ | 0、π/2、π | 3 |
| entangle | False、True | 2 |
| flip_last | False、True | 2 |
總共 3 × 3 × 2 × 2 = 36 組,每組 1,000 shots、種子 42,沒有加入雜訊。n = 1 另由單元測試覆蓋,不在這份掃描表內。
OMP_NUM_THREADS=1 python articles/day07/experiment.py --backend qpp-cpu
OMP_NUM_THREADS=1 python articles/day07/experiment.py --backend nvidia
結果寫入 results/day07/<backend>/,重跑相同後端會更新該目錄。需要另存可加 --output-dir /tmp/day07-check。
NumPy 先用 Day3 的 RY 建立第一位的狀態,再接上其餘初始為 0 的位元。受控翻轉則依位元規則把振幅移到對應位置,例如 100 移到 110,再移到 111。
這種以基底位置移動振幅的參考計算,與 CUDA-Q 的電路描述走不同實作路徑,能用來交叉核對;仍需搭配已知端點與非對稱案例,避免兩邊共享相同誤解。
每組檢查分成幾種不同責任:
| 證據 | 檢查內容 |
|---|---|
| 長度平方 | 振幅絕對值平方總和是否接近 1 |
| 保真度 | 與參考純態是否接近同一物理狀態,允許整體相位 |
| 精確機率 | 從模擬振幅計算的機率是否與參考一致 |
| 量測資料 | 位元字串是否合法,計數總和是否等於要求次數 |
| 抽樣誤差 TVD | 抽樣比例離理論分布多遠,作為描述值保存 |
保真度是兩個正規化純態向量內積的絕對值平方,1 表示相同物理狀態。TVD 則把每種結果的抽樣與理論機率差取絕對值,加總後除以 2。前者關心狀態,後者關心有限次抽樣分布,不能互相替代。
本程式沒有把 TVD 的某個固定門檻列為通過條件。它主要以完整模擬狀態驗證電路,再另存抽樣波動;同一個種子在各設定重用,也不是多種子的獨立統計比較。
kernel_sweep.csv 逐筆保存參數、計數、檢查與時間;其中 counts、checks 是 JSON 格式的文字,可用 json.loads 還原成欄位資料。summary.json 保存環境、後端精度與最大誤差,circuit.txt 則保存三位元預設電路的文字圖。
CSV 的 norm 實際是向量長度平方;數值接近 1 表示正規化條件成立。passed 表示本組列出的檢查全部通過,仍要搭配檢查範圍閱讀。
2026-09-06 保存的結果如下,完整資料見 Day7 結果紀錄:
| 後端 | 組數 | 檢查結果 | 精度 | 最大保真度誤差 | 最大抽樣 TVD |
|---|---|---|---|---|---|
| CUDA-Q CPU | 36 | 全數通過 | fp64 | 0 | 約 0.007 |
| CUDA-Q GPU | 36 | 全數通過 | fp32 | 約 3.42 × 10⁻⁸ | 約 0.007 |
fp64、fp32 表示不同浮點數精度;複數的實部與虛部使用對應精度保存。較小的數值差可能來自有限精度,因此本日正規化、保真度與機率比較使用絕對容差 1e-5。這個表格證明的是指定設定下的數值核對,不是精度或速度的公平效能比較。
2026-09-11 本次改寫時,CPU 的 36 組實驗已重新執行並全數通過,以下 6 項既有測試也通過。GPU 數字沿用歷史保存資料,本次未重跑 GPU。
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day07 -p 'test_*.py' -v
在可用的 GPU 環境可對同一組測試明確選擇目標:
OMP_NUM_THREADS=1 DAY07_TARGET=nvidia python -m unittest discover -s articles/day07 -p 'test_*.py' -v
測試涵蓋單位元端點、參考狀態、包含 n = 1 的迴圈邊界、分支與位元順序、種子重現,以及非法輸入。各個案例都對應前面解釋過的一項風險,而不是只重複查看 GHZ 圖形。
本章已讓同一份電路接受不同設定,但沒有根據資料答案調整參數,因此還不是訓練。保存時間也包含編譯與初始化,不能由這些短小測試宣稱 GPU 加速。
後續設計模型時,可以沿用今天的方法:先說明每個參數改變哪一段操作,再選能看出差異的輸入,最後檢查狀態與讀取結果。這讓「程式可以調整」進一步成為「調整造成的效果可以解釋與驗證」。
原始查閱日期:2026-09-06;本次於 2026-09-11 重新核對量子核心程式規格。實際驗證使用 CUDA-Q 0.15.1;最新文件與固定版本的行為以測試交叉核對。共用索引見 REFERENCES.md。
Day 08 將用相同狀態準備比較 sample、run、observe,釐清量測計數、單次一般回傳值與期望值的差別;期望值是依各結果的機率計算出的平均值。
[N4] Xin Zhan et al. “A Full Stack Framework for High Performance Quantum-Classical Computing.” CUG 2025 proceedings (2025);會議論文。原始來源;完整書目。
Tip: 本章將量子操作寫成可呼叫的程式;這篇研究可延伸理解量子 kernel 如何接入傳統程式的編譯與執行流程。


你用 100/001 這種非對稱結果抓位元順序,比只看 000/111 的 GHZ 更有驗收力;對稱案例真的很會把錯誤藏起來。後續會考慮把這類案例做成 property-based test,自動產生不同 n 與開關組合嗎?

謝謝提醒,先讓我記錄一下!這個方向我也覺得很值得補上,等這個系列文章告一段落後,我會再整理成延伸內容。
其實這個系列本身就是一個偏「驗證型」的工程專案。最初規劃它,一方面是希望替未來的研究工作累積技術基礎,另一方面也是作為博士申請與後續研究能力的技術儲備。
目前我會先按照原先規劃的內容持續釋出;像 property-based testing、自動產生不同 n 值與開關組合,以及更多邊界與非對稱測試案例,會考慮在系列後半段或完結後再補充進去。
Thanks for pointing this out — I’m definitely taking note of it! I think this would be a valuable extension, and I plan to revisit it after the main article series is completed.
This series is essentially a validation-oriented engineering project. I originally started it both as technical groundwork for my future research and as part of my preparation for PhD applications and longer-term research work.
For now, I’ll continue releasing the content according to the original roadmap. Ideas such as property-based testing, automatically generating different values of n and switch combinations, and adding more asymmetric and edge-case tests are things I’d like to explore later in the series or as follow-up material.
專案目前放在 GitHub Project:
https://github.com/kancheng/qml-engineering-30-days

 iThome鐵人賽
 看影片追技術