
同一個任務,worker 說完成,我說沒完成。兩邊都講得出理由,但只有一邊留得下「照這個步驟查、會看到這個結果」的紀錄。
Day 6 的結論是 AI 自述不能當證據,規則也寫得很直接:「agent 回報後主控必須核對(SQL / 抽樣),不得直接採信」(出自 CLAUDE.md)。但那是一句否定句,它擋掉錯誤答案,沒給出正確答案。不採信自述,那要採信什麼?
我原本以為問題出在寫得不夠詳細,於是要求回報要「說明驗證方式」。收到的是這種東西:「已檢查相關欄位,確認回傳結構完整,前端渲染無誤。」
字變多了,可核對性是零。我要確認這句話,得先反推「相關欄位」是哪些、「前端渲染」打的是哪個頁面——反推比我自己從頭驗一次還貴。
真正讓我改掉的是那次 dashboard 崩潰。我沒讀 worker 的說明,直接打 dashboard 提供成本快照的那支 API,看回傳的 summary 有沒有那幾個數字。崩潰時那個 JSON 就是缺欄位;修好之後才看到 main 2920.43 / manager 1426.46 / worker 1239.34 / cost 5586.24(出自 2026-09-14 11:49 的『成本頁崩潰與修復』筆記)。
差別在於,「打哪支 API、檢查哪幾個欄位、看到什麼數字」是一組留得下來的步驟與結果:當時的我、事後的我、或任何能碰到這套服務的人,都能照著核對。它不保證換個時間重打會得到相同金額;要核對事故當時的數值,靠的是當時留下的紀錄。相較之下,只有「前端渲染無誤」而沒有頁面、步驟與結果,無法讓別人照著核對。
問題於是被重新定義:不是「AI 講的話可不可信」,而是這句話有沒有留下發言者以外的人也能核對的步驟與結果。驗收須留下可核對的步驟與結果;留不下的都只是說法——包括我自己講的。
回頭盤點,可核對的剛好四類,各自回答不同問題。
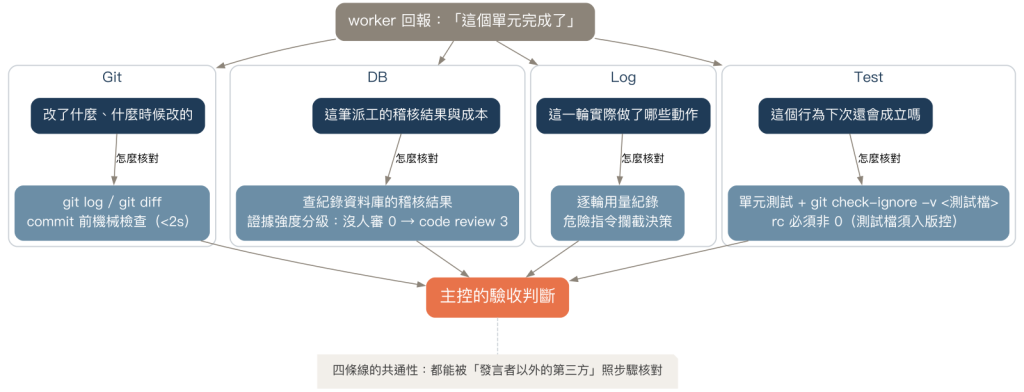
四種證據各回答一個問題,也各有一條核對途徑,最後匯聚成同一個判斷。共通性只有一個:都不需要相信發言者。
Git 回答「改了什麼」。 保留版本變更順序的證據,diff 攤開就是事實。commit 前我不手拼檢查指令,一律走一支自製的 commit 前機械檢查工具,它的設計目標寫在註解裡:「把所有可機械化的檢查壓成『一次 Bash call、固定格式、<2s』」。固定格式比快更重要——格式固定我才能直接比對。
DB 回答「這筆派工後來怎麼了」。 我把派工驗收、成本、危險指令攔截決策與逐輪用量存入紀錄資料庫,讓「這筆任務最後怎麼了」可以事後查詢(這個資料庫未公開,以下查詢讀者無法重跑)。好處是可以事後反問:標記完成的單元裡,有幾筆其實沒人 review 過?
這題答得出來,因為寫入稽核紀錄的程式把「證據強度」本身也寫進了資料庫。每筆結果都標上來源,來源有優先序:沒人審過=0 < worker 自己的回報=1 < 人工、機械檢查或測試=2 < 正式 code review=3。前一天那種「打一支 API、檢查回傳欄位」的做法,歸在強度 2 的機械檢查裡。「worker 自己說過了」不是沒記錄,只是被標成強度 1。這個排序是我自己稽核用的強度序,不代表 code review 一定比實際跑過測試更能證明某個頁面可用——每一級仍要對到它想驗的那個命題。不分級的話,所有「完成」看起來都一樣。
Log 回答「實際做了哪些動作」。 逐輪用量紀錄落每一輪的原始記錄,危險指令攔截 hook 落每一次攔截決策。懷疑某輪出問題時,我不是去問當時那個 agent 記不記得,是去翻記錄。
Test 回答「下次還會不會成立」。 前三種都是回顧,只有測試往前。這裡有一條我覺得最好用的規則:測試檔必須進版控。我用來排未完成項目的那份協定寫死了做法——跑 git check-ignore -v <測試檔>,rc 必須非 0(代表它沒被忽略規則命中),而且測試檔本身要已經進了提交;一旦命中,該筆視同自驗未過,還原並標成待補測試,原因記為「測試檔被 gitignore」。
因為「我寫了測試」和「別人 clone 下來跑得到」是兩件事。測試檔躺在 gitignore 底下,這個保證就只存在於當事人的硬碟裡。同一份協定還補了一刀:本質無法自動測的項目一樣標成待補測試,原因記為「沒有可用的測試環境」,不得以「已手動驗證」代替——手動驗過也不算,因為沒留下別人能照著跑的步驟。
回報格式跟著改了。現在要的不是敘述,是一張正規化表格:單元 / 狀態 / 觸及檔案 / 已驗證 / 待裁決,其中「已驗證」欄必須是親自跑過的指令與結果數字。
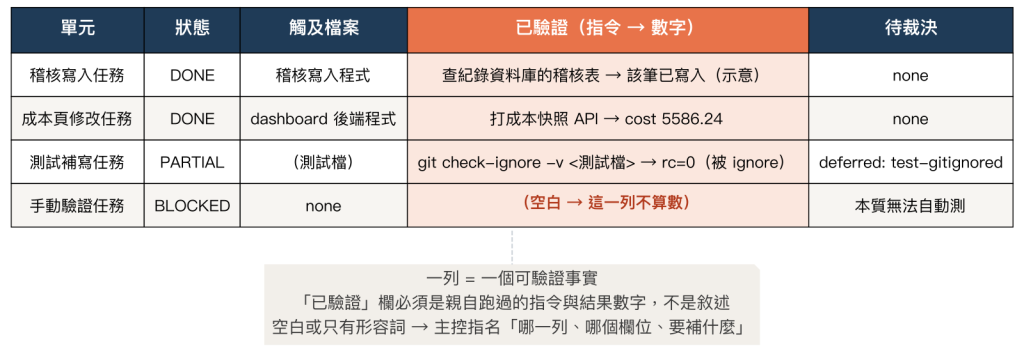
「已驗證」欄是整張表唯一有重量的地方。空白或只填「已確認正常」,這一列就不成立,不管另外四欄多完整。
這回答了開頭那個矛盾:只有填得出這一欄的,講的話可以被第三方核對。填不出來的不是被判定說謊,是被判定還沒驗——前者要追責,後者只要補跑。
格式還順手解決了另一件事:主控該讀多少。派工規則寫的是「只讀它交上來的正規化表格,不重查原始資料」,發現問題時「一次列全,指明『哪一列、哪個欄位、要補什麼』」。沒有這張表,我要嘛全信、要嘛全部重查,分工就沒意義了。有表才能抽驗:挑幾列照「已驗證」欄的指令重跑,對得上就過。
證據制度也需要停損點,否則變成無限重驗。派工層是「升階全案上限 1 次,升階後仍失敗 → 拆小單元或把改法逐條寫死重派,不得再升」;更硬的一條寫在 CLAUDE.md 的 commit 規則段——「review 3 輪未收斂或出現 [blocked] → 還原並標成待補測試,不得 commit」。退回 1 次、升階 1 次、review 3 輪各管一件事:退回是中層換人的門檻,升階是同範圍改派更貴模型的上限,review 3 輪則是單次 commit 前的收斂上限。
我的判讀是,這四種證據能放在一起用,是因為共用同一個性質:都能被發言者以外的第三方核對。這也是我要求這系列文章的素材盤點「每條都要交代出處」的同一套標準——一套制度如果不能拿來檢驗建立它的文件,那它只是願望清單。
第一幕剛好收得起來。從一個人對著聊天框問問題開始,先撞上單一 session 裝不下的容量牆;為了塞進去開始管 context;管到後來發現一個腦袋不該同時規劃和執行,於是拆分工;分工出來就得決定誰能決定什麼,於是有權責;有權責就有回報,回報帶來誤報;誤報逼出「那什麼才算數」,答案就是今天這四條線。每一步都不是設計出來的,是上一步壞掉之後被逼出來的。
但這套制度有個它管不到的地方,我是踩到才發現的。
證據制度回答「這件事做對了沒有」,它預設了一件事:這個動作本來就該被執行。rm -rf 執行成功、log 有記錄、diff 乾淨、測試全綠——從證據鏈看這是一筆挑不出毛病的紀錄,四條線通通對得上。問題是那個目錄本來就不該被刪。
證據管事後可查,管不了事前該不該。用驗收制度去補權限補不起來——等你拿得出證據,事情已經發生完了。所以明天談的是在動作發生之前就攔下來的那一層:權限、危險指令攔截、hooks。
那是第二幕的開場。
明日預告:Day 8|危險指令攔截與 hooks 為什麼會出現


 iThome鐵人賽
 看影片追技術